41. Herdr 实战:从零搭建 AI 一人公司,用 Claude Code、Codex 组建 AI 员工团队
用 Herdr 从空文件夹搭一家 AI 一人公司:建知识库、装 Herdr、四位 AI 员工上岗、新建岗位、第一项任务。五段完整提示词逐段讲透,附手机连回和多台电脑两段补充。
用 Herdr 从空文件夹搭一家 AI 一人公司:建知识库、装 Herdr、四位 AI 员工上岗、新建岗位、第一项任务。五段完整提示词逐段讲透,附手机连回和多台电脑两段补充。

Hermes Agent 语音模式支持三种交互表面:CLI 按键录音、Telegram 语音气泡、Discord 语音频道实时对话。本文覆盖 10 种 TTS 与 6 种 STT 提供商对比、零成本方案(faster-whisper + Edge TTS)、26 短语幻觉过滤器、四档 config.yaml 配置模板。
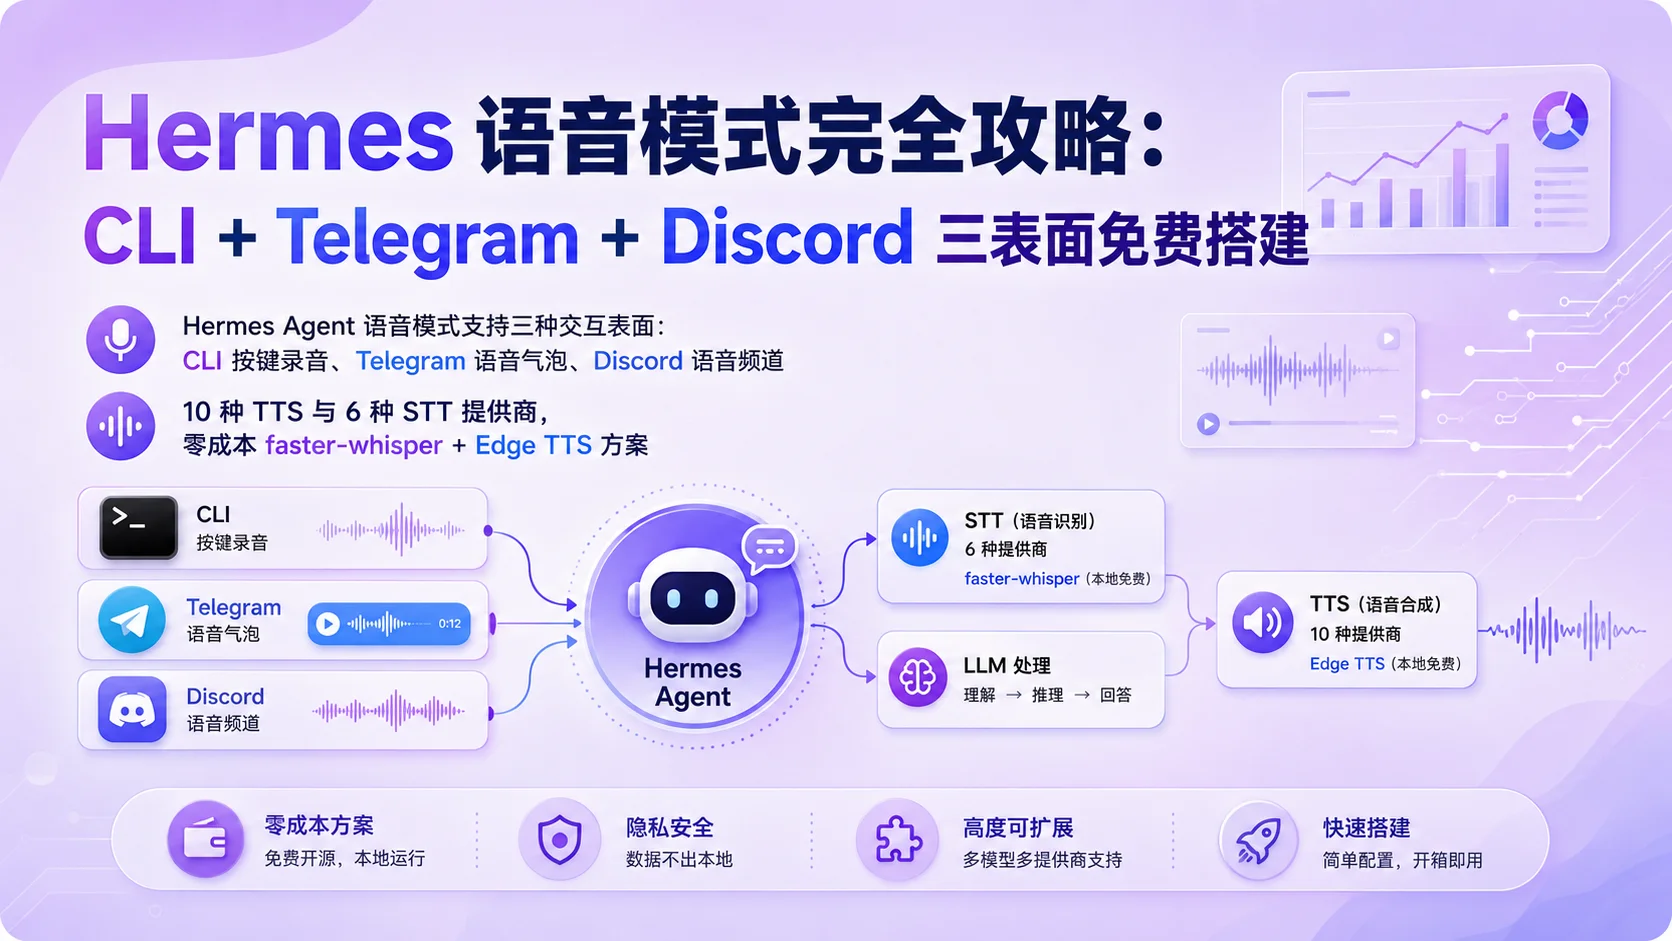
Hermes Agent 不是只能打字的 Agent。它的语音模式覆盖三种交互表面——CLI 终端按键录音、Telegram 语音气泡、Discord 语音频道实时对话。搭配 10 种文字转语音(TTS)和 6 种语音转文字(STT)提供商,零成本方案只需 faster-whisper + Edge TTS,连 API 密钥都不用申请。
一句话对比三个表面:CLI 适合编码时免提调试(按 Ctrl+B 录音,本地延迟最低),Telegram 适合移动端随时随地(语音气泡收发,按住按钮说话就行),Discord 语音频道适合团队实时讨论(Bot 坐在频道里持续监听,多人独立流处理)。
如果你还没安装 Hermes,先看 Hermes Agent 完全指南;如果你对跨平台消息桥接感兴趣,配合阅读 跨平台消息。本文专注语音这一个维度,把三个表面、全部提供商、幻觉过滤、完整配置讲透。
语音模式建立在 Hermes 的完整 Agent 流水线之上——语音只是入口和出口,中间的工具调用、记忆、技能系统跟文字模式完全一样。所以第一步永远是确保文字模式正常工作。
需要安装的东西分两层:
Python 包依赖:
提示词:安装 Hermes 语音依赖
请帮我安装 Hermes Agent 的语音相关 Python 包。要求:
voice(CLI 麦克风+音频播放)、messaging(Discord+Telegram 消息平台)、all(全部一次装,推荐)pipx install "hermes-agent[范围名]"all 一步到位| Extra 名称 | 安装的包 | 用途 |
|---|---|---|
voice |
sounddevice, numpy |
CLI 麦克风录音和音频播放 |
messaging |
discord.py[voice], python-telegram-bot, aiohttp |
Discord 和 Telegram Bot |
tts-premium |
elevenlabs |
ElevenLabs 高级 TTS |
系统依赖:
# macOS
brew install portaudio ffmpeg opus espeak-ng

# Ubuntu/Debian
sudo apt install portaudio19-dev ffmpeg libopus0 espeak-ng
| 依赖 | 用途 | 必需场景 |
|---|---|---|
| PortAudio | 麦克风输入和音频播放 | CLI 语音模式 |
| ffmpeg | 音频格式转换(MP3→Opus、PCM→WAV) | 全平台 |
| Opus | Discord 语音编解码器 | Discord 语音频道 |
| espeak-ng | 音素化后端 | 本地 NeuTTS |
安装完成后运行 hermes doctor,确认输出中 tts ✓ 和 discord ✓ 都是绿的。
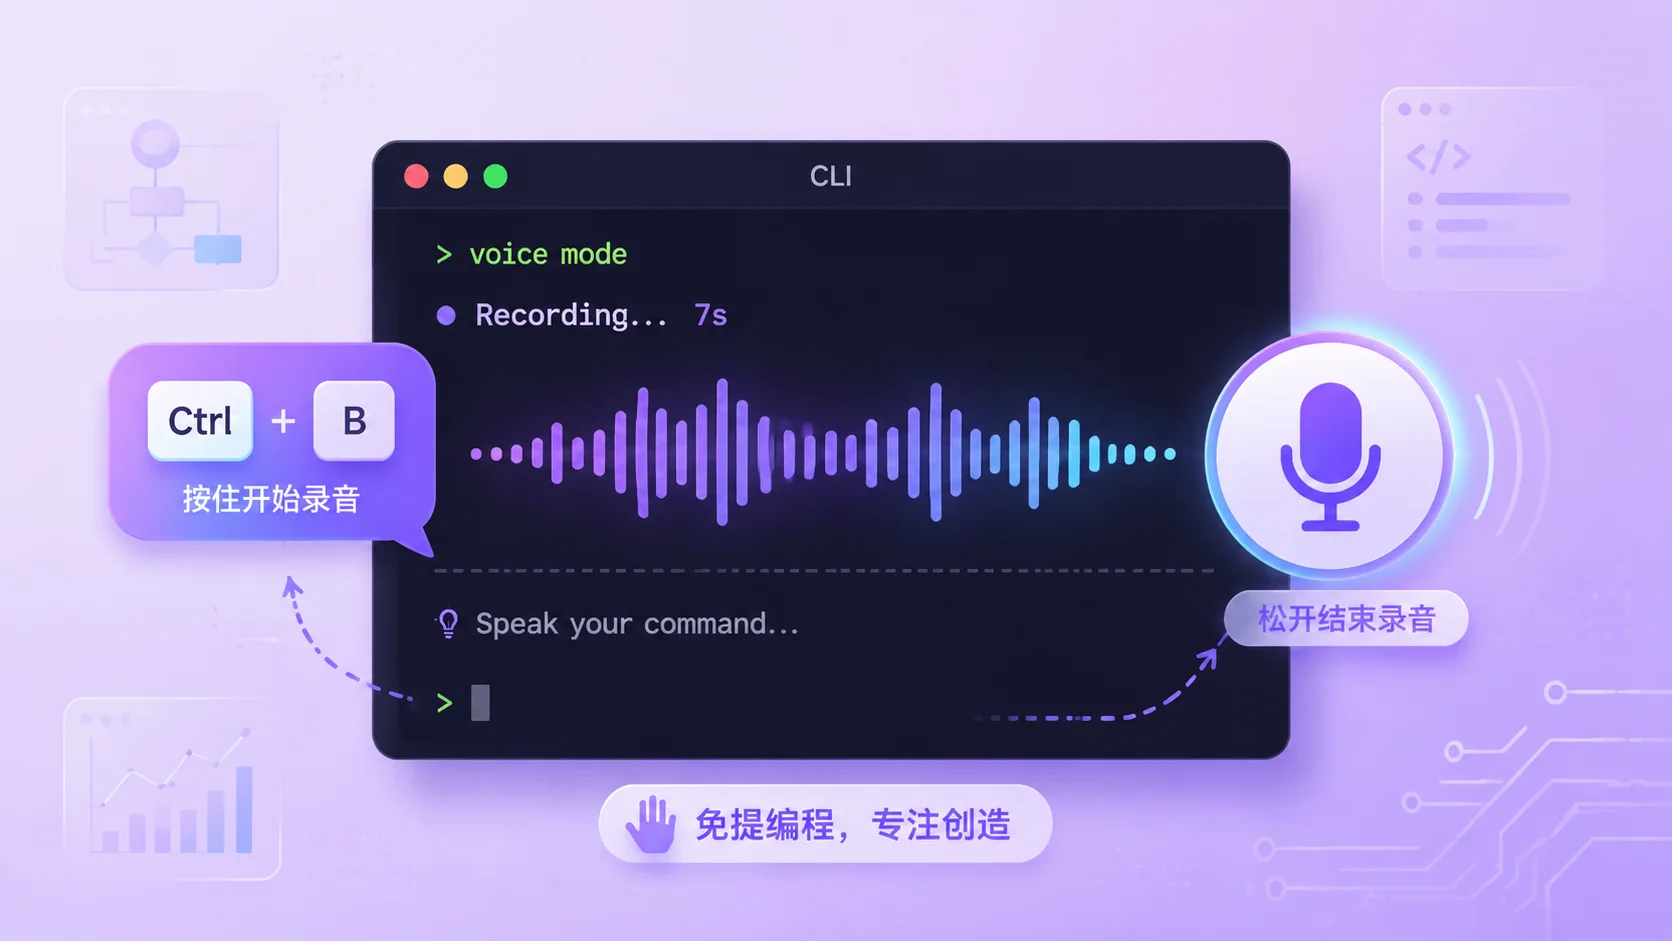
CLI 语音模式在经典终端(hermes chat)和 TUI(hermes --tui)中均可用,行为完全一致。
hermes # 启动交互式 CLI
进入后可用的语音命令:
/voice          切换语音模式开/关
/voice on       启用语音模式
/voice off      关闭语音模式
/voice tts      切换 TTS 输出
/voice status   显示当前状态
整个录音循环是这样的:
/voice on 启用语音模式● [▁▂▃▅▇▇▅▂] ❯循环持续运行,直到手动按 Ctrl+B 退出或连续 3 次录音都未检测到语音。
💡 通俗讲:按一下 Ctrl+B 进入语音循环后,你只管说话,说完了 Agent 自动回答,回答完了自动等你下一句。整个过程双手不碰键盘。
Hermes 用两阶段算法判断你是否说完了:
如果完全没检测到语音,15 秒后自动停止录音,避免静默挂起。
两个关键参数都可以在 config.yaml 中调整:
silence_threshold:值越高越不敏感,噪声环境建议调到 300-400silence_duration:说话节奏慢的人可以加长到 4.0 秒录音快捷键也可以改。如果 Ctrl+B 跟 tmux 冲突,设置 voice.record_key: "ctrl+space"。
启用 TTS 后,Agent 的回复是逐句朗读的,不用等完整回复生成完毕:
<think> 推理块这意味着 Agent 开始思考后几秒钟你就能听到第一句话,而不是等 30 秒看完整文字再听。
免提编程调试——散步时想到一个 Bug,对着终端说"Docker 容器启动报权限错误,帮我调试",Agent 自动执行 docker logs、分析错误、给出修复方案。你可以继续语音追问:"再读一遍最后那个错误"、"用更简单的话解释根因"、"现在给我修复命令"。整个过程双手不碰键盘。
研究和头脑风暴——口述半成型的想法,让 Hermes 实时组织你的思路。适合走路时思考、不方便打字时快速捕捉灵感。
无障碍场景——打字不便时(手腕不适、站着操作、视力原因),语音模式是保持完整 Agent 交互循环的最快方式之一。语音输入加上 TTS 输出,基本实现了纯听说的交互循环。
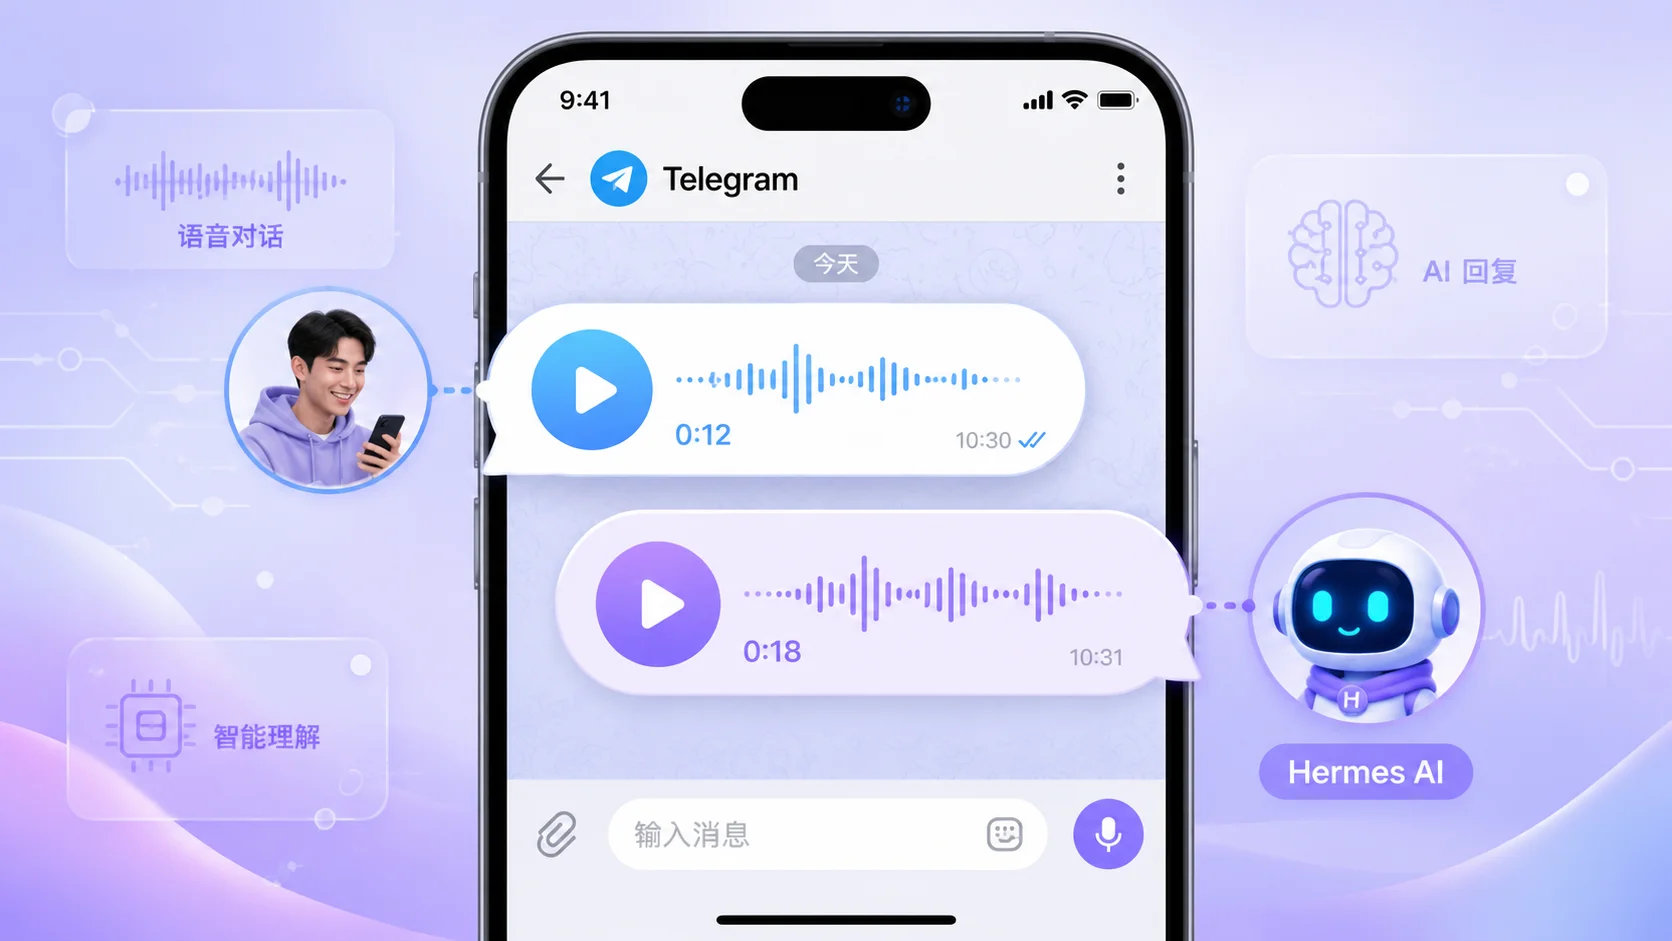
Telegram 的语音模式是 Hermes 对非技术用户最有吸引力的功能。不需要学 CLI,不需要懂模型配置,按住 Telegram 的麦克风按钮说话就行。
hermes gateway        # 启动网关,连接已配置的平台
hermes gateway setup  # 首次配置的交互式向导
在 Telegram 聊天中发送的语音命令和 CLI 一致(/voice、/voice on、/voice off、/voice tts、/voice status),区别在于 /voice on 的含义是"仅在收到语音消息时回复语音"。
| 模式 | 命令 | 行为 |
|---|---|---|
off |
/voice off |
纯文字(默认) |
voice_only |
/voice on |
仅在用户发语音时回复语音 |
all |
/voice tts |
每条消息都回复语音 |
voice_only 模式最自然——你发语音它回语音,你打字它回文字,自动匹配沟通风格。
语音模式设置在网关重启后持久保留,不需要每次重新配置。
Telegram 语音气泡要求 Opus/OGG 格式。不同 TTS 提供商的原生输出格式不同,决定了是否需要 ffmpeg 转换:
| TTS 提供商 | 原生格式 | 原生 Opus | 需要 ffmpeg |
|---|---|---|---|
| OpenAI TTS | Opus | 是 | 否 |
| ElevenLabs | Opus | 是 | 否 |
| Mistral Voxtral | Opus | 是 | 否 |
| Edge TTS | MP3 | 否 | 是 |
| MiniMax TTS | MP3 | 否 | 是 |
| xAI TTS | MP3 | 否 | 是 |
| Google Gemini | 原始 PCM | 否 | 是 |
| NeuTTS | WAV | 否 | 是 |
| KittenTTS | WAV | 否 | 是 |
| Piper | WAV | 否 | 是 |
没有 ffmpeg 时,音频以普通文件附件形式发送——可以播放,但显示的是矩形播放器而非圆形语音气泡。所以 brew install ffmpeg 是强烈建议的。
完全基于语音的 Telegram 交互:按住麦克风说"今天有什么日程?提醒我下午 3 点打牙医电话",松开后 Hermes 转写处理,返回语音气泡回复日程和确认。整个交互从未打开键盘。
这也是为家人、朋友搭建 Hermes Agent 时最实用的界面。他们不需要学终端命令,Telegram 上的语音是他们真正会用的入口。
使用 Telegram 语音模式时需要注意:Telegram 在其服务器上存储语音消息,Bot 下载音频用于转写,但原始语音文件留在 Telegram 云端。如果你对语音数据隐私有要求,可以选择本地 Whisper 做转写(音频只在你的机器上处理),但传输到 Telegram 服务器的部分无法控制。
最大隐私方案是:本地 Whisper 转写 + 本地 NeuTTS 合成,所有音频处理留在自己的基础设施上。但 Telegram 作为传输通道本身的数据留存无法规避。
Discord 语音频道是最沉浸式的语音功能:Bot 加入语音频道,监听用户说话,转写语音,通过完整 Agent 流水线处理,再把回复说回语音频道。
这个表面的配置比前两个复杂一些,需要在 Discord 开发者门户做额外设置。
第一步:Bot 权限
在 Discord 开发者门户中添加语音相关权限:Connect、Speak、Use Voice Activity。权限整数从纯文字模式的 274878286912 升级到含语音的 274881432640。升级权限后需要重新邀请 Bot 到服务器。
第二步:特权网关意图
在开发者门户中启用:
ALLOWED_USERS 使用用户名而非数字 ID 时需要)第三步:Opus 编解码器
# macOS
brew install opus

# Ubuntu
sudo apt install libopus0
Bot 会自动加载 Opus 库——macOS 路径 /opt/homebrew/lib/libopus.dylib,Linux 路径 libopus.so.0。
第四步:环境变量
DISCORD_TOKEN=your-bot-token
DISCORD_ALLOWED_USERS=user_id_1,user_id_2
DISCORD_FREE_RESPONSE_CHANNELS=channel_id_1
在 Discord 文字频道中发送:
/voice join      Bot 加入你所在的语音频道
/voice channel   /voice join 的别名
/voice leave     Bot 离开语音频道
/voice status    显示语音模式和已连接的频道
必须先在语音频道中才能使用 /voice join,Bot 会加入你所在的同一个频道。
Bot 进入语音频道后的处理流程:
两个关键机制保证体验:
[Voice] @user: what you said。Agent 的回复同时以文字发送到频道并在语音频道朗读DISCORD_ALLOWED_USERS 精简,只放真正需要语音交互的用户/voice on 确认语音回复正常后,再尝试语音频道模式DISCORD_ALLOWED_USERS 列表中的用户可通过语音交互,其他用户的音频被静默忽略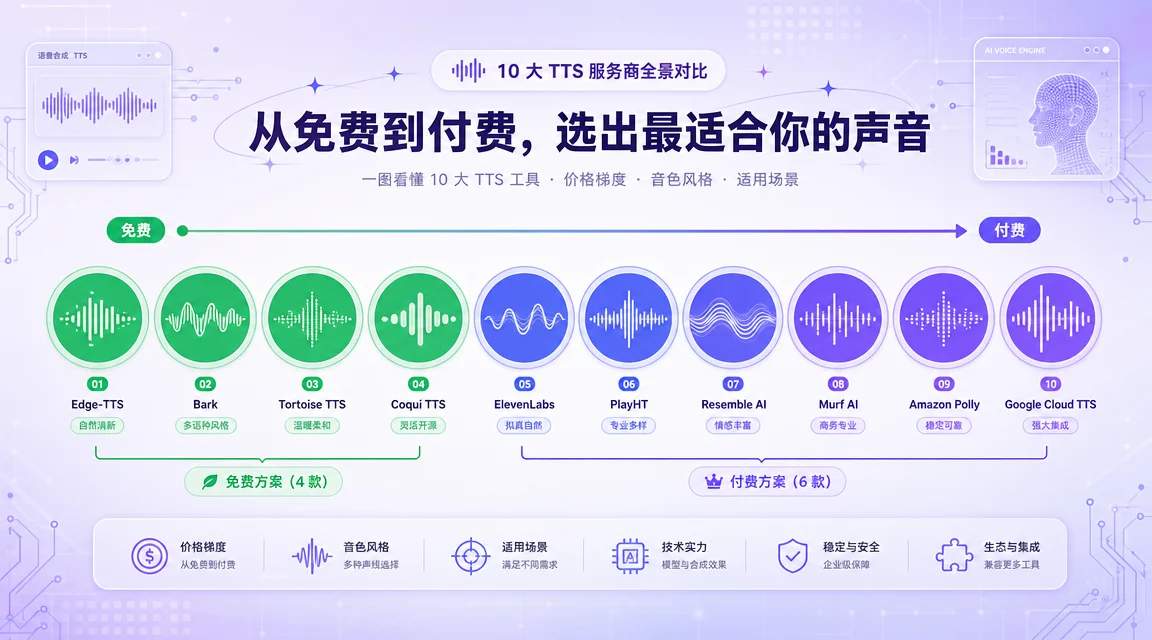
Hermes 支持 10 种文字转语音(TTS)提供商——4 种免费零密钥,6 种付费需凭据。
| 提供商 | 质量 | 成本 | 需要密钥 | 延迟 | 语音数量 | 语言覆盖 | 特色 |
|---|---|---|---|---|---|---|---|
| Edge TTS(默认) | 好 | 免费 | 否 | ~1 秒 | 322 个 | 74 种 | 零配置即用,微软神经语音 |
| NeuTTS | 好 | 免费 | 否 | 取决于硬件 | 可克隆 | 多语言 | 完全本地,支持语音克隆 |
| KittenTTS | 好 | 免费 | 否 | 取决于硬件 | 8 种 | 英语为主 | 25-80 MB 超轻量模型 |
| Piper | 好 | 免费 | 否 | 取决于硬件 | 30+ 种语言预训练 | 44 种 | Home Assistant 维护,CPU 运行 |
| ElevenLabs | 最佳 | 付费 | ELEVENLABS_API_KEY |
~2 秒 | 海量语音库 | 多语言 | 最自然人声,语音克隆 |
| OpenAI TTS | 好 | 付费 | VOICE_TOOLS_OPENAI_KEY |
~1.5 秒 | 6 种 | 多语言 | 快速一致,原生 Opus |
| MiniMax | 优秀 | 付费 | MINIMAX_API_KEY |
中等 | 多种 | 亚洲语言强 | 语速/音量/音调可调 |
| Mistral Voxtral | 优秀 | 付费 | MISTRAL_API_KEY |
低 | 多种 | 多语言 | 低延迟,原生 Opus |
| Google Gemini | 优秀 | 有免费额度 | GEMINI_API_KEY |
中等 | 30 个预置 | 广泛 | Gemini 生态复用 |
| xAI | 优秀 | 付费 | XAI_API_KEY |
中等 | 支持克隆 | 多语言 | 语音克隆,Grok 生态 |
Hermes 在调用 TTS 前自动截断超长文本,请求不会因长度失败:
| 提供商 | 默认上限(字符) |
|---|---|
| Edge TTS | 5,000 |
| OpenAI | 4,096 |
| xAI | 15,000 |
| MiniMax | 10,000 |
| Mistral | 4,000 |
| Google Gemini | 5,000 |
| ElevenLabs | 5,000 - 40,000(按模型) |
| NeuTTS | 2,000 |
| KittenTTS | 2,000 |
| Piper | 5,000 |
可通过每个提供商配置中的 max_text_length 覆盖默认值。
Edge TTS——使用微软神经语音合成基础设施,322 个语音覆盖 74 种语言。Hermes 已经默认使用它,什么都不用改。质量扎实,延迟约 1 秒,唯一的"缺点"是需要网络连接(调用微软在线服务)。
NeuTTS——最佳的免费完全本地方案。通过 llama.cpp 风格推理在本地运行神经 TTS 模型,支持 GPU 和 CPU 加速。还支持语音克隆——提供一段短音频样本和转录稿,Agent 就能用你的声音说话。安装需要 espeak-ng 和 ffmpeg。
Piper——来自 Open Home Foundation(Home Assistant 维护者)的快速本地神经 TTS 引擎。完全 CPU 运行,44 种语言预训练语音,模型仅 20-90 MB。通过 hermes tools 一键安装,首次调用时自动下载语音模型到 ~/.hermes/cache/piper-voices/。支持自定义训练的 .onnx 模型。
KittenTTS——超轻量本地替代方案,nano 模型仅 25 MB。8 种英语语音,支持速度调节和文本清洗(自动展开数字、货币、单位)。适合对模型体积敏感的部署场景。
如果需要的 TTS 引擎不在内置列表中(比如字节豆包 seed-tts-2.0、VoxCPM),可以通过 command 类型接入,不用写代码:
提示词:生成自定义命令 TTS 提供商配置
请帮我生成 Hermes config.yaml 中自定义命令 TTS 提供商的配置。要求:
tts.provider 设为自定义名称(如 doubao)tts.providers.{名称} 下声明 type: commandcommand 字段填 shell 命令,支持 6 个占位符:{input_path}(输入文本文件)、{output_path}(输出音频文件)、{format}、{voice}、{model}、{speed}output_format(如 mp3)、max_text_length(如 1024)、timeout(秒数,如 30)对于无法用单条命令表达的引擎——Python SDK、流式处理、OAuth 刷新——通过 ctx.register_tts_provider() 注册 Python 插件,放在 ~/.hermes/plugins/ 目录即可。
语音转文字(STT)是语音模式的入口。Hermes 支持 6 种 STT 提供商(含自定义命令)。
| 提供商 | 模型 | 速度 | 质量 | 成本 | 需要密钥 |
|---|---|---|---|---|---|
| Local(faster-whisper) | tiny (75MB) | 最快 | 基础 | 免费 | 否 |
| Local(faster-whisper) | base (150MB) | 快 | 好(默认) | 免费 | 否 |
| Local(faster-whisper) | small (500MB) | 中等 | 更好 | 免费 | 否 |
| Local(faster-whisper) | medium (1.5GB) | 较慢 | 很好 | 免费 | 否 |
| Local(faster-whisper) | large-v3 (3GB) | 最慢 | 最佳 | 免费 | 否 |
| Groq | whisper-large-v3-turbo | 极快 (~0.5s) | 好 | 有免费额度 | GROQ_API_KEY |
| Groq | whisper-large-v3 | 快 (~1s) | 更好 | 有免费额度 | GROQ_API_KEY |
| OpenAI | whisper-1 | 快 (~1s) | 好 | 付费 | VOICE_TOOLS_OPENAI_KEY |
| OpenAI | gpt-4o-transcribe | 中等 (~2s) | 最佳 | 付费 | VOICE_TOOLS_OPENAI_KEY |
| Mistral | voxtral-mini-latest | 快 | 好 | 付费 | MISTRAL_API_KEY |
| xAI | grok-stt | 快 | 好 | 付费 | XAI_API_KEY |
Hermes 的 STT 有自动回退机制:local → groq → openai。本地 faster-whisper 不可用时自动尝试 Groq,Groq 也不行再尝试 OpenAI。全部不可用时,语音消息附带准确的提示直接传给 Agent(不转写但不丢失)。
| 场景 | 推荐模型 | 理由 |
|---|---|---|
| 英文日常对话 | base | 150 MB,速度快,英文质量足够 |
| 中文识别 | small 或 medium | base 对中文断句偶有不准 |
| 最高精度 | large-v3 | 3 GB,99 种语言最佳质量 |
| 低配机器 | tiny | 75 MB,牺牲一些质量换速度 |
💡 通俗讲:faster-whisper 是 OpenAI Whisper 的加速版(SYSTRAN 公司用 CTranslate2 重写),同样的精度跑快最多 4 倍,内存占用还更低。Hermes 默认用它作本地 STT 后端。
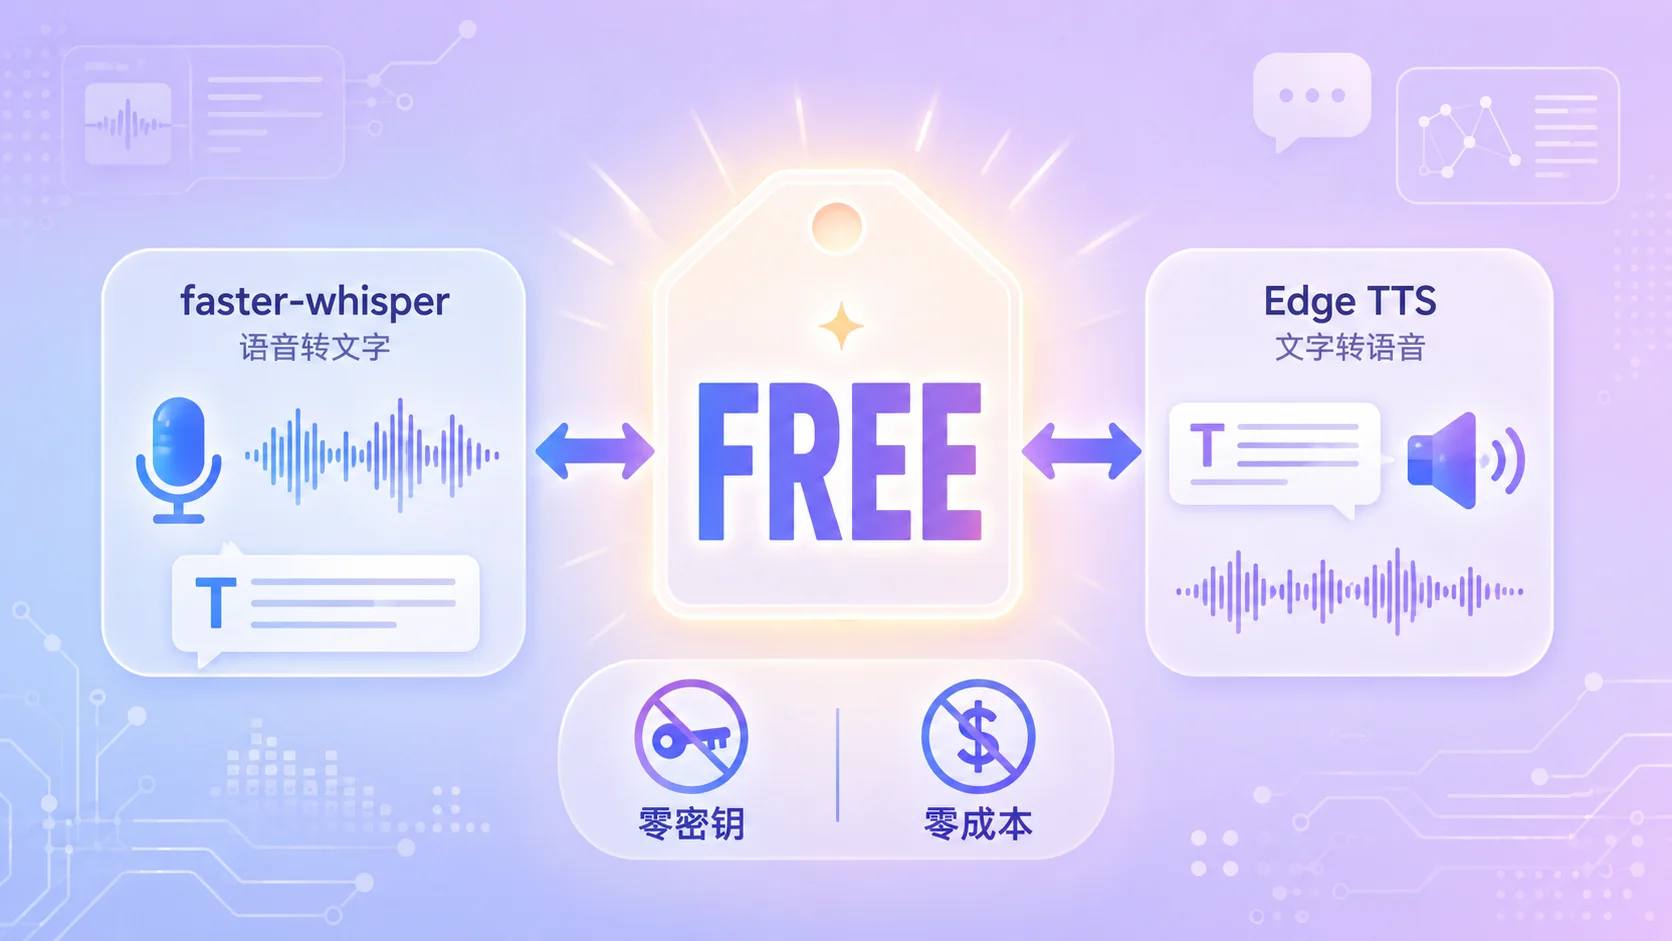
这是 Hermes 语音模式的免费方案——完全免费、零 API 密钥、质量完全够用。
提示词:生成 macOS 零成本语音模式安装脚本
请帮我生成 macOS 上从零搭建 Hermes Agent 语音模式的完整安装步骤。要求:
pipx install "hermes-agent[voice,messaging]" 安装 Hermes 含语音和消息依赖brew install portaudio ffmpeg opus espeak-ng 安装系统级依赖pipx inject hermes-agent Pillow pydub pyaudio PyNaCl 注入多媒体和语音 Python 依赖pipx inject hermes-agent faster-whisper 安装本地 STT 后端hermes doctor 验证安装,期望看到 vision ✓ tts ✓ discord ✓hermes,执行 /voice on,按 Ctrl+B 开始录音总成本:$0。
首次使用语音转文字时,faster-whisper 需要从 HuggingFace 下载模型文件。base 模型约 150 MB,过程中 CLI 看起来像挂起了(没有进度条——这是一个已知问题)。耐心等 1-2 分钟,下载完成后后续使用不再需要等待。
建议提前手动运行一次 pipx inject hermes-agent faster-whisper 触发模型缓存。
官方推荐的学习路径是渐进式的,不要一步到位:
hermes-agent[voice],在 CLI 中用 local STT + Edge TTS 试语音/voice on,体验平台语音回复每一步都确认正常再走下一步。如果跳步直接搞语音频道,出问题时很难定位是 STT、TTS、网络还是权限的问题。
Whisper 有一个被广泛记录的问题:从静音或背景噪声中凭空生成文本。学术研究(arXiv 论文 Careless Whisper)发现约 1% 的音频转写包含完全虚构的短语。社区收集了 135 个 Whisper 常见幻觉短语。
silence_threshold 和 silence_duration 均可配置提示词:生成噪声环境下的语音优化配置
请帮我生成 Hermes config.yaml 中适合噪声环境的语音参数。要求:
voice.silence_threshold 从默认 200 提高到 300-400(值越高越不敏感)voice.silence_duration 从默认 3.0 秒加长到 4.0 秒(适合说话节奏慢的人)stt.provider 设为 local,模型选 small(比 base 幻觉更少)如果仍然出现垃圾转写,最有效的方法是换一个更大的模型(small → medium → large-v3),或者切到云端 STT(Groq 的 whisper-large-v3-turbo 延迟仅约 0.5 秒)。
适合大多数人的保守默认配置。STT 用本地 base 模型,TTS 用 Edge TTS,全免费。
提示词:生成零成本语音 config.yaml
请帮我生成 Hermes 极速免费档的完整 config.yaml。要求:
voice 区块:录音键 ctrl+b、最长录音 120 秒、auto_tts 关闭、蜂鸣开启、静音阈值 200、静音时长 3.0 秒stt:提供商 local,模型 base(150 MB,速度快,英文质量好)tts:提供商 edge,语音 en-US-AriaNeural(322 个语音可选)STT 用 Groq 云端加速,TTS 用 ElevenLabs 最自然人声。
提示词:生成高质量付费语音 config.yaml
请帮我生成 Hermes 高质量付费档的完整 config.yaml。要求:
voice 区块:录音键 ctrl+b、最长录音 120 秒、auto_tts 开启、蜂鸣开启、静音阈值 200、静音时长 3.0 秒stt:提供商 groq(约 0.5 秒延迟,有免费额度)tts:提供商 elevenlabs,voice_id 为 pNInz6obpgDQGcFmaJgB(Adam),model_id 为 eleven_multilingual_v2所有音频处理留在本地,适合对隐私有要求的场景。
提示词:生成完全离线隐私优先语音 config.yaml
请帮我生成 Hermes 完全离线档的完整 config.yaml。要求:
voice 区块:录音键 ctrl+b、最长录音 120 秒、auto_tts 开启、蜂鸣开启、静音阈值 200、静音时长 3.0 秒stt:提供商 local,模型 large-v3(3 GB,最佳质量,完全离线)tts:提供商 piper,语音 en_US-lessac-medium(首次自动下载 20-90 MB)STT 用 medium 模型(中文识别质量好),TTS 用 Edge 的中文语音。
提示词:生成中文优化语音 config.yaml
请帮我生成 Hermes 中文优化档的完整 config.yaml。要求:
voice 区块:录音键 ctrl+b、最长录音 120 秒、auto_tts 开启、蜂鸣开启、静音阈值 250(中文语音特点适当提高)、静音时长 3.5 秒stt:提供商 local,模型 medium(1.5 GB,中文识别推荐)tts:提供商 edge,语音 zh-CN-XiaoxiaoNeural(晓晓,女声);备选 zh-CN-YunxiNeural(云希,男声)如果想切换到其他 TTS 提供商,以下是每个提供商的完整配置:
提示词:生成完整 TTS 提供商参考配置
请帮我生成 Hermes config.yaml 中所有 10 种 TTS 提供商的完整参考配置。要求:
tts.provider 设为当前使用的提供商名(切换此处即可),tts.speed 设全局速度倍率(默认 1.0)voice(如 en-US-AriaNeural)、speedvoice_id(如 pNInz6obpgDQGcFmaJgB Adam)、model_id(如 eleven_multilingual_v2)model(如 gpt-4o-mini-tts)、voice(alloy/echo/fable/onyx/nova/shimmer)、base_url、speed(0.25-4.0)model(如 speech-2.8-hd)、voice_id、speed(0.5-2.0)、vol(0-10)、pitch(-12 到 12)model(如 voxtral-mini-tts-2603)、voice_id(UUID 格式)model(如 gemini-2.5-flash-preview-tts)、voice(30 个预置语音,如 Kore)voice_id(如 eve)、language、sample_rate(24000)、bit_rate(128000)ref_audio(语音克隆参考音频路径)、ref_text(参考转录稿)、model(如 neuphonic/neutts-air-q4-gguf)、device(cpu/gpu)model(如 KittenML/kitten-tts-nano-0.8-int8,25 MB)、voice(如 Jasper)、speed、clean_text(布尔值)voice(如 en_US-lessac-medium)速度控制说明:全局 tts.speed 对所有提供商生效,每个提供商可通过各自的 speed 字段覆盖全局值。当前 TTS 速度控制仅对部分提供商生效(Issue #6926)。
| 场景 | STT 方案 | TTS 方案 | 总成本 |
|---|---|---|---|
| 极速免费 | local (base) | Edge TTS | $0 |
| 高质量免费 | local (large-v3) | NeuTTS | $0(需要 GPU 才流畅) |
| 云端极速 | Groq (whisper-large-v3-turbo) | Edge TTS | Groq 免费额度内 $0 |
| 最佳质量 | local (large-v3) | ElevenLabs | ElevenLabs 月费 |
| 亚洲语言优化 | local (small) | MiniMax | MiniMax 按量付费 |
| 全 xAI 生态 | xAI (grok-stt) | xAI (语音克隆) | xAI 按量付费 |
| 中文优化 | local (medium) | Edge (zh-CN) | $0 |
| 维度 | CLI | Telegram | Discord 语音频道 |
|---|---|---|---|
| 触发方式 | Ctrl+B 按键录音 | 按住麦克风按钮 | 直接在频道说话 |
| 延迟体验 | 最低(本地处理) | 中等(网络往返) | 中等(网络+处理) |
| 适用场景 | 编码时免提调试 | 移动端随时随地 | 团队实时讨论 |
| 多人支持 | 单用户 | 单用户 | 多用户(独立音频流) |
| 回声防止 | 不需要 | 不适用 | 内置自动暂停 |
| 文字联动 | 终端内显示 | 文字+语音并发 | 文字频道同步转写 |
| 免提循环 | 自动重启录音 | 需再次按住发送 | 持续监听 |
| 额外依赖 | sounddevice, numpy | python-telegram-bot | discord.py[voice], Opus, PyNaCl |
语音模式不是一个独立功能,它叠加在 Hermes 的完整 Agent 流水线上。这意味着语音触发的对话可以调用工具、访问记忆、使用技能——和打字完全一样。
几个有趣的联动场景:
| 症状 | 检查点 |
|---|---|
| "No audio device found"(CLI) | 未安装 PortAudio:brew install portaudio。Docker 环境还需配置 PulseAudio/PipeWire 桥接 |
| 首次语音模式 CLI 挂起 | faster-whisper 正在下载模型(base 约 150 MB),耐心等 1-2 分钟 |
| Bot 在 Discord 服务器频道不响应 | 默认需要 @提及。设置 DISCORD_REQUIRE_MENTION=false 或指定免提及频道 |
| Bot 加入语音频道但听不到 | 检查 DISCORD_ALLOWED_USERS 列表、Discord 是否未静音、特权意图是否已启用 |
| 能转写但不说话 | TTS 提供商配置错误或密钥过期。Edge TTS(免费)是默认回退 |
| Whisper 输出垃圾文本 | 幻觉问题。调高 silence_threshold、换更大 STT 模型、在更安静环境使用 |
| Telegram 语音不显示气泡 | 缺少 ffmpeg。安装后 MP3/WAV 自动转换为 Opus 气泡格式 |
| Discord 语音 5 分钟自动断开 | 不活动超时硬编码 300 秒,保持对话或等待后续版本可配置化 |
三种交互表面:CLI(Ctrl+B 录音)、Telegram(语音气泡)、Discord(语音频道实时对话)。三个表面都支持文字和语音并发回复。
可以。faster-whisper 本地 STT 加 Edge TTS 免费合成(322 个语音、74 种语言),全套零成本、零 API 密钥。
CTranslate2 高性能重实现,同等精度下速度最高提升 4 倍、内存更低。Hermes 默认使用它作为本地 STT 后端。
已知幻觉问题,Hermes 内置 26 个多语言幻觉短语黑名单加正则自动过滤。额外建议:调高 silence_threshold、用 small 及以上模型、在安静环境录音。
硬编码 300 秒不活动超时(Issue #17790 请求可配置化)。持续说话或发文字消息可重置计时器。
Opus/OGG 格式。OpenAI TTS、ElevenLabs、Mistral 原生 Opus 无需转换;Edge TTS 等 MP3/WAV 提供商需要 ffmpeg。缺 ffmpeg 时音频以文件附件形式发送。
STT 用 faster-whisper 的 small 或 medium 模型,TTS 用 Edge TTS 的 zh-CN-XiaoxiaoNeural 或 zh-CN-YunxiNeural。完全免费。
两种方式:config.yaml 中声明 type: command 的自定义命令提供商(无需写代码),或通过 ctx.register_tts_provider() 注册 Python 插件到 ~/.hermes/plugins/。
这篇文章是 Hermes 系列教程的一篇。完整的学习路径:

用 Herdr 从空文件夹搭一家 AI 一人公司:建知识库、装 Herdr、四位 AI 员工上岗、新建岗位、第一项任务。五段完整提示词逐段讲透,附手机连回和多台电脑两段补充。
每周精选 AI 编程与自动化实战内容,直达你的邮箱