AGENTS.md 怎么写?OpenAI Codex 智能体指令文件新手完整指南
AGENTS.md 是 OpenAI Codex 等编程 AI 的指令文件,相当于给 AI 看的 README。本文用「一份 AGENTS.md 从最小可用长到完整」的主线,边长边讲:第一份怎么起步、随项目加哪些段落、多级层级怎么合并、和 README / CLAUDE.md 的区别、新手最容易踩的坑。
⏱️ 预计阅读 16 分钟 | 🎯 目标:用「一份 AGENTS.md 从最小可用长到完整」的主线,让你照着把自己项目的第一份写出来,再随项目自然长大。
你刚开始用 OpenAI Codex 或 Claude Code,发现 AI 老是反复忘记你的项目规则——跑哪个测试忘、不能动的文件忘、commit 信息风格忘。每次新对话都要重新交代一遍。解药就是 AGENTS.md:一个 AI 每次开对话都自动读的项目指令文件。
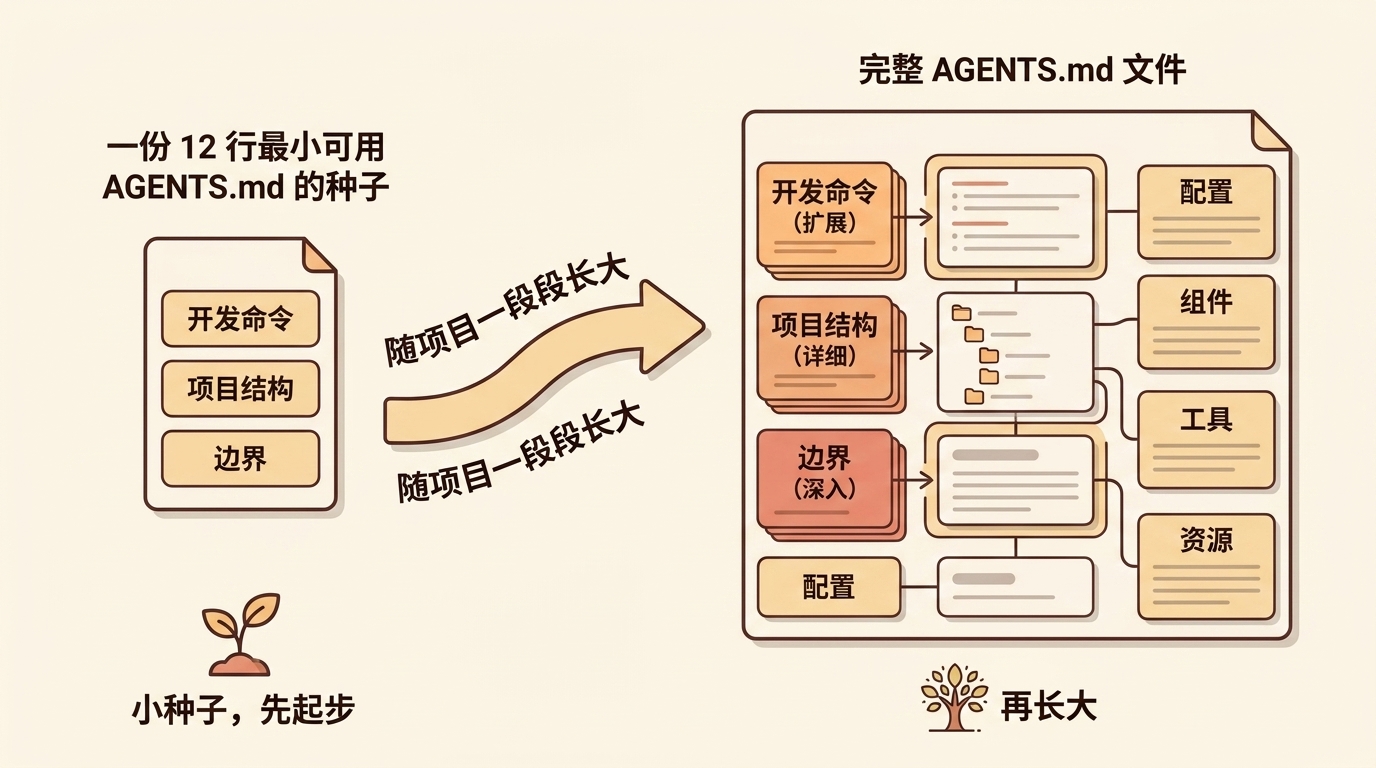
先把第一份抄走:12 行最小可用 AGENTS.md
不绕弯子,先给你一份能直接用的最小版本。在项目根目录新建一个文件,命名为 AGENTS.md,把下面的结构填进去,按你的项目把命令换成真实的:
提示词:生成 12 行最小可用 AGENTS.md
请帮我生成一份最小可用的 AGENTS.md 文件。要求:
- 开发命令段:列出装依赖、跑测试、检查代码三条命令(用我项目的真实命令)
- 项目结构段:标出源码目录、测试目录、自动生成目录(标注"永不手改")
- 边界段:写明"永不直接推送 main 分支、永不提交含密钥的文件"
- 总共不超过 12 行,只保留每次开对话都要让 AI 知道的规则
就这 12 行。Codex(以及做了软链的 Claude Code)每次开对话会自动读它,从此至少不再犯三类最常见的错:跑错命令、改错目录、乱推 main。
这篇文章的写法,就是带你把这份 12 行的种子,一段一段长成一份完整、能扛住真实项目的 AGENTS.md——每加一段,都先告诉你它挡掉的是哪个具体的坑。你不用一次写全,照着长大的节奏走即可。
⚠️ 第一个新手坑:以为「写一份大而全的」才算合格
很多人第一次写 AGENTS.md,憋着要写一份覆盖所有情况的「完整版」,结果三天没动笔。正确的起点恰恰相反——先上 12 行能跑的,再随项目长。GitHub 工程师 Matt Nigh 分析超过 2500 份 agents 指令文件后的一句话很到位:最好的指令文件是迭代长出来的,不是一开始就规划好的(原文:The best agent files grow through iteration, not upfront planning)。
一、为什么是「自动读的文件」:先理解 Codex 的健忘
在往下长之前,先花一分钟搞懂这份文件为什么有用——这决定了你该往里写什么。
AI 编程代理(Coding Agent)每次开新对话,对你项目的了解都从零开始。昨天告诉它的规则不在今天这轮对话的上下文窗口(context window)里,所以它记不住。这是 OpenAI Codex、Claude Code 共同的设计,有意为之:每次从头开始能避免历史错误一直跟着跑。代价是你得有一个「每次自动加载」的地方放项目规则——这就是 AGENTS.md 的全部意义。
所以判断「某条规则该不该进 AGENTS.md」只有一个标准:这条规则是不是每次开对话都要让 AI 知道。是,就写进去;只是这一次任务的临时要求,对话里说一句就行,别污染文件。
AGENTS.md 官方定义页把它讲得很干脆:
A simple, open format for guiding coding agents.(一种简单、开放的、用于引导编程代理的格式。)
拆开三个词:简单——就是个 Markdown 文件,会写 README 就会写它;开放——一个被多家工具共同支持的格式,不是某家私有;引导——给 AI 提供项目上下文,不替代代码、不替代文档。
二、第一次长大:加「项目结构 + 三档边界」
12 行版能挡三类错,但跑一两天你会发现 AI 还是会越界:该问的不问就直接改了数据库、把自动生成的目录翻了个底朝天。这时候补两段。
2.1 把项目结构写细一点
最小版只写了 src/ 和 tests/。真实项目里,AI 最容易踩的是「改了不该改的目录」。把重点目录、尤其是不能动的目录标出来:
提示词:生成项目结构段
请帮我在 AGENTS.md 里补充项目结构段。要求:
- 列出主要源码目录和入口文件,标注各自的技术角色(如路由、数据库客户端)
- 重点标出"不能动的目录":自动生成的、会被覆盖的,注明"永不手改"或"不要直接改"
- 不需要列全每个目录,只标清楚哪些是地雷
关键不在于把每个目录都列全,而在于标清楚哪些是地雷。src/generated/、src/components/ui/ 这种「改了白改、还会引发别的问题」的目录,是 AI 看不出来、必须你告诉它的。
2.2 三档边界:AGENTS.md 判断密度最高的一段
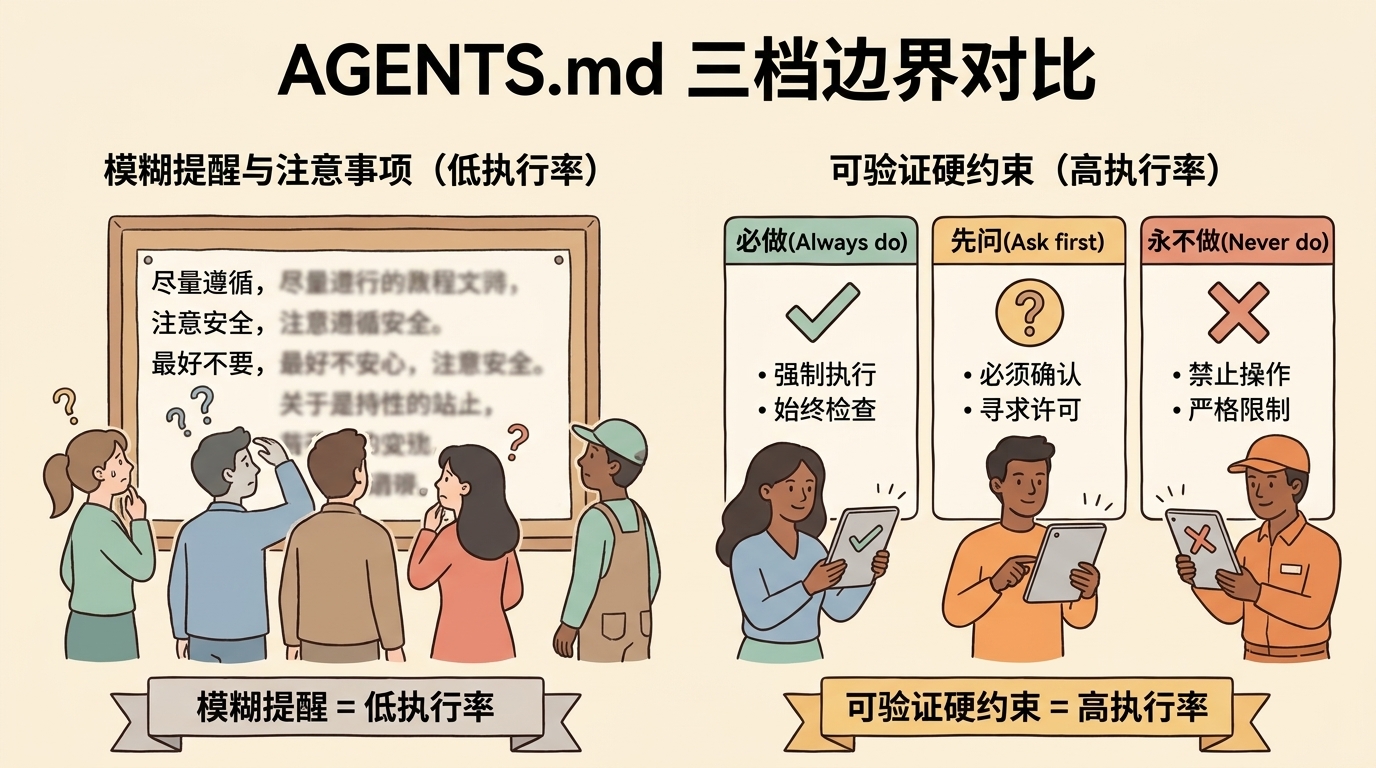
最小版只有一行「永不」。真正拉开效果的是把边界写成清晰的三档——必做 / 先问 / 永不做:
提示词:生成三档边界规则
请帮我在 AGENTS.md 里补充边界段,分成三档:
- 必做:每次提交前必须跑的检查命令、commit 信息格式要求
- 先问:增加新依赖、改核心配置文件(数据库模型、构建配置、CI 配置)前先问我
- 永不做:直接推送 main 分支、提交含密钥的文件、改自动生成的目录
- 每条都用命令式语言,能验证,不用"最好""尽量"这种模糊词
为什么这么分?因为 AI 对命令式语言的执行率,远高于「最好不要」「尽量」这种条件式语言。「未经审批不得修改 main 分支」比「最好别乱改老板的代码哦」清晰一个数量级。
⚠️ 坑:边界写成模糊的「注意事项」
新手最爱写「注意代码质量」「小心别改坏」——AI 完全没法执行。边界段的每一条都要能验证:能不能跑某个命令、能不能碰某个文件、要不要先问你。模糊的提醒等于没写。GitHub 那份 2500+ 仓库的分析里,出现频率最高的有用约束就是一句最直白的话:永不提交密钥(Never commit secrets)。
到这一步,你的 AGENTS.md 大概 25~30 行,已经能扛住绝大多数日常翻车。
三、再长大:加「技术栈 + 代码风格」,但代码风格要克制
项目跑顺了,你会想让 AI 写出来的代码更像「自己人写的」。这时候加技术栈和代码风格——但代码风格这一段,是新手最容易写跑偏的地方。
3.1 技术栈:具体到版本号
## 技术栈
- Next.js 15 + TypeScript(strict 模式)
- 数据库:PostgreSQL + Prisma
- 状态管理:zustand
- 测试:Vitest(单元)+ Playwright(端到端)
写「React 项目」没用,写「React 18 + TypeScript + Vite + Tailwind」才有用。带上主要版本号,AI 才知道该用哪一代 API。
3.2 代码风格:只写「工具检不到」的规则
这里有条硬规则。HumanLayer 团队那句话值得逐字记住:
Never send an LLM to do a linter's job.(永远不要派一个大语言模型去做代码检查工具的活。)
意思是:凡是 ESLint / Prettier / Ruff 这类工具能自动检查和修复的格式规则——缩进、引号、分号、import 顺序——一条都别写进 AGENTS.md。让大语言模型(LLM)去做这些事既慢又贵,还白白占掉上下文。
反例(不要这样写):
## 代码风格(反例:全是 linter 该管的)
- 缩进 2 空格
- 字符串用单引号
- 行尾不要分号
- import 顺序:第三方在前、本地在后
- ……还有几十条
正例(只写有判断、和项目语境强相关的):
## 代码风格
- 状态管理统一用 zustand,不要再引入 Redux(项目已统一)
- 数据库操作必须走 `src/lib/db.ts` 单例,不要 `new PrismaClient()`
- 业务错误用自定义 `ApiError` 类,系统错误才用 `throw`
这三条 ESLint 永远查不到——它们要求作者懂项目背景。这才是 AGENTS.md 该写的代码风格。
⚠️ 坑:把几十条格式规则堆进代码风格段
这是文件臃肿的头号原因。一个实用的清理动作:把现有代码风格段里的每一条过一遍,凡是能交给 ESLint / Prettier 的全部搬走,配进
.eslintrc。搬完你会发现 AGENTS.md 瘦了一大圈,而 AI 反倒更听话——因为剩下的每一条都是它真正需要被提醒的判断。
3.3 顺手补一段「测试约定」:告诉 AI 什么叫「干完了」
AI 编程代理一个高频毛病是「自以为干完了」——代码写完没跑测试就交活,或者改坏了测试干脆把失败的用例删掉。补一小段测试约定能直接堵住它:
提示词:生成测试约定段
请帮我在 AGENTS.md 里补充测试约定段。要求:
- 测试文件命名规则和存放位置
- 改完代码必须跑相关测试,全过才算完成
- 写明端到端测试工具和配置路径
- 硬约束:永不为了让测试通过而删除或跳过失败用例(要先问我)
最后一条尤其关键。GitHub 那份 2500+ 仓库的经验里专门点了这个边界:测试代理可以写测试,但绝不能因为某个测试失败、它又修不好,就把测试删掉。这种「破坏性偷懒」一旦发生很难察觉,写进边界提前堵死。
到这一步,你的 AGENTS.md 已经覆盖命令、结构、边界、风格、测试五个面,对单仓库项目基本够用了。下面两节是项目继续长大才会用到的形态:多目录、跨工具。
四、长到多目录:层级合并机制(Codex 怎么读多份 AGENTS.md)
项目一旦变成前后端分离、或者多个子项目共仓的单体仓库(monorepo),一份根目录 AGENTS.md 就不够用了——前端要 React 规则、后端要 Postgres 规则,混在一份里互相干扰。这时候 AGENTS.md 自然要长成「多份分布在不同目录」的形态。理解 Codex 怎么合并它们,是用好这一步的前提。
4.1 Codex 启动时的合并规则
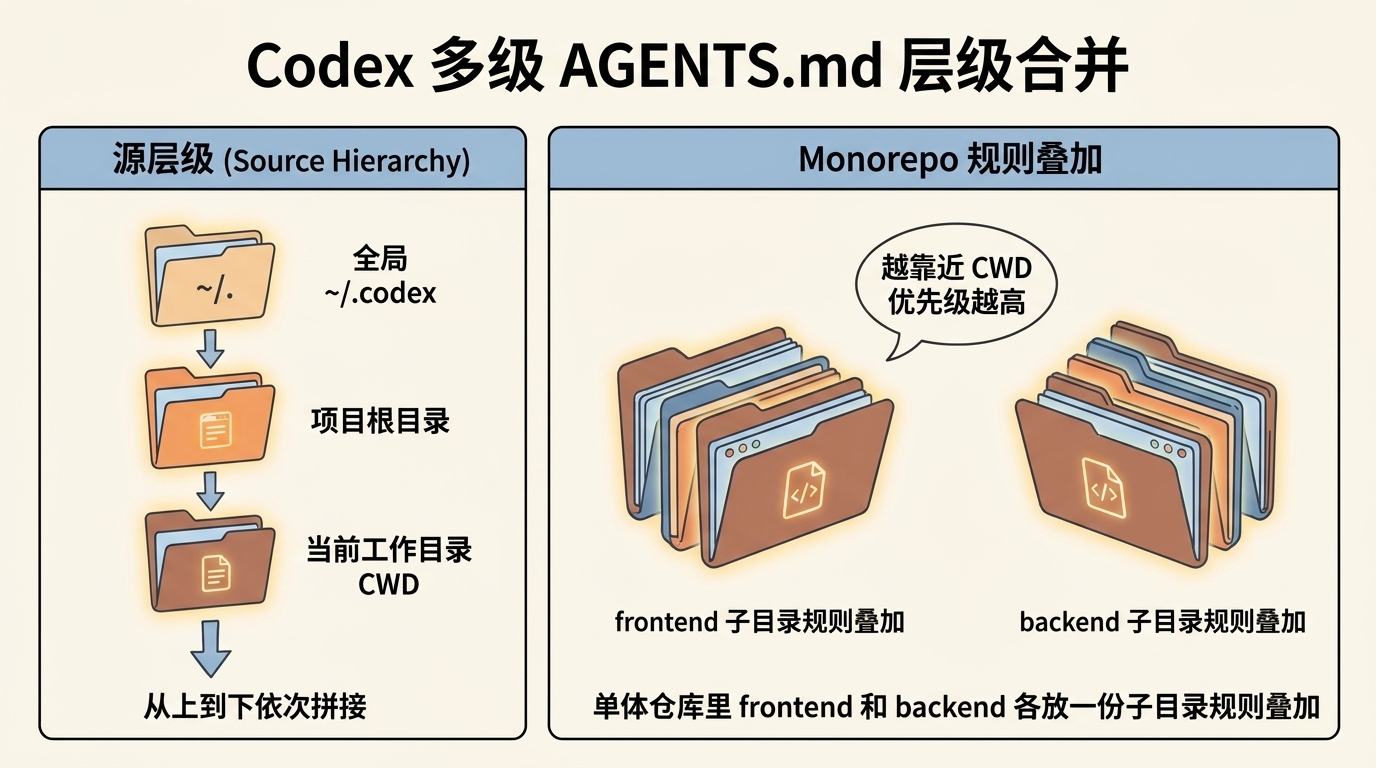
OpenAI 官方 AGENTS.md 指南说明:Codex 每次启动会话时,会从全局到项目、从根目录到你的当前工作目录(CWD),按顺序拼接多份 AGENTS.md:
- 全局层:先看
~/.codex/(或你设的CODEX_HOME)。这一层先找AGENTS.override.md,没有再找AGENTS.md,只用第一个非空的文件。 - 项目层:从 Git 根目录一路向下走到 CWD,每一层目录依次找
AGENTS.override.md→AGENTS.md→ 配置里的回退文件名(下面 §4.4 讲),每层最多取一个。 - 拼接顺序:从根往下拼,用空行连接。越靠近 CWD 的内容排得越靠后、优先级越高——因为它出现在合并后提示词的更后面,按官方原文的说法,靠后的指令会覆盖(override)前面的。
4.2 一张图看懂
flowchart TD
    Start[Codex 启动] --> G["读全局 ~/.codex/AGENTS.md"]
    G --> R["读项目根 AGENTS.md"]
    R --> M[读中间目录 AGENTS.md,如有]
    M --> C[读 CWD 目录的 AGENTS.md,如有]
    C --> Merge["从根往下拼接(越近 CWD 越靠后、优先级越高)"]
    Merge --> Inject[注入对话上下文]

    classDef step fill:#1f6feb,color:#fff,stroke:#0d3a8a,stroke-width:2px
    classDef inject fill:#2da44e,color:#fff,stroke:#1a6b35,stroke-width:2px
    class G,R,M,C,Merge step
    class Inject inject
4.3 一个单体仓库的实际例子
假设你的单体仓库(monorepo)长这样:
my-saas/
├── AGENTS.md          ← 整个仓库的通用规则
├── frontend/
│   └── AGENTS.md      ← 前端专属规则(React + Tailwind)
└── backend/
    └── AGENTS.md      ← 后端专属规则(Node + Postgres)
你在 backend/ 目录里启动 Codex,它会按顺序读并拼接:
~/.codex/AGENTS.md(你的全局偏好)my-saas/AGENTS.md(仓库通用规则)my-saas/backend/AGENTS.md(后端规则,排最后、优先级最高)
注意它是三份叠加,不是只读最后一份。仓库通用规则依然生效,后端规则只是在冲突时优先。这也是分布式写法的好处:每个子项目只维护自己那一份,互不打架;你在 frontend/ 里也改不到 backend/ 的规则,文件层级天然成了权限边界。
4.4 两个进阶机制:override 和回退文件名
AGENTS.override.md:本层取代,不是整链覆盖。这是个容易被误解的点。同一层目录里如果有 AGENTS.override.md,Codex 在这一层只读它、不读同层的 AGENTS.md。但上级目录的 AGENTS.md 照常被读取并拼接——它不会把整条指令链都顶掉。
举例:my-saas/infra/AGENTS.override.md 只让 Codex 在 infra/ 这层不读 infra/AGENTS.md,而 my-saas/AGENTS.md(仓库通用)和 ~/.codex/AGENTS.md(全局)依然在合并链里。它的典型用途是「这个子目录的本层规则要换一套」(比如 infra/ 用 Terraform 不用 TypeScript),不是「这个子目录要无视所有上级规则」。
实操约定:
| 文件 | 是否进 git | 用途 |
|---|---|---|
AGENTS.md |
✅ 进 | 团队共享的项目规则 |
AGENTS.override.md |
❌ 不进(加进 .gitignore) |
个人临时调整,不污染团队配置 |
回退文件名——旧仓库零改名接入。 如果项目已经用了别的指令文件名(比如 TEAM_GUIDE.md),不想改名,在 ~/.codex/config.toml 里配一行:
project_doc_fallback_filenames = ["TEAM_GUIDE.md", ".agents.md"]
之后 Codex 在每层目录的查找顺序就变成:AGENTS.override.md → AGENTS.md → TEAM_GUIDE.md → .agents.md。旧仓库一行配置接入,不必动现有文件。
4.5 大小上限:32 KiB,但你几乎碰不到
Codex 对合并后的总内容有大小上限,由 project_doc_max_bytes 控制,官方默认值是 32 KiB(即 32768 字节),超过的部分会被静默丢弃。
新手几乎碰不到这个上限——几十行的 AGENTS.md 只占几 KB。真要在多级仓库里触顶,可以在 ~/.codex/config.toml 里调大:
project_doc_max_bytes = 65536 # 调到 64 KiB
⚠️ 坑:触顶了第一反应去调大上限
调大上限是治标。文件越长,AI 对每条规则的注意力越分散、命令准确度越往下掉——这个代价比「被截断」更隐蔽也更伤。触顶的正解永远是先裁剪、再分层:把通用规则留在根、专属规则下沉到子目录,而不是把所有东西堆进一份再把上限拧大。
五、长到跨工具:AGENTS.md、CLAUDE.md、README.md 怎么分工
到这一步,你可能同时在用 Codex 和 Claude Code,或者团队里有人用 Cursor。一个高频困惑冒出来:我到底写 AGENTS.md 还是 CLAUDE.md?和 README 又是什么关系?
5.1 三个文件,三种读者
| 文件 | 写给谁看 | 内容侧重 | 谁定义 |
|---|---|---|---|
| README.md | 主要给人看,AI 也会读 | 项目是什么 / 为什么存在 / 怎么贡献 | 通用 Markdown 惯例 |
| AGENTS.md | 给 AI 编程代理看 | 怎么跑命令 / 代码风格 / 不能动哪里 | agents.md 开放格式(Codex、Cursor、Gemini CLI、GitHub Copilot 等共同支持) |
| CLAUDE.md | 给 Anthropic 的 Claude Code 看 | 同 AGENTS.md,但 Claude Code 专读这个名字 | Anthropic 私有 |
一句话分工:README 给来访的人看项目门面,AGENTS.md 给 AI 看工作守则,CLAUDE.md 是 Claude Code 专用的那个文件名。三者可以共存——README 写愿景和贡献指南,AGENTS.md 写命令和边界,两边别互相重复。
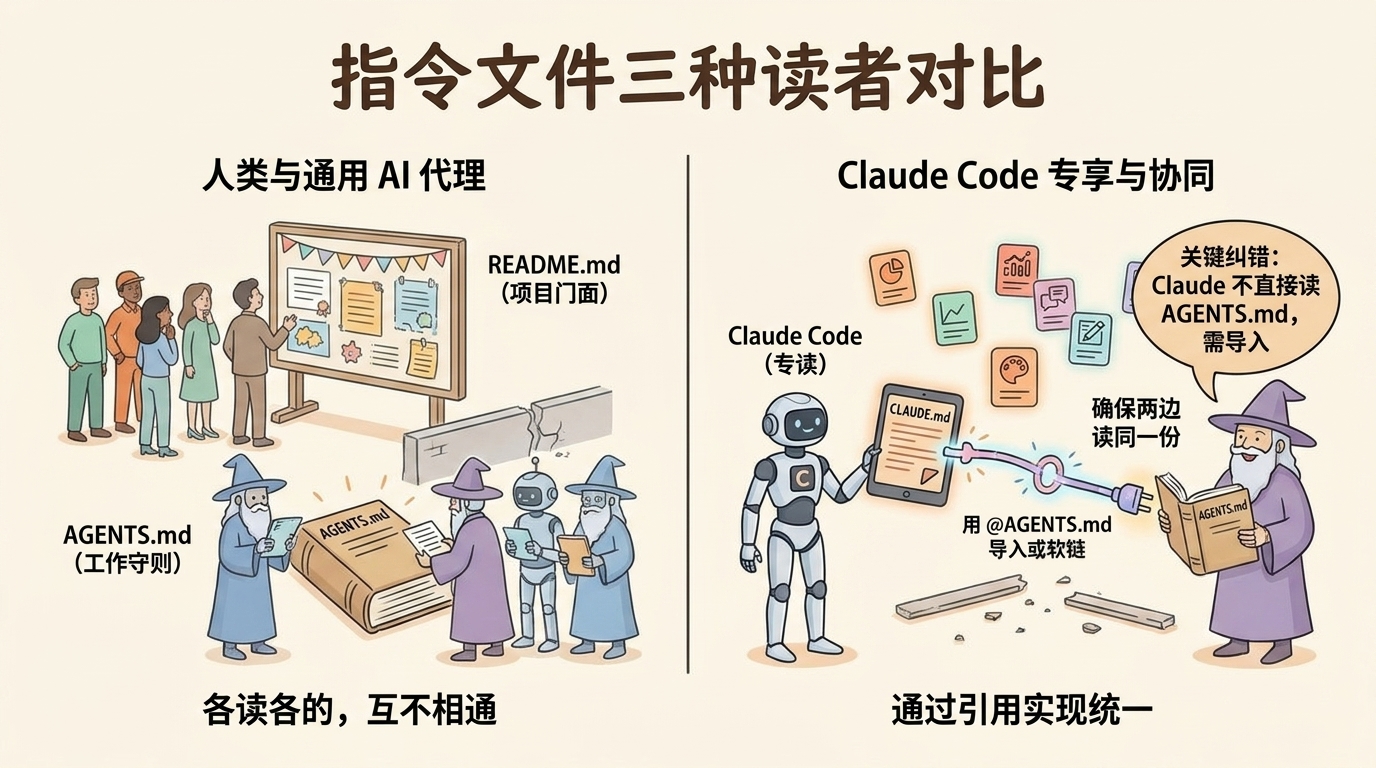
5.2 关键纠错:Claude Code 不读 AGENTS.md
这一点几乎所有新手都搞错,连不少教程都写错,必须讲清楚。
Claude Code 不会自动读 AGENTS.md。 Anthropic 官方文档原文是:
Claude Code reads CLAUDE.md, not AGENTS.md.(Claude Code 读 CLAUDE.md,不读 AGENTS.md。)
也就是说,AGENTS.md 不是 Claude Code「找不到 CLAUDE.md 时的回退」——它根本不在 Claude Code 的查找路径里。这也对得上 agents.md 官方支持列表:上面列了 Codex、Cursor、Gemini CLI、GitHub Copilot 的编程代理、Jules、Amp 等一长串工具,但没有 Claude Code。
那同时用 Codex 和 Claude Code 怎么办?官方给了两种做法,都是「让两个工具读同一份内容」:
做法一(官方推荐):在 CLAUDE.md 里引入 AGENTS.md。 建一份 CLAUDE.md,用 Claude Code 的 @ 导入语法把 AGENTS.md 引进来,还能在下面补 Claude 专属指令:
@AGENTS.md

## Claude Code 专属
- 改 `src/billing/` 下的代码时先进 plan mode。
做法二:直接做软链。 如果不需要给 Claude 加专属内容,让 CLAUDE.md 软链到 AGENTS.md 即可:
ln -s AGENTS.md CLAUDE.md
这样磁盘上只有一份真实内容(AGENTS.md),CLAUDE.md 是指向它的软链,Codex 和 Claude Code 各读各的文件名、内容零漂移。
⚠️ 坑(两个):软链方向 + Windows
第一,别建错方向。新手第一次写时,项目里通常还没有任何指令文件——那就先建
AGENTS.md(它支持的工具最多),再让CLAUDE.md软链或@引入它。反过来「先有 CLAUDE.md 再mv改名」只适合你已经有一份 CLAUDE.md 的老项目,新手不要套。第二,Windows 上软链要管理员权限或开发者模式。Anthropic 官方建议 Windows 用户直接用
@AGENTS.md导入,别折腾软链。
5.3 那 README 已经写全了,还要 AGENTS.md 吗?
要。README 是叙事性的、写给人读的,AI 需要的是机器可读、命令式、明确的指令。最佳实践是:先有 README 讲清项目是什么,再单写一份精简的 AGENTS.md 讲清 AI 怎么干活,两者各司其职。
六、长成完整后长什么样:一份可整段抄走的版本
把前面一段段加上去的内容拼起来,一个典型单仓库项目长成后的 AGENTS.md 大概包含七个段落:项目简介、开发命令、项目结构、技术栈、代码风格、测试约定、边界,最后加一个「引用」段指向详细架构文档和 API 文档——AGENTS.md 自己要短,详细内容用一行指针指过去就行,AI 需要时会自己去读。
这些段落前面已经逐个讲过怎么写。完整拼起来大约 50 行,就是「完整」的形态了。它不是你第一天该有的样子,是跑过一两周、踩过几次坑之后自然长成的样子。别一上来就想写全,从前面那 12 行开始,缺哪段补哪段。
七、长期维护:把 AGENTS.md 当活文档
到这里你的 AGENTS.md 已经从 12 行长到了几十上百行,覆盖命令、结构、边界、风格、可能还跨了多目录和多工具。还有一件大多数人忽略的事:它不是写完归档的文件,是要持续裁剪的活文档。
两个明确的改动信号:
| 信号 | 动作 |
|---|---|
| AI 反复犯同一个错(≥ 2 次) | 加一条规则进 AGENTS.md,下次自动避开 |
| 某条规则项目里已经不适用了 | 删掉它,否则 AI 还按旧的做 |
| 加了规则 AI 还是忽略 | 把它挪进「永不做」段更显眼,或拆成更短的单句 |
关于「该写多短」,几个有出处的参照点,按你的场景取:
- HumanLayer 团队公开他们自己的根级 CLAUDE.md 不到 60 行,并主张「指令越少越好,理想情况只留对任务普遍适用的那些」。
- Anthropic 对 CLAUDE.md 的官方建议是「目标控制在每份文件 200 行以内,更长会消耗更多上下文、降低遵循度」。
两个数字都指向同一个方向:短的永远比长的好。所以维护的核心动作是「删」,不是「加」——每加一条都问一句「这条是不是每次开对话都要让 AI 知道」,答案是「不一定」的,就别留。
🔥 翔宇判断
在我自己的多机环境里,AGENTS.md 真正的回报不在「写得多全」,而在维护这个动作本身。我的习惯是把全局
~/.codex/AGENTS.md硬性卡在两百行以内,超出的一律下沉到具体项目目录。这条线带来一个反直觉的结果:文件越是被逼着删,Codex 反而越准——因为它每次只读到「此时此地真正相关」的那几十行,而不是被一堆历史规则稀释注意力。对新手而言,与其纠结第一份写得够不够全,不如先养成「每周删一遍」的手感,这比任何模板都更能决定 AGENTS.md 长期有没有用。
八、把 AI 当起草工,别当拍板编辑
单独拎出来讲,因为这是新手最纠结的问题:能不能让 AI 自己生成 AGENTS.md?
Claude Code 有 /init 命令,能扫一遍项目、自动生成一份 CLAUDE.md(已有 AGENTS.md 时还会把它的内容并进来)。让它出草稿完全可以——但出来的东西你必须自己过一遍,原因有二:
- 命令可能是「猜」的。 自动生成会写出看起来合理、但和项目真实命令对不上的步骤。这种错最坑,因为它看着对。
- 容易堆套路话。 自动生成倾向于把「可能有用」的东西都塞上,信息密度低,反而稀释你真正想强调的规则。
所以正确姿势是:让 AI 起草当骨架,你来核对和裁剪——保留它对的部分(项目结构、能扫出来的命令),删掉空话,补上只有你知道的真实约束(哪个目录是地雷、哪条业务规则不能破)。把 AI 当起草工,最终拍板的编辑是你。
⚠️ 坑:让 AI 一把生成后原样提交
这是「文件臃肿 + 命令对不上」的双重源头。自动生成的草稿没问题,原样不审就用才是问题。哪怕只花五分钟,把它列的每个命令在终端跑一遍验证真实性,就能避开大半坑。
九、新手坑速查(一次看全)
前面分散在各节的坑,集中放这里方便回查:
| 坑 | 后果 | 怎么避 |
|---|---|---|
| 憋着写「大而全」迟迟不动笔 | 永远写不出第一份 | 先上 12 行能跑的,再随项目长 |
| 边界写成模糊提醒 | AI 没法执行 | 每条都能验证:跑什么命令 / 碰什么文件 / 要不要先问 |
| 把 ESLint 能管的格式规则堆进去 | 文件臃肿、AI 分心 | 格式交给 linter,AGENTS.md 只写有判断的规则 |
触顶就调大 project_doc_max_bytes |
治标,AI 准确度反降 | 先裁剪、再把专属规则下沉子目录 |
| 以为 Claude Code 会读 AGENTS.md | 规则根本没生效 | 用 @AGENTS.md 导入或软链,让 CLAUDE.md 读它 |
| 软链建反方向 / Windows 直接软链 | 内容没接上 / 权限报错 | 新手先建 AGENTS.md 再软链;Windows 用 @AGENTS.md 导入 |
| 把 override 当整链覆盖 | 误删上级通用规则 | override 只取代本层,上级照常合并 |
| AI 生成后原样提交 | 命令对不上、套路话多 | 当草稿核对裁剪,自己拍板 |
| 写完归档不再维护 | 规则慢慢失效 | 当活文档,反复犯错就加、不适用就删 |
| 从陌生仓库直接抄 AGENTS.md | 可能中隐形字符注入 | 先看内容、扫隐形字符,变更走 PR |
最后一条单独说一句:安全公司 Pillar Security 在 2025 年披露了一类「规则文件后门」(Rules File Backdoor,原始报告)——攻击者在这类指令文件里塞 Unicode 隐形字符注入隐藏指令。因为 AGENTS.md 的内容会进入 AI 的指令上下文,从不可信仓库复制前一定先看一遍,并把 AGENTS.md 当代码一样走 PR 评审。
十、写完先自检
照着第一份长到这一步,发布前对自己问一遍:
- [ ] 开发命令写清了吗(装依赖、跑测试、构建)?
- [ ] 项目结构里标出地雷目录了吗(哪些自动生成、不能改)?
- [ ] 有清晰的「永不做」硬约束吗(不推 main、不提交密钥)?
- [ ] ESLint / Prettier 能做的格式规则剔除了吗?
- [ ] 跨工具用时,CLAUDE.md 是用
@AGENTS.md导入或软链读到同一份吗? - [ ] AI 生成的草稿我自己核对裁剪过了吗?
- [ ] 我打算定期回顾、把过时规则删掉吗?
- [ ] 它当代码 commit 进 git 了吗?
任何一题答「没」,回去看对应章节。
一句话收官
AGENTS.md 不用一次写全。先上 12 行能跑的,再随项目一段一段长大——加项目结构挡改错目录,加三档边界挡越权,加代码风格让 AI 写得像自己人,长到多目录就分层、长到跨工具就用导入或软链让 CLAUDE.md 读同一份。
记住三件事就够:先起步、把格式交给 linter、当活文档定期删。AI 老犯错到 AI 越用越准,差的就是这一份会长大的文件。
相关阅读
- OpenAI Codex 完整学习指南 —— Codex 所有知识点的中枢页,看清学习顺序。
- OpenAI Codex 四个入口怎么选?CLI、App、IDE、Cloud 新手对比指南 —— 写 AGENTS.md 之前先选好你用哪个 Codex 入口,配置文件路径会跟着不同。
- Claude Code CLAUDE.md 怎么写 —— 同类工具的对应专题,对照看更完整。
- 换台电脑 Claude Code 全没了?我的多机同步方案 —— 多机使用时如何把 AGENTS.md 同步到所有设备。
- OpenAI Codex 团队协作指南
- Claude Code Skill 完整指南 —— 当 AGENTS.md 写完仍然有重复工作时,技能(Skills)是下一步。
外部参考(按本文引用顺序):
- OpenAI 官方 AGENTS.md 指南 —— Codex 合并机制、
project_doc_max_bytes、override、回退文件名的官方说明。 - agents.md 开放格式 —— 标准定义页与支持工具列表。
- Claude Code 官方文档:CLAUDE.md 与记忆 —— 「Claude Code 读 CLAUDE.md 不读 AGENTS.md」与
@AGENTS.md导入做法的来源。 - GitHub:基于 2500+ 仓库的 agents 指令文件写作经验 —— 命令放前面、明确边界、迭代成长的来源。
- HumanLayer:写好 CLAUDE.md / AGENTS.md —— 「不要让 LLM 做 linter 的活」与「root 文件不到 60 行」的来源。
- Pillar Security:Rules File Backdoor 攻击 —— 规则文件隐形字符注入的来源。
📚 更多 Agent 工作流内容:Agent 工作流实战指南:从单个 Agent 到十人团队的完整搭建路径
下一步
- AI 编程实操课:Claude Code + Codex + Agent 工作流,覆盖一人公司、自媒体自动化、AI 副业全场景。237 篇实战教程 + 最佳实践 + 源码包,跟着做就出成果。国内版-FlowUS | 国际版-BMC
- YouTube 频道:翔宇工作流
- 微信公众号:搜索「翔宇工作流」

接着读
Grok Bot 适合做什么:四个测试与真假案例判别
能成的活形状都一样:读点东西、查个系统、应用一条规则、写出结果。四个测试判断值不值得交,五个判据分辨你看到的案例是真是假——声量最大的那一类,真实使用里几乎不存在。