42. AI 视频剪辑实战:用 Claude Opus 5.5 剪口播长视频,完整工作流教程
30 分钟的长视频一个会话剪不完。这篇讲八步剪辑 Skill:锁定旁白和一种风格,长视频切成分镜交给全新的子 Agent 并行制作,初版之后开空白会话精修,并附 Skill 原文和默认参数表。
30 分钟的长视频一个会话剪不完。这篇讲八步剪辑 Skill:锁定旁白和一种风格,长视频切成分镜交给全新的子 Agent 并行制作,初版之后开空白会话精修,并附 Skill 原文和默认参数表。

用 Herdr 从空文件夹搭一家 AI 一人公司:建知识库、装 Herdr、四位 AI 员工上岗、新建岗位、第一项任务。五段完整提示词逐段讲透,附手机连回和多台电脑两段补充。
30 分钟的长视频一个会话剪不完。这篇讲八步剪辑 Skill:锁定旁白和一种风格,长视频切成分镜交给全新的子 Agent 并行制作,初版之后开空白会话精修,并附 Skill 原文和默认参数表。
先看这里:本页与完整版的区别
本页是基础版(免费)。 全部提示词和八步剪辑 Skill 的完整原文都在这一页,复制粘贴即可,一部口播长视频可以照着手动做完。
完整版收录在「翔宇工作流 AI 编程实操课」中,包含:可运行的脚本和 Remotion 起步引擎;五套入门风格手册、一份空白模板,以及研发自己风格的方法;部署运行手册;长文档。
国内版(FlowUS): 了解并加入 AI 编程实操课
海外版(Buy Me a Coffee): 了解并加入 AI 编程实操课
本页目录
这一页讲怎么用 AI 剪口播长视频:不拖时间轴,让 Claude Code 里的模型写 Remotion 代码出画面;把要定死的规矩、要放开的部分、委派用的提示词沉淀成一套八步的剪辑 Skill,长视频按固定时长切成分镜,交给子 Agent 去剪。方法适用于任何以旁白为主线的长视频。
配套视频讲的是思路:AI 剪辑难在哪,怎么用三层框架和四个象限想清楚和 AI 怎么协作。这一页把它落到能直接拿走的东西上:怎么开一部片;八个步骤每一步做什么、哪里要我们自己拍板;四个象限各对应哪段提示词,并给出完整版(开题、定调、委派任务卡、看片、精修、审计);模型和努力程度怎么配。所有提示词都在这一页里,复制粘贴就能用,一部片可以完全照着手动做下来;Skill 原文也全部贴在页尾。文中的具体数字和工具选择(分镜时长、并发数、画幅、帧率、制作工具、模型等)都是可调的默认值,集中列在第二部分「前置准备」的「默认参数一览」,其余地方只引用参数名。
本期视频:AI 视频剪辑实战:用 Claude Opus 5.5 剪口播长视频,完整工作流教程(YouTube)
本期视频时长 29:33,讲怎么用 Claude Opus 5.5 在 Claude Code 里写 Remotion 代码剪口播长视频:AI 剪辑难在哪、三层框架、四个象限、八步剪辑 Skill,以及模型和努力程度怎么选。观看:YouTube(29:33)。想直接跳到某一段,见下面「视频章节」。
下面每一行都是视频里对应位置的链接,点开直接从那一段播放;各段对应这一页的哪一节,见列表后面一段。
对应关系:0:13 到 3:41 三段是后面「长视频剪辑的难点」一节;5:02 对应「三层框架」;7:22 到 24:35 对应「四个象限及其用法」和「八步剪辑 Skill 总览」;26:52 对应「模型与努力程度配置」。
先说结论:这一页不是一份要逐条照做的操作手册,而是交给一个空白的 Agent 会话,让它当参考的材料。做法是:开一个全新的会话,模型和努力程度按第二部分「模型与努力程度配置」的推荐配置,把这一页和我们自己的旁白一起交给它。它把这里讲的整个流程当参考,不当约束,用它自己的最大能力去做,觉得有更好的办法可以换方法。真正约束它的,只有后面列的几道硬关口。
教程.md(或者直接整页粘进去)。页面里的提示词都是给 Agent 参考的素材,它会按需要读。在空白会话里粘下面这一段,把花括号里的内容换成自己的:
这个文件夹是我新片的工作目录。先运行 pwd 给我看,再动任何东西。

我要剪一部口播讲解视频。旁白:{{旁白文件路径,或者"还没有,口播稿在 xx"}}。
教程在 ./教程.md。请先把它读完。它是一套通用的口播长视频剪辑做法:八个步骤、四个象限、提示词和任务卡。把它当参考,不当约束:按它的整体流程走,但每一步用你自己的最大能力,觉得有更好的办法就换,换了在 progress.md 里写一句为什么。
参数:沿用教程「默认参数一览」里的默认值,只有下面列的几项改成我的:{{要改的参数名和值,没有就写「全部默认」}}。请把最终生效的参数原样记进 progress.md 的「参数」一节,之后所有步骤里提到的参数名都以它为准。
只有这几道硬关口不能越过:
1. 旁白和逐字时间一旦定稿就锁定,不改一个字;字幕只做成单独的字幕轨,不烧进画面。
2. 开题访谈答完之前,不出任何画面。
3. 风格由我选定,你不替我决定;锁定清单上的东西不改。
4. 花钱的事、公开的事(上传、发布)、删了回不来的事,先停下来问我。
其余的都由你判断。每做完一步,在 progress.md 里更新一行,然后继续,不要问"要不要继续"。

现在从预检开始,接着做开题访谈。
整个过程我们真正要看、要拍板的只有四处,其余 Agent 自己往下走:
除了这些,它不会为了小事来问。要是它问得太碎,回一句「这类事你自己定,记在 progress.md」就行。
视频开头讲了三件事,后面所有设计都从这里来。
组合是天文数字。 一个画面里放哪些元素、怎么排、怎么演、缓动曲线怎么走、卡在哪个字上,每一项都有很多做法,乘在一起就是成千上万种组合;一部片又由成千上万个画面组成。剪辑要做的,是按旁白的意思,在这些组合里挑一条最好的路。
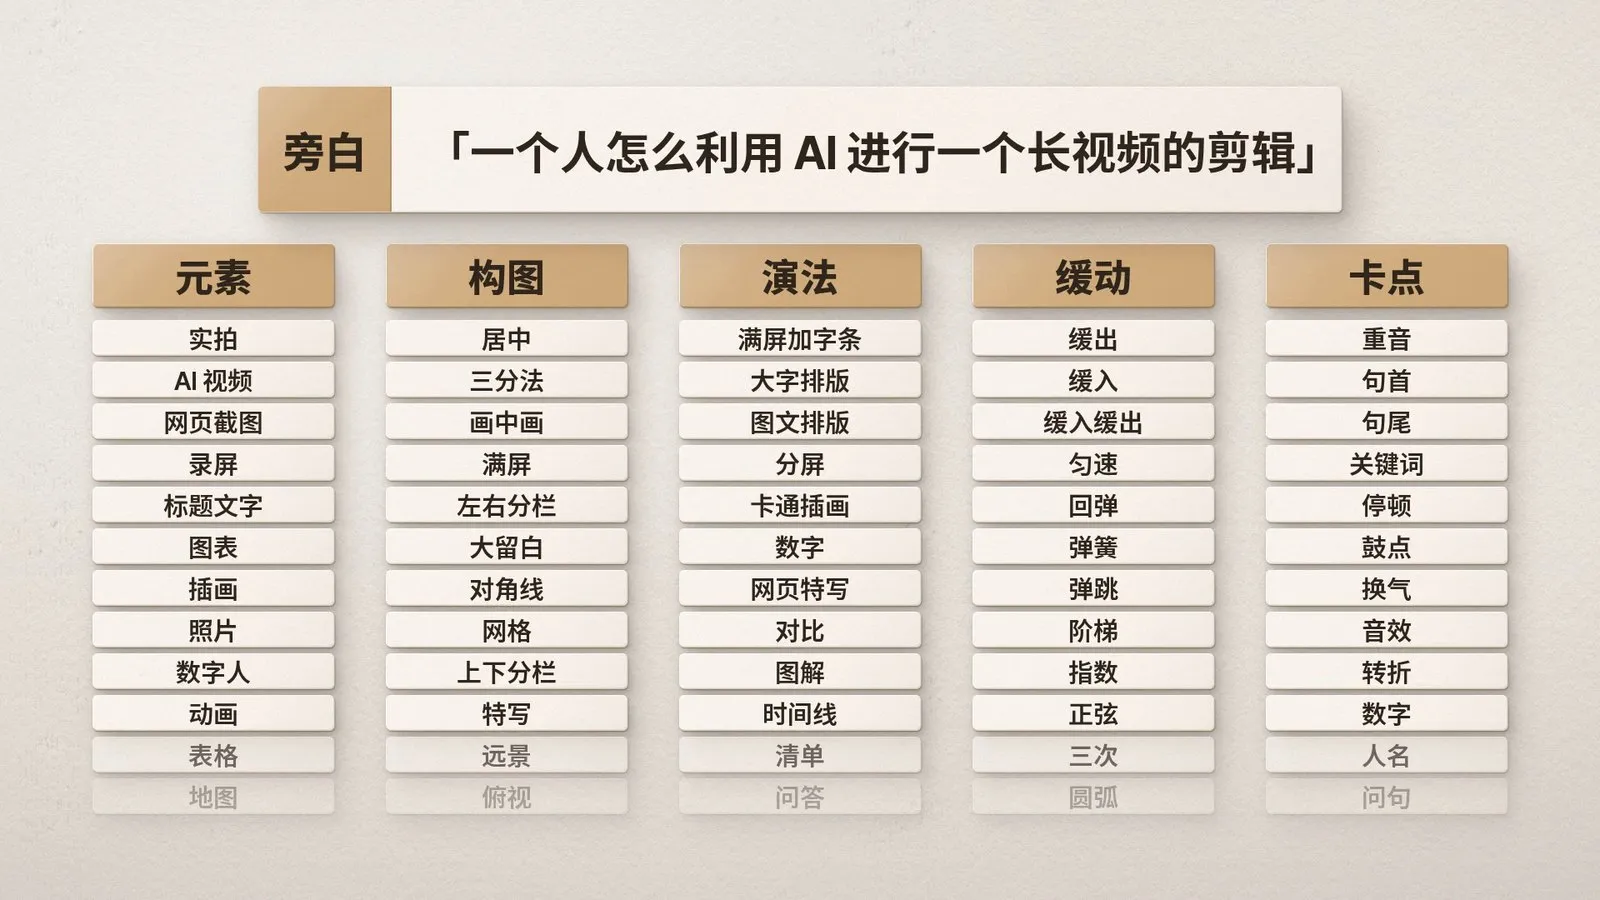
视频 1:00 · 每一类都有十来种做法,乘在一起就是天文数字
AI 不拖时间轴,它写代码:任何一个时刻,算出这一帧该长什么样就行,一秒 N 帧(N 即「帧率」)就算 N 次。Remotion 和 HyperFrames 走的都是这条路,元素、转场、缓动、字号在它眼里都是函数的参数。好处有两个:它能很快算出一个答案,还能同时委派好几个 Agent 去试不同的风格;代码能复用,上一部片攒下的手艺,改几处文字和主题就能用到下一部。
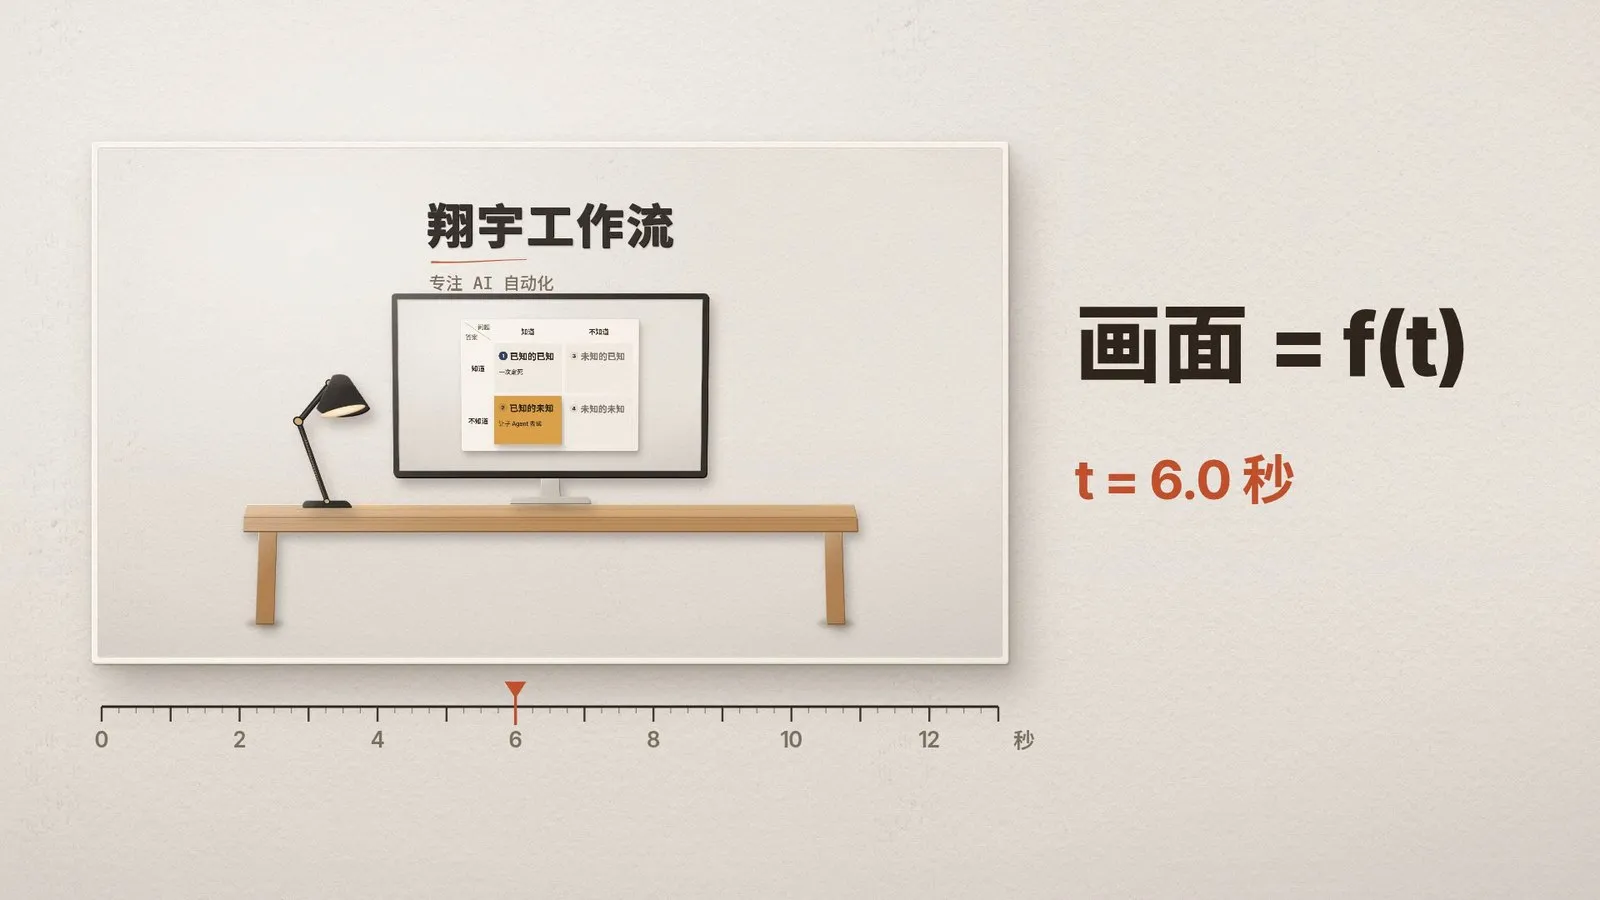
视频 1:30 · 画面 = f(t):给定时刻,算出这一帧该长什么样
一两分钟的片子,模型注意力集中,能发挥出来。三十分钟、一小时的片子,一个会话装不下:随着上下文越积越多,实际感受是模型的灵巧程度会掉到六七成。所以没法靠一段提示词剪完长视频,得有一套和 AI 协作的办法。说白了,就是管好它的输入和输出。
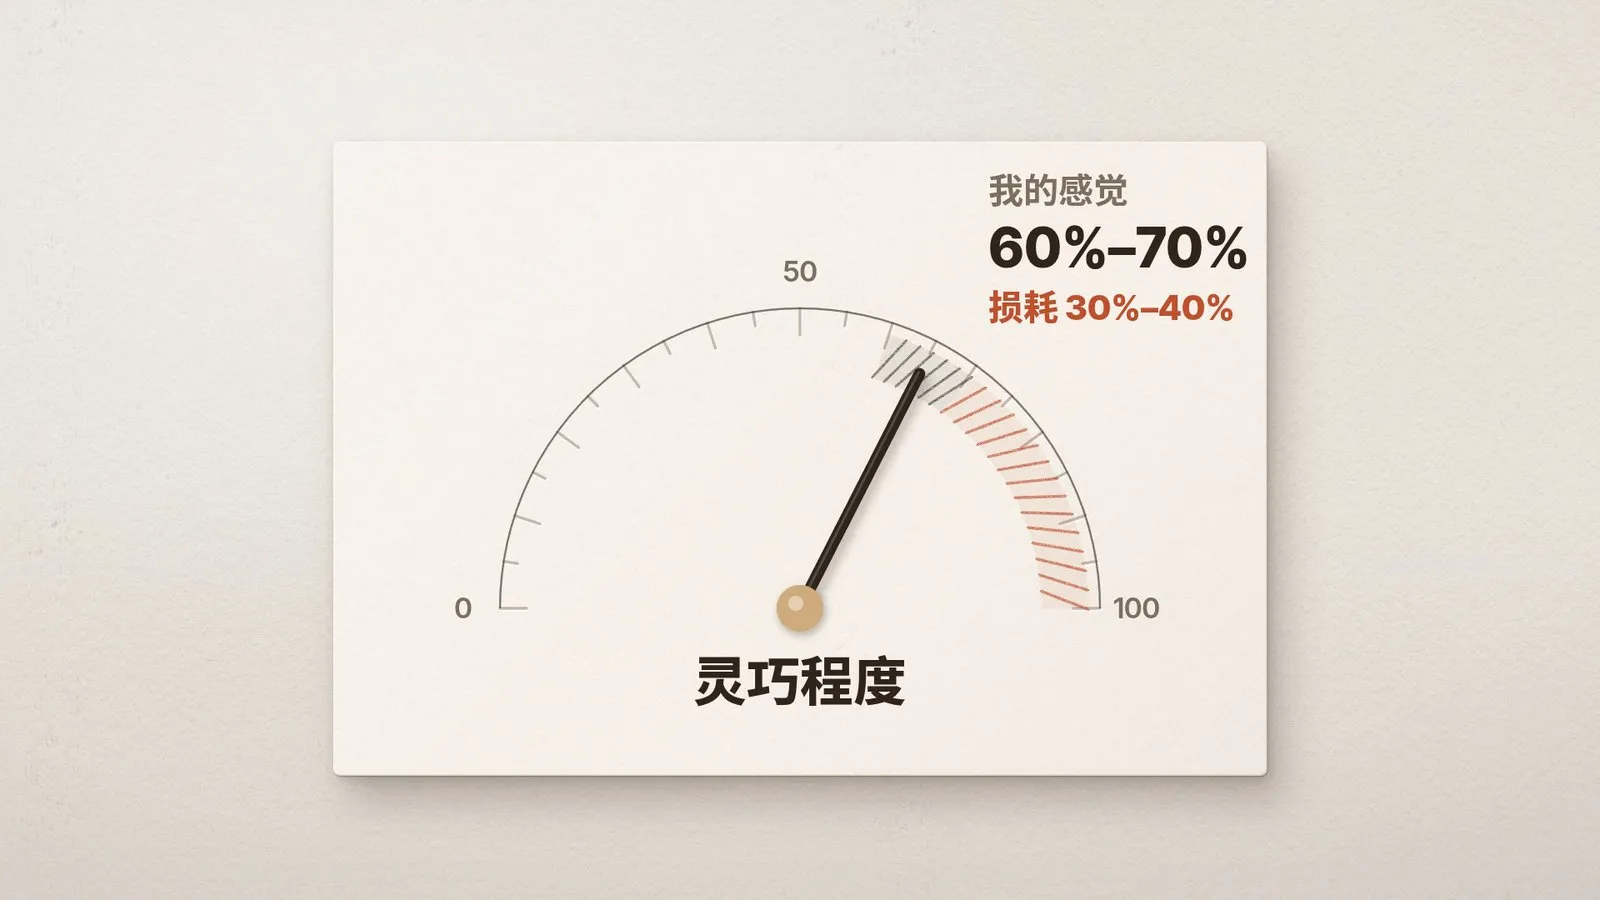
视频 4:00 · 上下文越积越多,灵巧程度掉到六七成
这套办法可以拆成三层,从下往上看:
| 层 | 是什么 | 落到剪辑上 |
|---|---|---|
| 世界观 | 框架化思维:先搭大框架和少数几条规矩,细节交给 AI 自由发挥 | 想清楚剪辑里哪些要定死、哪些交给 AI |
| 方法论 | 四类未知,也就是四个象限:哪里定死,哪里放开 | 每个象限对应一种和 AI 协作的方式 |
| Skill | 沉淀下来的流程:要定死的、要变通的、委派用的提示词都固化成文件 | 八步剪辑 Skill,每部片复用 |
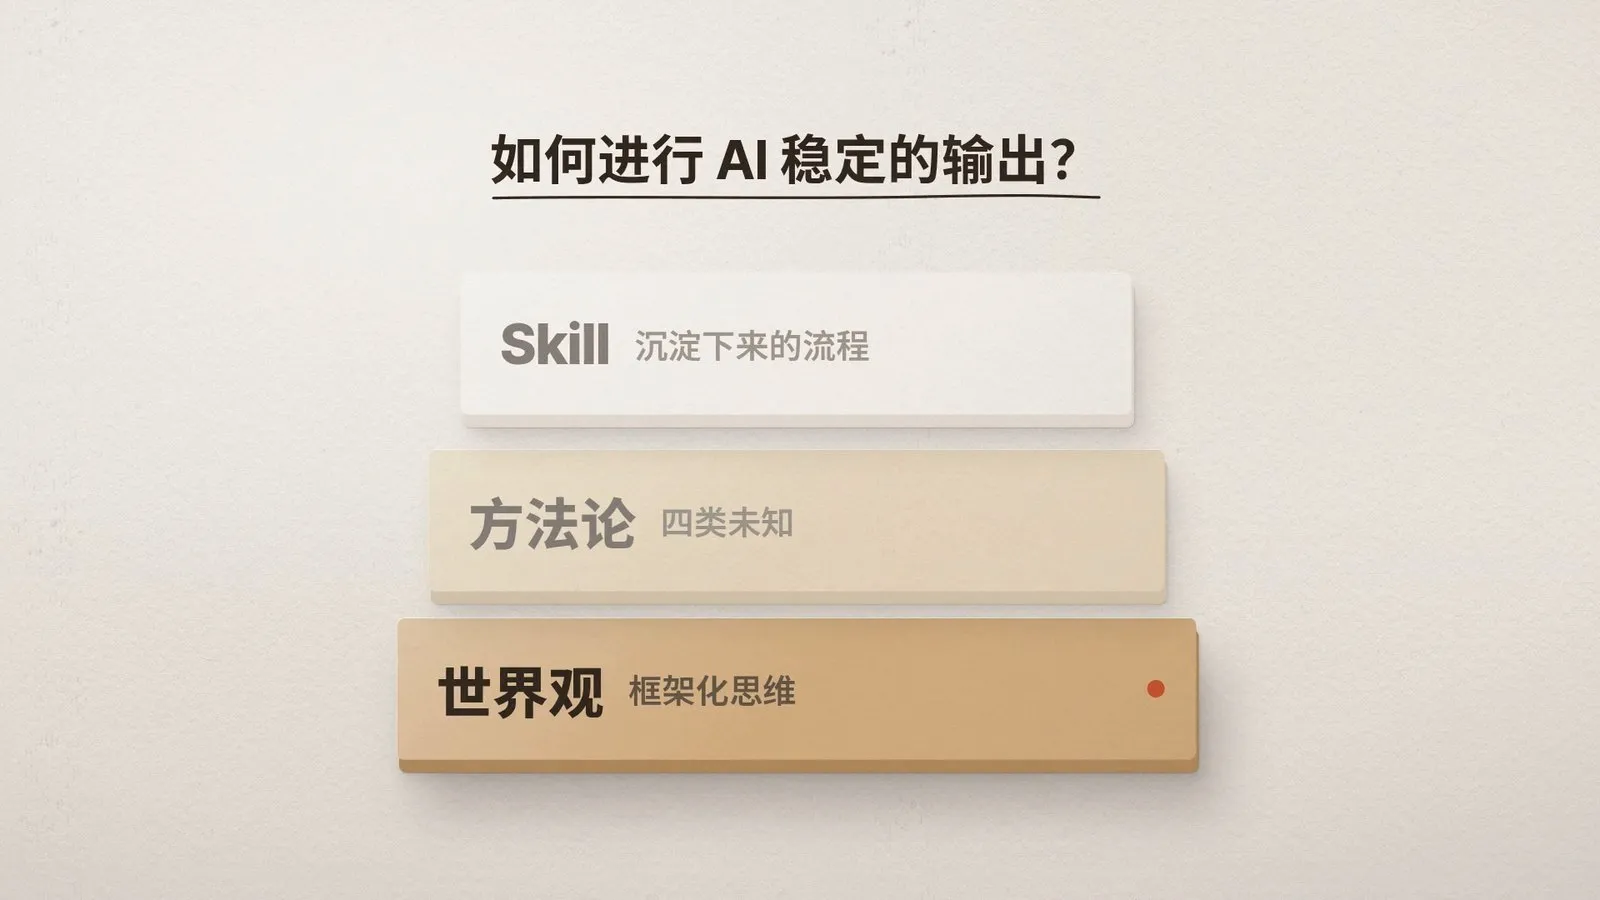
视频 4:30 · 三层框架:世界观(框架化思维)、方法论(四类未知)、Skill(沉淀下来的流程)
方法论这一层,借的是 Anthropic 在 2026 年 7 月发的一篇讲人和 AI 协作的文章:A field guide to Claude Fable 5: Finding your unknowns。文章把我们交给模型时的未知分成四类:已知的已知、已知的未知、未知的已知、未知的未知。
为什么要分清楚?用装修打个比方:我们递给装修队的是一张户型图,心里盼的是拎包入住。可户型图上不会写插座装多高、水管走明线还是暗线。图纸没写的地方,装修队只能猜。猜对了是运气;猜错了,它就退回最保守、最常见的做法。放到视频里,这种做法有个名字:AI 味儿,整部片像 PPT 一样。四个象限要解决的,就是这些没写进图纸的地方。
这套分法不只用在剪辑上,写文章、出图片、跑跨境电商的增长,凡是和 AI 协作出东西的事都能用。
两条轴切出四个象限:横轴是我们知不知道问题,纵轴是知不知道答案。
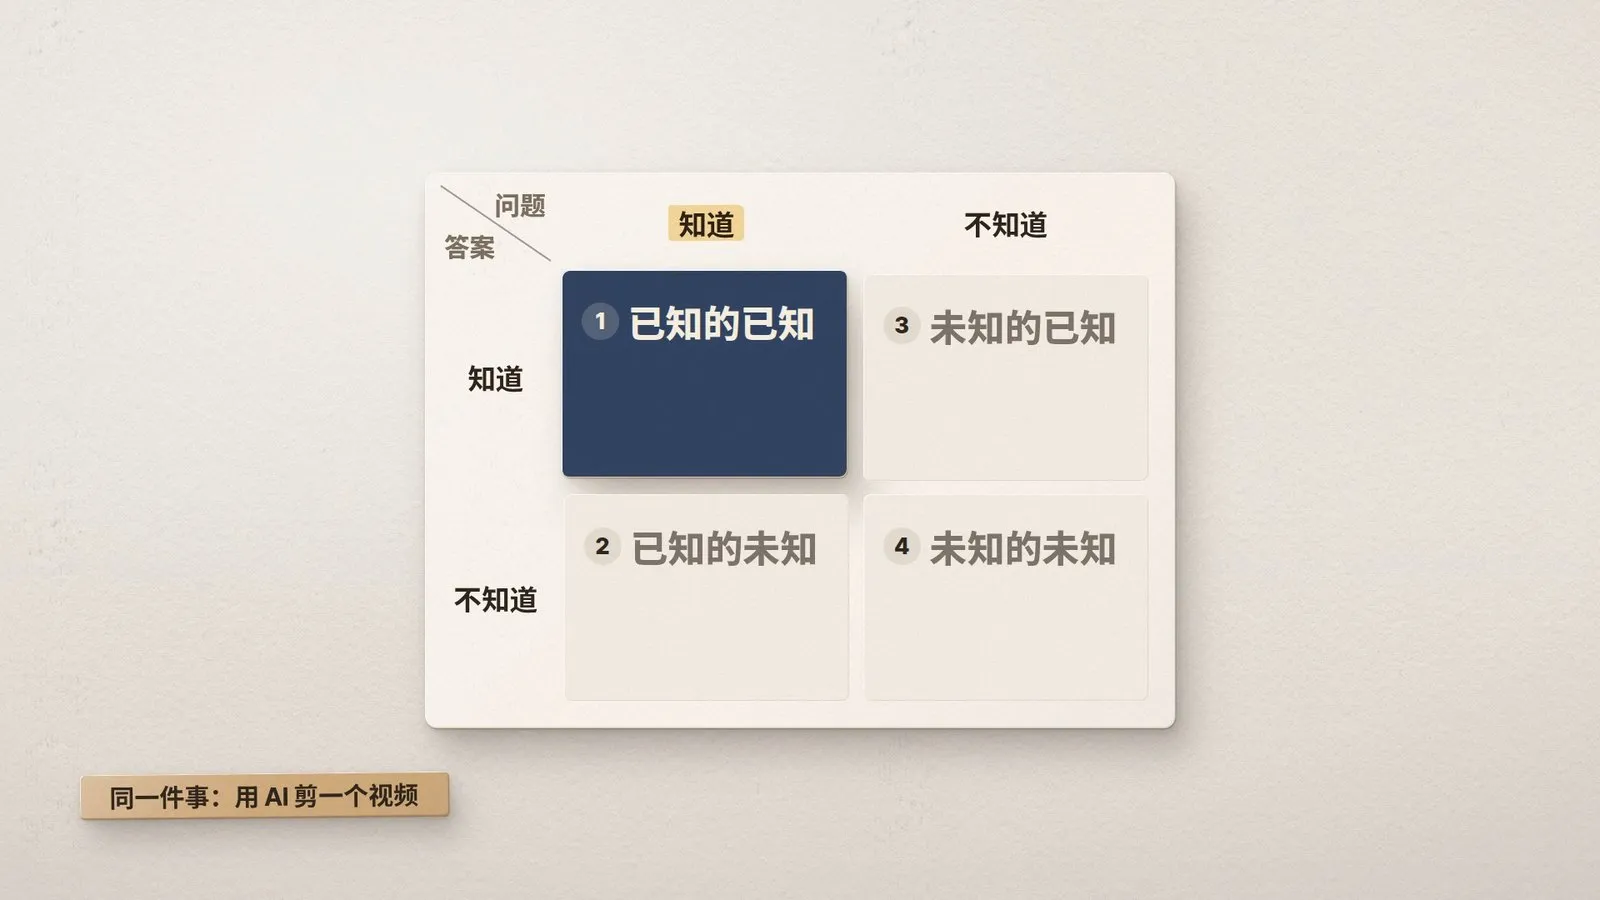
视频 7:30 · 四个象限:先看「已知的已知」
| 象限 | 大白话 | 例子 | 怎么解 | Skill 里对应 |
|---|---|---|---|---|
| 已知的已知 | 知道要什么,也知道怎么做 | 画幅、帧率、字幕不烧进画面 | 框架约束,一次定死,框架之内留出发挥空间 | 八个步骤、一页写死的规矩清单 |
| 已知的未知 | 知道想要的感觉,不知道怎么做出来 | 想要某种剪辑风格,却不知道怎么演 | 给框架、给榜样、放手去试 | 委派任务卡、样片参考 |
| 未知的已知 | 说不出来,一看就知道好不好 | 一根冰棍,放进嘴里就知道好不好吃 | 交给第三方,像观众一样看 | 看片提示词、空白会话精修 |
| 未知的未知 | 问题和答案都不知道,像在大雾里走 | Skill 做好了,不知道它哪里有问题 | 外部知识、先试剪 | 审计提示词、样帧与试剪 |
行业里早有答案的事,一次写进 Skill,以后每部片都不再讨论:画幅、帧率、旁白当时钟、字幕只做字幕轨、版权红线。这些规矩从哪来?做法是委派 AI 去检索开源项目、自媒体频道、书,总结它们都有的步骤:大家都有,多半就是业界常用的做法。八个步骤就是这么来的。
框架又不能定得太死。有两个极端:一头是约束定得非常多,每一步都写死,AI 照着一个交接一个交接往下走,出来的东西死板,一部片拖上几个月都出不来;另一头是完全放开,一段简单的提示词交出去,偶尔能剪出好片,更多时候是 PPT 那种剪法。要在约束和自由之间找到甜点区间,这就像在刀尖上跳舞。连风格都是这样定的:告诉模型这段旁白讲什么,问它适合哪些视觉风格,让它筛出候选,再看样帧挑。
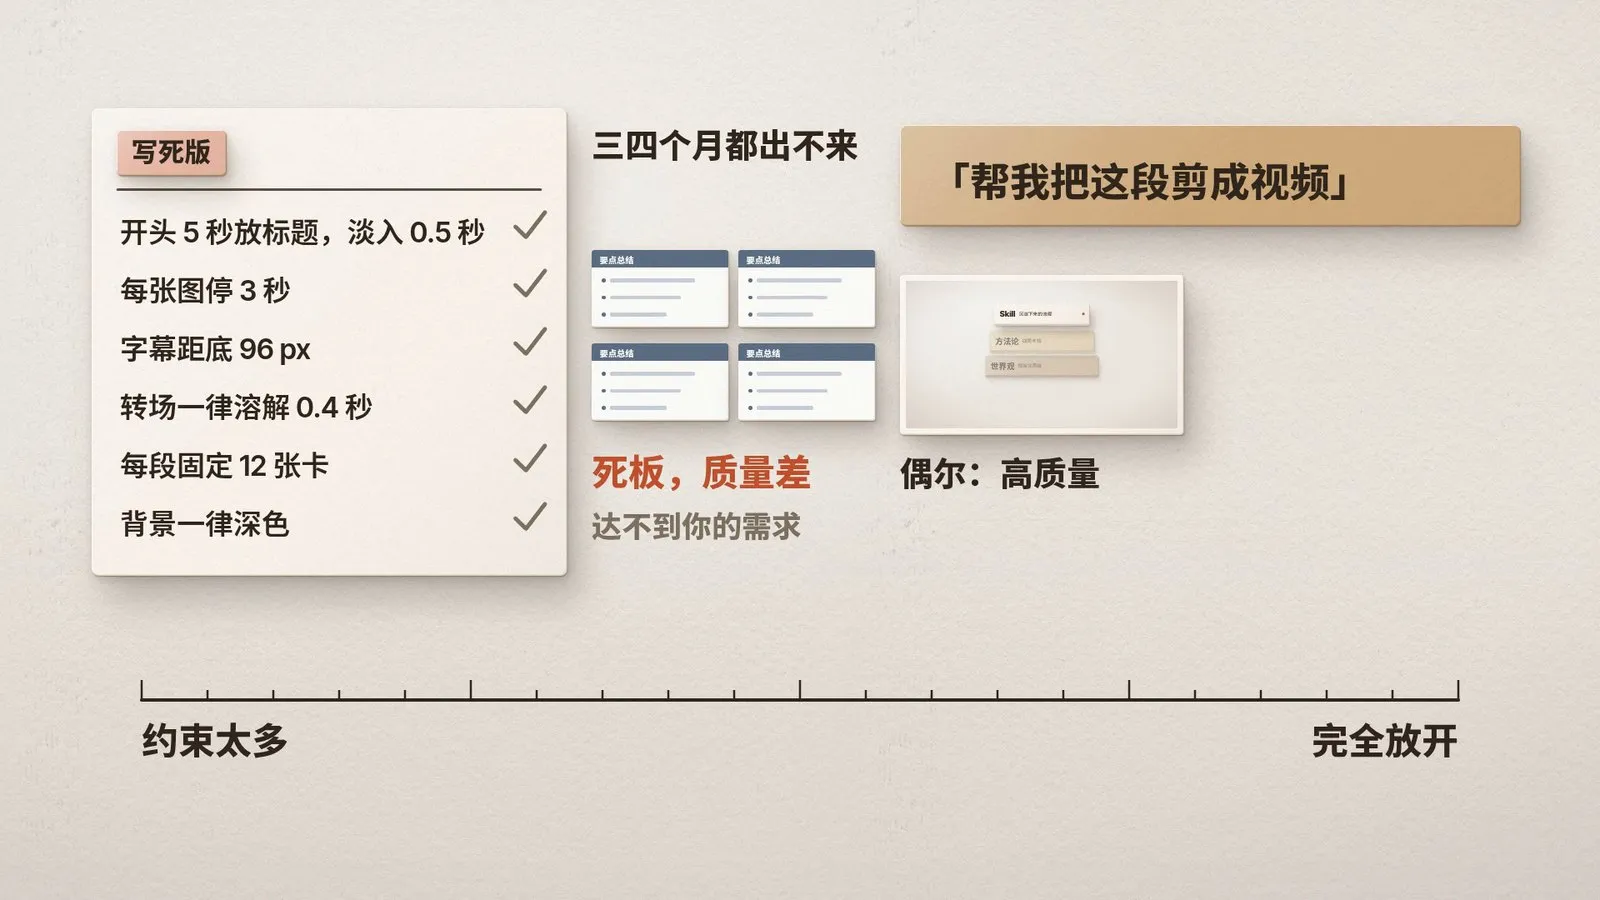
视频 18:30 · 约束太多质量差,完全放开偶尔高质量,甜点在中间
知道想要什么感觉,却不知道怎么做出来,那就让 AI 去试,我们来判断。Skill 里这一块是委派:每个分镜(时长见「分镜时长」)交给一个全新的子 Agent,交接用的任务卡是整件事成败的关键。
对比下来:一张写得严丝合缝的任务卡(分镜要淡入淡出、字幕打在底部、画面之间一定要缓动),和一张给框架不给约束的任务卡。后者剪出来的效果更好。约束条件越多,模型的探索空间越小,最后要兼顾各种约束,交出一个四不像。任务卡的完整写法见第三部分「委派任务卡」。
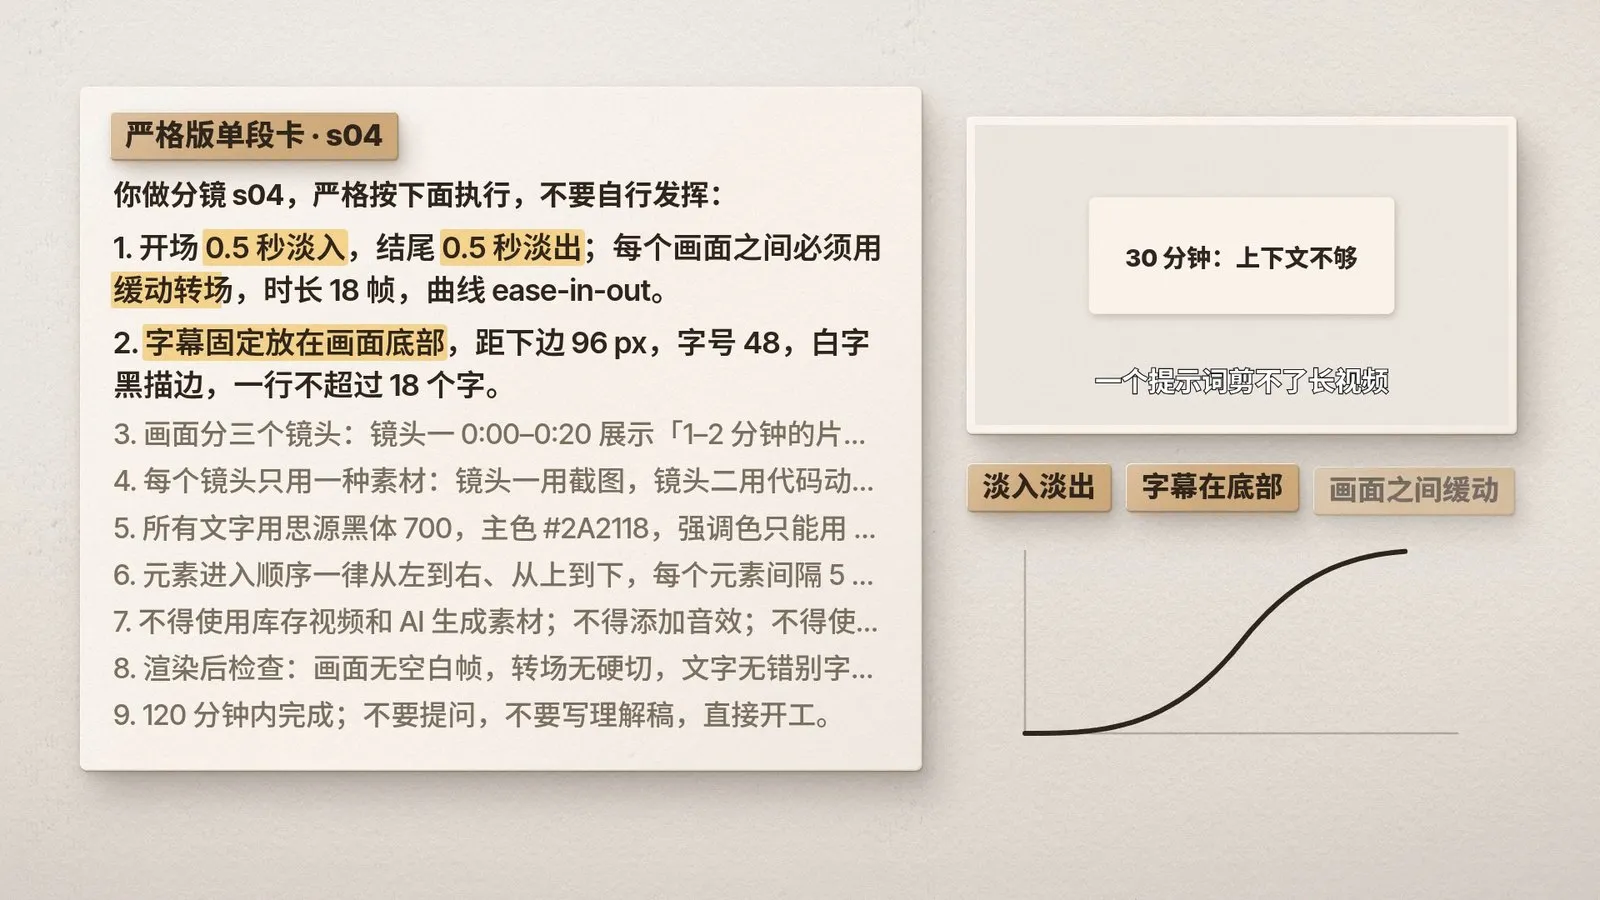
视频 19:30 · 严格版任务卡长这样:九条全写死,探索空间所剩无几
光给框架还不够,还要给榜样。可以建一个样片库:把自己欣赏的频道和视频拆开,切成分镜片段。子 Agent 要讲一组对比时,就去样片库里看这些片子怎么演对比:两张表,还是一条曲线?它学的是演法,不是长相,样片也从不剪进片子。没有现成的样片库也行:开题时给几条自己喜欢的视频,用 FFmpeg 每隔几秒截一帧、拼成一张联络表(让 Agent 写这个小脚本就行),当参考图放进任务卡。
美感是默会知识:说不出来,一看就知道。就像刚出生的小孩不知道冰棍好不好吃,放进嘴里一尝,甜,就知道好吃。
这里有一个常见的误区:AI 提议建一套十个维度的打分系统,转场、分镜、元素、缓动曲线各打一个分。结果模型写了一段函数,算元素压没压着、有几个、多大,告诉我们这部片打 90 分;拿到眼前一看,什么也不是。视频的美是一种感受,没办法打分。
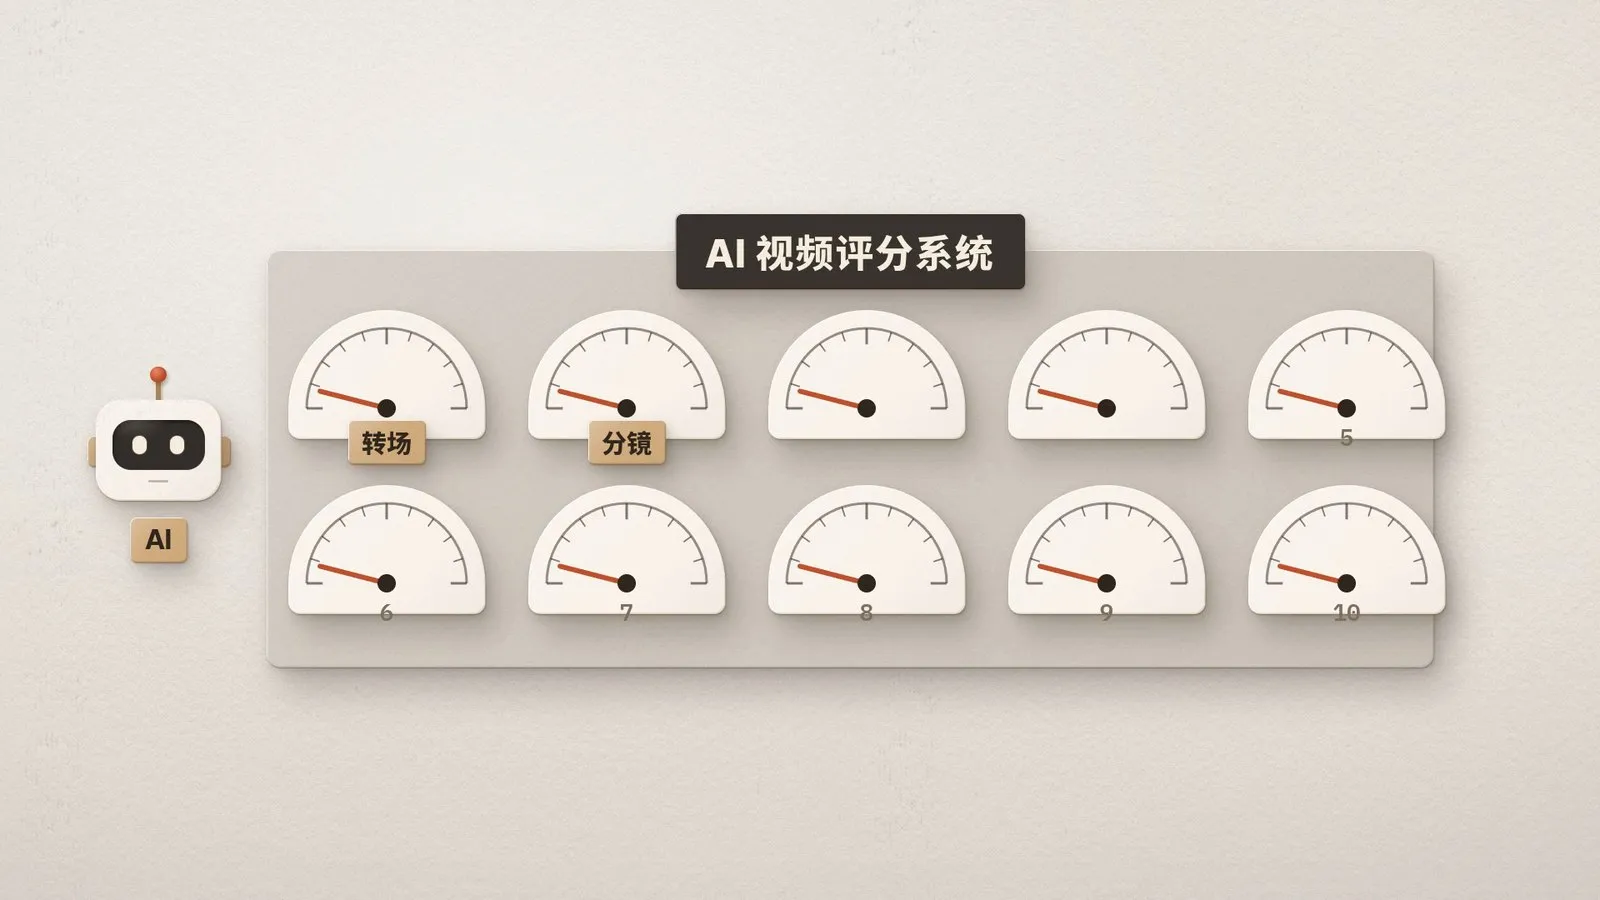
视频 22:30 · 让 AI 给视频打分:十个维度的仪表盘,看着精确,其实没有意义
解法是换人看:不让做这个分镜的子 Agent 自己判断,交给第三方。最好是一个能直接看视频的多模态模型(「看片模型」,例如 Gemini);没有的话,在 Claude Code 里新开一个子 Agent 也行。让它站在观众的角度说感受:美不美,愿不愿意看下去,哪里留白不够、元素太满,有没有穿帮和闪屏。然后再精修。看片提示词的完整版见第三部分「第三方看片」。
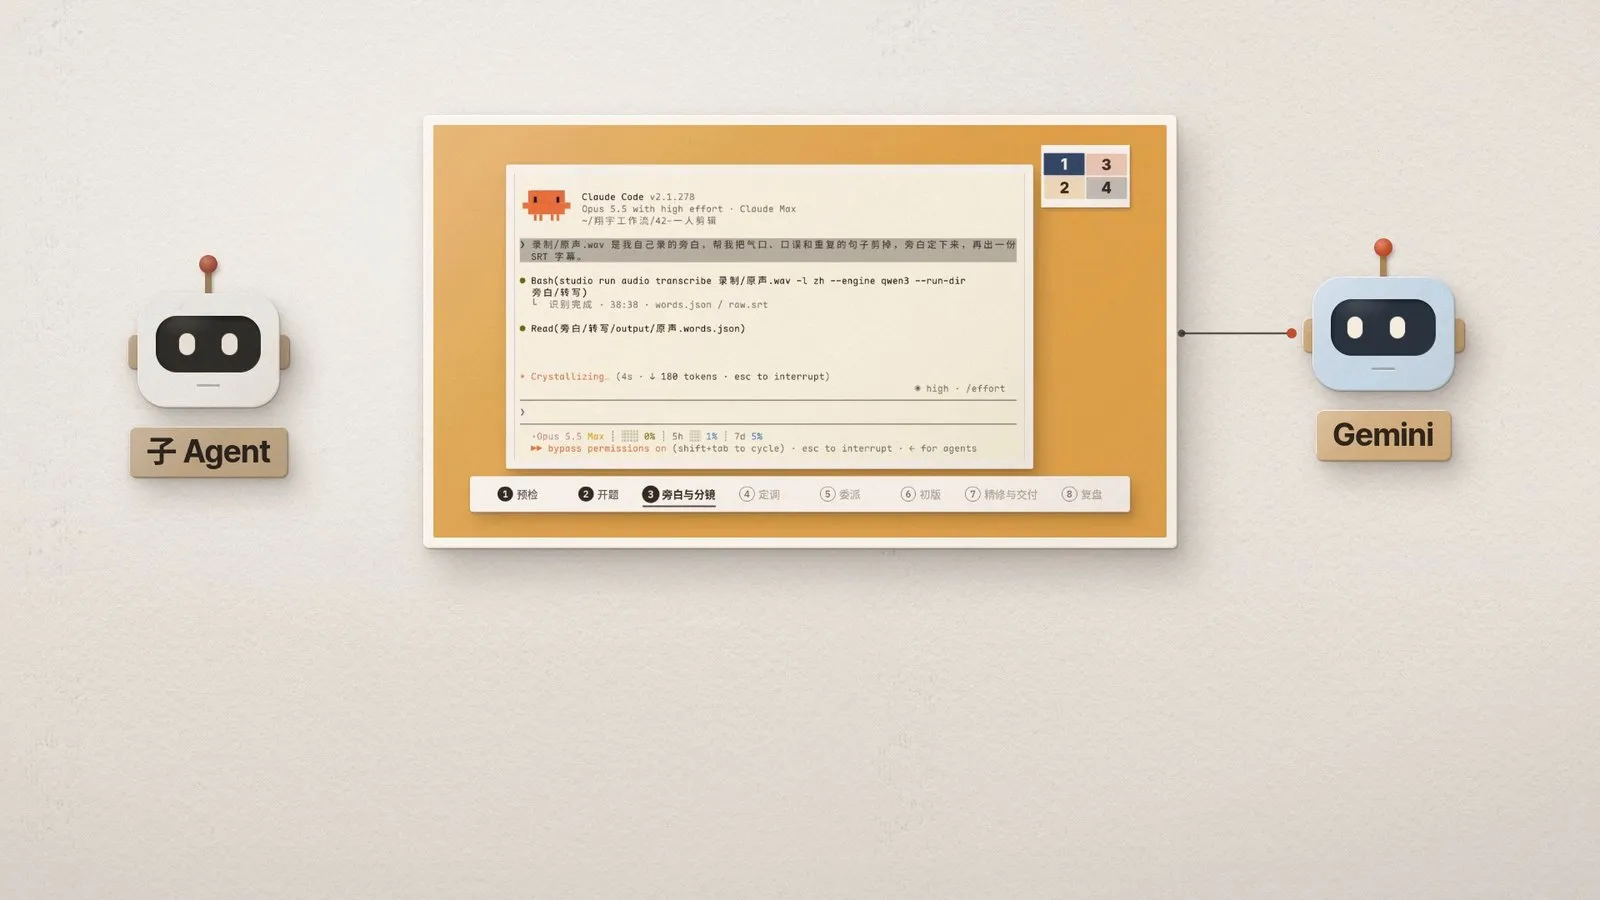
视频 23:30 · 看片交给第三方:另一个能看视频的模型
Skill 做好了,我们不知道它哪里好、哪里有问题,也不知道怎么改进。这时只能借外部的眼睛:
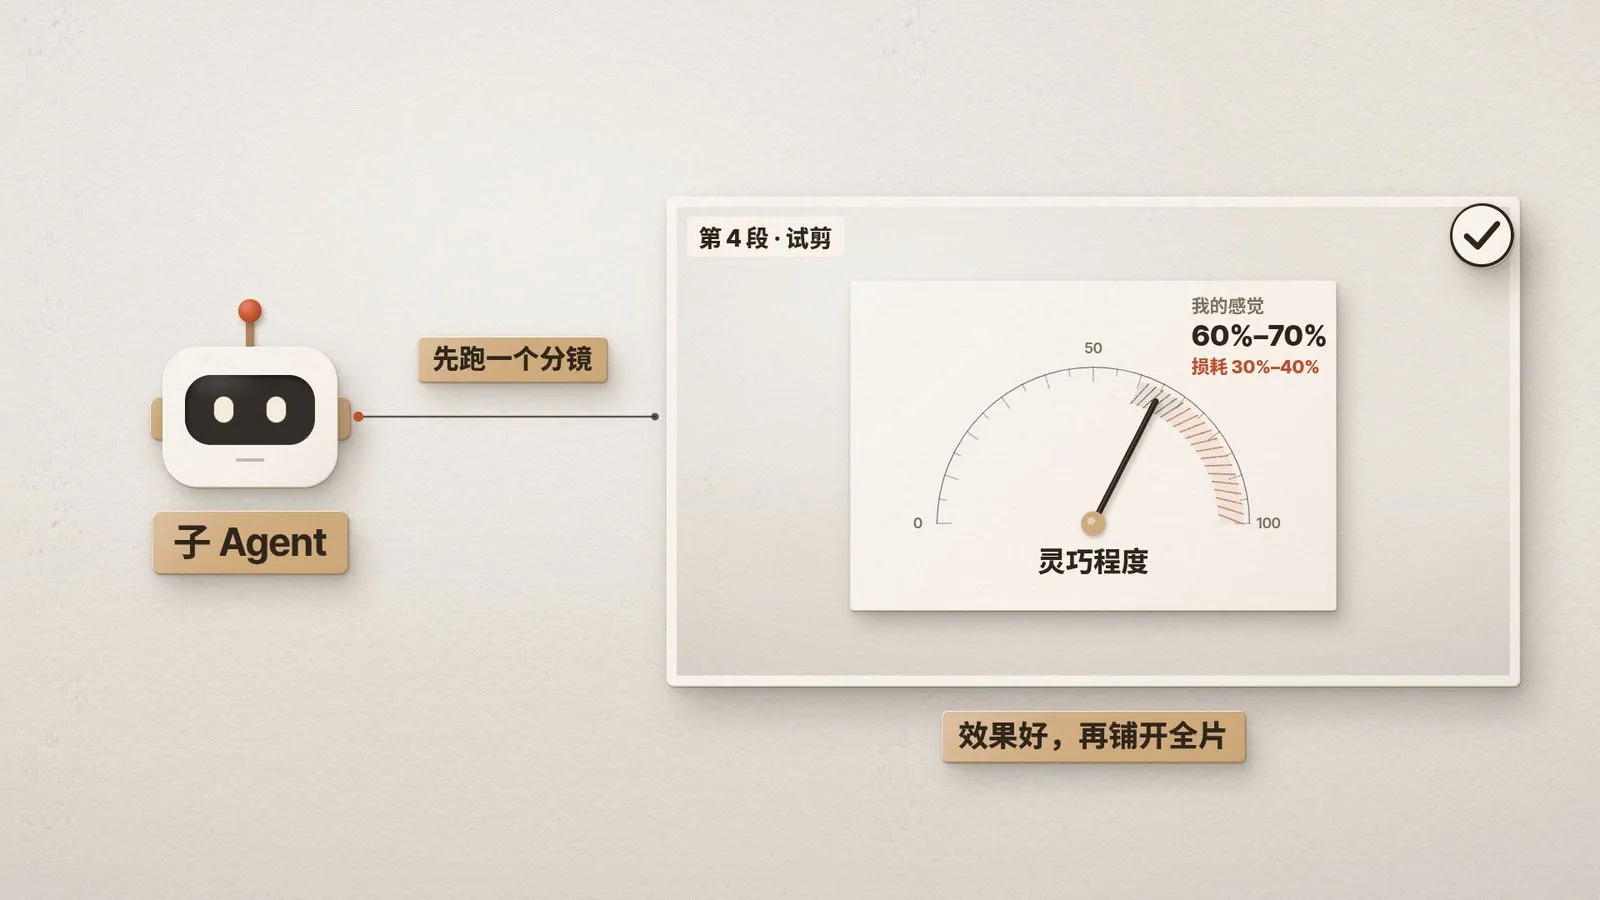
视频 26:30 · 先试剪:先跑一个分镜,效果好再铺开全片
这相当于熵增的原理:不要在一个密闭的空间里长期待着,要不断让外部信息进来,一点一点完善 Skill。审计提示词的完整版见第三部分「Skill 审计」。
claude 回车,能进到对话界面就行。可选的:本地 Whisper(自动出逐字时间)、一个能让 Agent 截图的浏览器、第二个能看视频的模型(看片用)、自己的图片和视频生成工具。要花钱的工具,Agent 用之前会先问。渲染在自己电脑上跑,不需要显卡,也不需要按量付费的接口,Agent 用的是自己的订阅。
下面这些数字和工具选择,全文只在这里定义一次,别处只写参数名。它们是经验默认值,不是规定:想改,开题时告诉 Agent,Agent 会把最终取值记进 progress.md 的「参数」一节,之后以它为准。
| 参数 | 默认值 | 为什么这样定 | 怎么调整 |
|---|---|---|---|
| 分镜时长 | 约 3 分钟 | 实测子 Agent 在这个长度上发挥得好:任务够小,上下文是新的 | 内容密度高就切短;段落意思完整更重要时,按意思就近取整,不要硬切 |
| 并发数 | 5 | 受工具限制:CLI 工具没做并发处理时,同时跑十个会报错 | 确认自己的工具在并发下稳定、额度够,就调高;额度紧或开始报错就调低 |
| 画幅与分辨率 | 16:9,1080p | 视频网站长视频的通用规格 | 竖屏短视频改 9:16;开题时定,之后锁定 |
| 帧率 | 60 fps | 动效和转场更顺;画面是时间的函数,算多少帧都行 | 渲染慢或平台不需要就用 30 fps;开题时定,之后锁定 |
| 制作工具 | Remotion + FFmpeg | 用代码导演画面,逐帧可控、可复用;FFmpeg 管转码、截帧、混音 | 其他能用代码出画面的工具(例如 HyperFrames)也行,方法不变 |
| 旁白语言 | 中文 | 本页提示词用中文写 | 换语言时同步换字体、转写模型和字幕规范;提示词里的语言一并改 |
| 运行环境 | Node.js 18+、FFmpeg、git、Python 3.11+ | 制作工具和辅助脚本的最低要求 | 以预检报告为准,版本随工具更新 |
| 推荐模型 | Claude Opus 5.5 | 见「模型与努力程度配置」 | 其他 Agent 用它们对应的最强模型和思考档位 |
| 努力程度 | 下限 Medium;主 Agent High;分镜子 Agent Medium(难的分镜 High);精修 High | 见「模型与努力程度配置」 | 预算够时主 Agent 可以更高;任何阶段不低于下限 |
| 看片模型 | 一个能直接看视频的多模态模型(例如 Gemini) | 要外部视角,故意不用做片的那个模型 | 没有就用全新的子 Agent,给它一秒一帧的拼帧图、文字稿和响度数据 |
| 审计模型 | 手上最强的一个模型,开最高努力程度 | 外部视角,找自己看不到的问题 | 有多个就各跑一次,只留一致的意见 |
| 候选风格数 | 4 到 6 个 | 太少没得选,太多挑不过来 | 按旁白的复杂度增减 |
| 分镜渲染上限 | 每个分镜最多渲染 1 次(审片分辨率) | 渲染慢又贵,靠静帧条来回审 | 渲染便宜时可放宽 |
| 实证占比下限 | 真实录屏、截图、文件等不低于全片时长的约 40% | 避免整部片只剩动画和装饰 | 纯概念类内容可调低,产品演示类可调高 |
| AI 生成素材上限 | 不超过全片时长的约 12% | 控制成本和「AI 味儿」 | 按预算和题材调整 |
| 无实证最长时长 | 连续约 20 秒没有真实实证就算太久 | 观众会觉得空 | 节奏慢的片可适当放宽 |
另外有几条是硬关口,不是参数,不随片子变:旁白和逐字时间定稿后锁定;字幕只做成单独的字幕轨,不烧进画面;开题答完之前不出画面;风格由我们选定;花钱、公开、删了回不来的事先问。
八个步骤的编号固定。手动做的话,每一步的要求就是下面的文字,可以自己存成一页笔记,让 Agent 每次开工前先读。带粗体的是要我们自己拍板的四个关口。
| 步 | 做什么 | 要我们定 |
|---|---|---|
| 01 预检 | 先把 AI 的手脚准备好:截图、生成、转写这些工具能不能稳定跑 | |
| 02 开题 | 访谈:给谁看、哪些参数不用默认值、大概多长、什么感觉,手上有哪些素材和工具 | 回答开题问题 |
| 03 旁白与分镜 | 锁定旁白,出逐字时间和字幕;按意思切分镜、按气口切小段;列点名清单 | |
| 04 定调 | 挑风格、出样帧、试剪一段;搭共用层,首段做到成片 | 定风格、审首段 |
| 05 委派 | 每个分镜一张任务卡,交给一个全新的子 Agent,一次「并发数」个 | |
| 06 初版 | 拼接、卡准音画、修衔接的小毛病和穿帮;换一个模型像观众一样看 | 看初版 |
| 07 精修与交付 | 空白会话精修整片;成片、字幕轨、章节、素材出处 | 最终放行 |
| 08 复盘 | 观众怎么看的;这次的经验微调进 Skill |
01 预检。 真正剪片的是子 Agent,工具没准备好,它就会跳过。常见的教训:默认截图工具是好的,结果子 Agent 遇到截图出错就跳过去,自己演绎画面,片子里几乎没有网页截图,看着就单调。所以开剪之前,先确认每个工具真能跑。过关标志:预检报告里必需的工具都在;可选能力缺了的,都写了替代办法。
02 开题。 一次访谈,把总框架定下来:哪些参数不用默认值(画幅与分辨率、帧率、分镜时长等),要给观众什么感觉。Agent 根据答案配置工程的参数。访谈答完之前,不出任何画面。
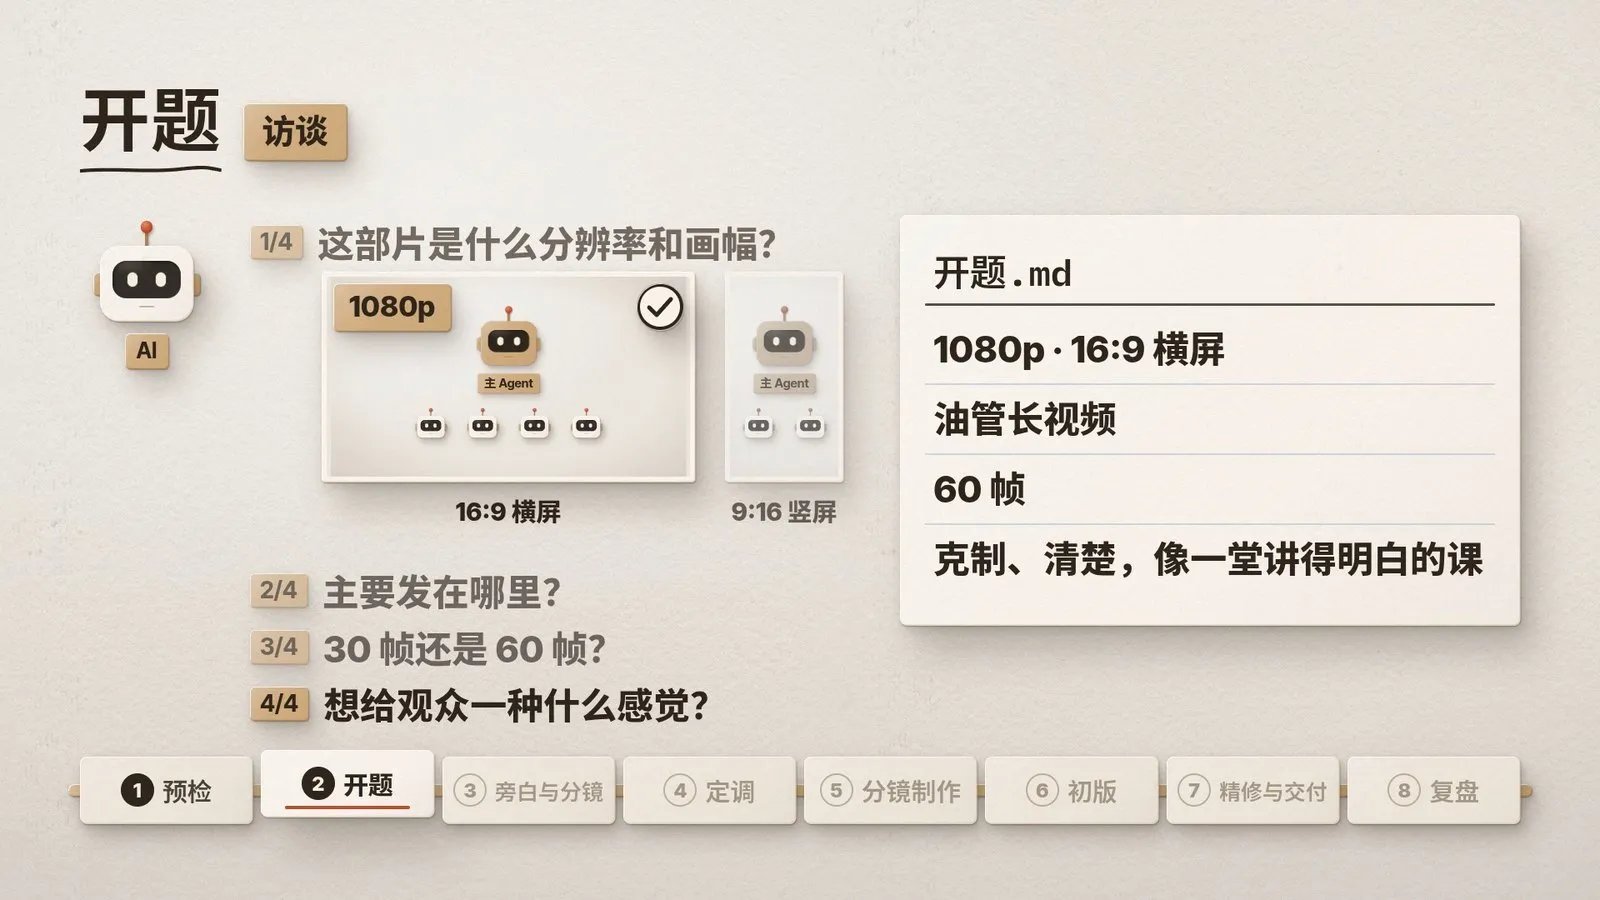
视频 12:30 · 开题访谈:四个问题问完,答案落成 开题.md
03 旁白与分镜。 全流程最核心的一步。一部片有旁白和画面两条主线,旁白这条先定死:自己录的音频剪掉气口、口误和重复的句子,定稿后生成逐字时间和 SRT 字幕。画面上每个动作都挂在字上,AI 剪的时候才知道哪个画面卡在哪个字。旁白改一个字,后面的时间轴全跟着动,所以这一步不定好,后面的画面没法动。然后按意思切分镜,每个约一个「分镜时长」;分镜里再按气口切小段,一个气口是一句话或者一小段意思。
04 定调。 一部片一种风格,而且是我们和模型一起决定的,不是从现成的里直接套。详细做法和提示词见第三部分「定调」。
05 委派。 用一张委派任务卡把每个分镜交给子 Agent。按「分镜时长」切,全片时长除以它就是分镜数,也是子 Agent 数;一次同时跑「并发数」个。开并发之前,确认自己的工具在并发下不报错。只要额度和时间够,再长的片子也一样做。
06 初版。 分镜都回来以后拼成初版,卡准音画,修前后衔接的小毛病和穿帮。然后换一个模型像观众一样看一遍。
07 精修与交付。 初版之后,开一个全新的空白会话精修整部片:好的地方不动,不好的地方在所有出现的地方一起改。交付成片、单独的字幕轨、章节和素材出处。
08 复盘。 每次和 Skill 协作都会攒下一点小经验,把它微调进对应的那一步,下次避免同样的问题。
在片子的文件夹里让 Agent 跑一遍预检(第 01 步),然后从开题访谈(第 02 步)开始。这一页之后的所有步骤,都在这个文件夹里做。
先给新片建一个空文件夹,在终端里进到这个文件夹,再启动编程 Agent(Claude Code 输入 claude 回车)。启动前确认模型和努力程度符合推荐配置(见第二部分「模型与努力程度配置」)。把下面整段粘进去,回车。
工作目录:我这部新片的文件夹。先运行 pwd 给我看,再动任何东西。

我要剪一部口播讲解视频,旁白文件:{{旁白文件路径}}(还没有的话告诉我,先不动手)。参数以 progress.md 的「参数」一节为准,没有的话按教程「默认参数一览」的默认值。分两步,一步一步来。

第 1 步,预检:检查这台机器上「运行环境」和「制作工具」能不能用;能不能打开浏览器截图;能不能转写出逐字时间(Whisper 或别的办法);有没有图片、视频生成工具。列成一张表:必需的缺了怎么装,可选的缺了有什么替代办法。没经过我同意,不要自己装东西,不要花钱。

第 2 步,开题访谈:预检报告贴给我之后,一次把这些问题问完:这部片给谁看、他们为什么会点进来;画幅与分辨率、帧率、分镜时长、并发数这几个参数要不要改成别的;大概多长;要给观众什么感觉;我手上有哪些素材和工具;有没有几条我喜欢的视频可以当参考。我答完之前,不要出任何画面。

把预检结果和我的回答记进 progress.md,之后每做完一步更新一行。
这段提示词浓缩了第 01、02 步的要求。答完开题问题以后,接着做第 03 步:旁白定稿、出逐字时间和字幕、切分镜,再按第 04 步定调(见第三部分「定调」)。
Agent 贴出了预检报告;接着开始问开题问题,而且没有先出画面。片子文件夹里有一份 progress.md,每做完一步更新一行。
这一节是推荐配置,不是唯一可行的选择。推荐的模型是 Claude Opus 5.5,努力程度下限是 Medium:剪片的每个阶段都用同一个模型,任何一步都不要低于这个下限。只有「看片」和「审计」两步,故意换一个别的模型来提供外部视角。用别的 Agent 的话,对应换成它最强的模型和相应的思考档位,分工不变。
| 谁 | 推荐配置 | 为什么 |
|---|---|---|
| 主 Agent(开题到委派) | Opus 5.5,High;预算够可以 Max | 决定不多,但每个都影响整部片:分镜、风格、任务卡 |
| 分镜子 Agent | Opus 5.5,Medium;特别难的分镜用 High | 很多个同时跑,每个任务小、上下文新,Medium 就够,额度也撑得住;但不要再往下降 |
| 初版拼接 | 主会话,不低于 Medium(一般保持 High) | 拼接、混音、对时间大多是机械的工作,但接缝上的小毛病要看得出来 |
| 精修(初版之后) | 全新的空白会话,Opus 5.5,High | 空白上下文第一次看整部片,最容易找出共性问题 |
| 看片、审计 | 另一个强模型,用它能开到的最高档 | 这两步是要外部视角,故意不用做片的那个模型 |
最关键的一条经验:不要用一个 Max 会话从头剪到尾。实测中,把整部长片的旁白一开始就交给一个 Max 会话,效果并不好:上下文被压缩得很厉害,模型没法发挥。所以 Max 只留给主 Agent 在预算够的时候用;初版之后换一个空白的 High 会话精修,才是有效的组合。
在 Claude Code 里,会话的努力程度用 /effort 调;子 Agent 的努力程度写在它的定义文件里(effort 字段):分镜子 Agent 写 medium,精修子 Agent 写 high。
Claude Code:
effort 字段):https://code.claude.com/docs/en/sub-agents做片用到的:
这一页不替我们选风格,只讲怎么选。做法分四步:
风格是参考世界,不是紧身衣。风格卡规定的是这部片的气质和边界,边界之内怎么演,由子 Agent 自己设计;风格一部片可以定,但每个分镜的演法是不同的,要在同一风格之上做变化,整部片才不单调。第一步可以这样对 Agent 说:
下面是这部片定稿的旁白:{{旁白文件路径}}。先读完。
然后告诉我:它适合哪些视觉风格?给我「候选风格数」(参数)个候选,每个写清楚适合的理由和主要风险。
等我选定两三个以后,再为每个出一张样帧(同一句旁白、同一个画面),先别开始剪。
候选风格没有标准清单,让模型根据旁白提;想有个起点,常见的方向有:亮面演示(浅色明亮、偏产品和界面演示)、暗场终端(深色底、偏命令行和工具类内容)、手绘白板(手写笔触、偏概念和推导)、扁平图解(色块和图标式的平面图示、偏流程和对比)、杂志版面(大标题和留白的版式、偏观点和叙事)。这些只是方向,不是标准答案;上面四步照样适用于自己的风格。
第 05 步把每个分镜交给一个全新的子 Agent。交出去的就是这张任务卡:目的、风格、为谁服务、手上的工具和素材、可以学的样片、几条红线。它从不说画面怎么演。手动做的话,主 Agent 照着下面这张填好的完整例子,给每个分镜各写一张。
不用手动粘。主 Agent 把卡存成 briefs/{{seg}}.md({{seg}} 是分镜编号),再告诉子 Agent「读 briefs/{{seg}}.md,照着做」。没有子 Agent 的话,新开一个对话,把整张卡贴进去。
下面是一张填好内容的示例卡:内容取自一部讲知识库怎么搭的片子里的一个分镜,讲为什么一个大文件夹不灵。示例内容换成自己片子的;花括号里换成自己的值({{seg}} 是分镜编号,其余参数名对应「默认参数一览」);风格已经按前面「定调」选定,用 {{风格名}} 代替,换成自己定下的那一个。气口表只留了前三行,真正的卡里是全部气口。
做一部讲解片里的一个分镜:词 {{词范围}},{{起止时间}},{{气口数}} 个气口。
你是这个分镜的分镜子 Agent,也是它的设计者。目标是让观众看懂这一部分、还想接着往下看,而且看起来像一个有品味的人专门为这段旁白做的,不像 PPT。授权:点子、演绎方式、分镜内部的节奏、录哪些真实素材、用哪些开放授权的素材,都由你决定;素材不够可以上网检索。以下几件事先停下来问:任何花钱的事、任何公开的事、任何撤不回的事、任何对锁定项或共用层的改动。
报告写到 `reports/{{seg}}.md`;你最后的回复只写结论,最多五行。

## 你手上有什么
- 背景:整篇旁白(`briefs/whole-script.md`,每个分镜都标好了)和 `plan/context.md`。
- 主题:这是一部讲知识库搭建的视频。这一段讲的是,知识库一股脑堆在一个大文件夹里,交给 Agent 去读的时候为什么就不灵了,以及应该怎么办。
- 风格:我的主题风格是{{风格名}},写在 `plan/style-sheet.md`;你在这个风格里面自由发挥。锁定的那几样东西在 `plan/lock-list.md`。
- 为谁服务:你要服务于这部视频的留存,站在观众的角度来设计里面的元素、分镜和演绎方法。看这一段的人,多半自己就这么干过,一看就能认出自己那堆乱摊子。要让他看完这一段明白为什么不灵,而且有欲望看下去,想知道到底怎么才行。
- 原则和硬性约束:`plan/lock-list.md`、`plan/style-sheet.md`、*quality-standard*。
- 工具:我有 `app/` 里的工程({{制作工具}}),有浏览器可以截图、录屏(见 `handoff/01-preflight.md`);这台机器上没有 AI 图片生成和 AI 视频生成。
- 素材:我的素材有不少,素材池、点名的东西和实证下限都在下面。素材不够,你可以去互联网上检索。
- 样片库,用来学别人怎么演绎,见下。样片库里的东西永远不进片子。
- 锁定的:只有锁定清单里列的那几样。其余都归你。

## 怎么做
1. 理解。设计任何东西之前,先在报告最上面写下你对这个分镜的理解:它从上一个分镜接过来什么,要交给下一个分镜什么,要替观众回答的核心问题是什么。
2. 构思。每个气口,或者你决定合并的每一组气口,找两三个真正不同的点子:换隐喻、换素材来源、换视角或换尺度,而不是换颜色。学参考片段怎么演绎一个时刻,不学它们长什么样。旁白点到真东西的地方,观众看到的就得是真东西。每个点子画一张草图,挑一个,写下为什么。第一个冒出来的点子通常最平庸。
3. 制作。先静帧后动态。做完整个分镜,用当前代码重新生成一条静帧条来审,每一轮用同样的帧号,然后把最没记忆点的三个时刻换掉。最多渲染一次。同一个问题修了三次还不行,就记成薄弱点,往下走。

## 开工前必读
读完这些,在报告的"文件"一块里每个文件写一行。斜体的名字是本 Skill references 目录下的文件:*quality-standard* 指 `<skill-folder>/references/quality-standard.md`。

| 文件 | 章节 | 为什么读 | 读完要能回答 |
|------|------|----------|--------------|
| `briefs/whole-script.md` | 全部 | 整部片子的主线 | 上一个分镜留给观众的是什么?你的分镜要往下交什么? |
| `plan/lock-list.md` | 全部 | 哪些不能改 | 哪些是锁定的,哪些归你? |
| `plan/style-sheet.md` | 全部 | 你在这个风格里面工作 | 背景、色板、字体、入场出场的约定各是什么?"不要"清单里有什么? |
| `plan/shared-notes.md` | 全部 | 首段定下了你要达到的标准 | 这个标准用文字怎么描述? |
| *quality-standard* | 怎么看;十二节 | 你的分镜要拿它来评判 | 十二个方面里哪三个最可能拖累这个分镜? |
| *review* | 看定帧看什么;找更好的点子 | 你拿它审自己的静帧条 | 对一条静帧条要问哪三个问题? |
| *materials* | 点名的东西必须是真的;从旁白规划素材配比 | 动画之外,画面上还放什么 | 你这段话里落了哪些点名的东西,每个必须以什么真实形式出现? |

## 本分镜
看完这个分镜,观众要明白:Agent 拿到一个大文件夹,不是读得不够仔细,而是手里没有地图;所以答案是结构(一个文件只回答一个问题,再配一份索引),而不是塞更多的文字。
观众的感受:从"这不就是我的文件夹吗"的会心一笑,到"原来这能治"的松一口气。
怎么推进:熟悉的乱摊子,Agent 拿到它实际上在干什么,失败的实证,转向结构。

| 气口 | 开始 | 词 | 句子 |
|---|---|---|---|
| {{seg}}-b01 | {{开始时间}} | {{词范围}} | [concept] 大多数知识库,一开始就是一个文件夹,到最后也还是一个文件夹。 |
| {{seg}}-b02 | {{开始时间}} | {{词范围}} | [operation] 你打开 Agent 要读的那个文件夹,数一数里面到底有什么。 |
| {{seg}}-b03 | {{开始时间}} | {{词范围}} | [evidence N07] 这是一个真实的例子:四百个文件,其中九个都叫"笔记"。 |
| ... | | | (后面还有其余气口) |

入场:空舞台。出场:空舞台。
主讲人:角落,由分镜子 Agent 决定。
这段内容最大的风险:论证分三层(乱、为什么乱、怎么治),很容易在一张文件夹的图上停太久。

## 本分镜的素材
素材池:示例里是一段文件夹录屏和一张检索日志截图,都列在 `plan/materials.md` 里。
你的气口里点名的东西:N07(一个真实的、有 400 个文件的文件夹:文件夹列表的真实录屏)和 N08(Agent 真实的检索日志)。每一个都必须以真东西出现在画面上。
整部片子里,真实实证至少占时长的 {{实证占比下限}},AI 生成素材最多 {{AI 生成素材上限}},画面上不能连续超过 {{无实证最长时长}} 没有真东西。素材不够就上网检索(开放授权,记下来源和授权),或在上限内生成;任何花钱的事,停下来问。版权红线:不用流行歌曲、电影片段、其他频道的视频画面,不用 NC、ND、SA 授权或没写授权的素材。

## 参考片段
学它们的演绎(运动、时机、结构),不学它们的长相。
- `library/sheets/clip-04.png`,0:41:一堆杂乱怎么变成有序的一组(整理的那一下)。
- `library/sheets/clip-09.png`,1:12:前后对比怎么放进同一个画面。
- `library/sheets/clip-11.png`,0:20:怎么让观众感觉到专家在读一长串清单,又不用观众自己去读。
- 讲失败本身的那几个气口:自己设计。

## 要交回什么
写 `reports/{{seg}}.md`,一屏能看完,按这个顺序分块:结论("已自检,待评判");给下一个 Agent;原则怎么落实的;我的判断;细节(理解、试过的点子和选择、最早的草图、静帧条、素材及来源和授权、声音时刻);薄弱点与待定;文件(开工前必读每个文件一行,说你现在知道了什么;产出和最后一次提交);自检(第一行"开工前必读已读 x/y")。

## 环境与额度
- 只在你自己工作区的 `app/src/segments/{{seg}}/` 里工作(分支 `segment/{{seg}}`)。共用层只读。
- 额度:同时有 {{并发数}} 个分镜子 Agent 在跑;你的努力程度是 {{分镜努力程度}};最多渲染 {{分镜渲染上限}} 次,审片分辨率;分镜里不放音效或音乐轨(把声音时刻列出来:词、帧、事件)。
- 如果有纠正,写在 `briefs/{{seg}}-notes.md`。每做完一个气口看一眼。
- 以下几件事先停下来问:付费生成、发布、删除或覆盖不属于你的东西、改动锁定项。停下来时,交回已经做好的部分,并在报告最上面写"暂停:等待 X"。

读开工前必读和这张任务卡,然后写下你对这个分镜的理解。想清楚再动手。然后做完整个分镜,交回来。
卡里提到的 plan/、briefs/、reports/ 文件夹,是主 Agent 在前面几步存下来的:整篇旁白、分镜表、风格卡、锁定清单、素材清单。手动做时按需建同名文件。斜体的 quality-standard、review、materials 是 Skill 的参考文件名;手动做的话,把「怎么算好」「怎么审静帧」「旁白点名的东西必须用真东西」这三件事各写一小段,存进 plan/,再把「开工前必读」表里对应的几行换成自己的文件名。
开头三行:身份和授权。 先说这是谁的任务、要做到什么程度(让观众看懂、想接着看、不像 PPT),再把决定权交出去:点子、演法、节奏、用什么素材都由它定。最后一句划出要停下来问的事:花钱、公开、撤不回、动锁定项。授权写清楚,它才敢放手去试。
你手上有什么:只写感觉和家当。 这一块只写:风格是一个已经定好的风格(换成自己定的),说清片子讲什么,要服务于留存、站在观众的角度,素材不够就上网找,手上有哪些工具。注意它说的是一种感觉和一个目的,不说文件夹怎么画、东西从哪进场、用什么缓动曲线。
怎么做:三步,但不规定画面。 理解、构思、制作。构思那一步要求每个气口出两三个真正不同的点子,因为第一个冒出来的点子通常最平庸;制作那一步要求先静帧后动态,收尾时把最没记忆点的三个时刻换掉。这些规定的是工作方法,不是长相。
开工前必读:每个文件配一个问题。 读完要能回答的问题写在表里,子 Agent 就不会只扫一眼标题。
本分镜:观众要明白什么、感受到什么。 写目标和感受,外加一句这段内容最大的风险,不写怎么画。气口表给出每句话的开始时间和词的编号,画面就挂在这些字上。
素材和参考片段:真东西和榜样。 旁白点到的东西必须以真东西上屏(真实录屏、真实日志),实证要占一定比例;参考片段只学演法,不学长相,没有合适的就写「自己设计」。
环境与额度:只在自己的工作区里工作。 分镜之间互相看不到画面,这是有意的:看到了,不是照抄就是刻意避开,整部片会越来越像。努力程度按推荐配置写(分镜子 Agent 默认 Medium),比主 Agent 低一档。
发出去的卡里没有残留的 {{ 占位符;从头到尾找不到「淡入」「推近」「居中」「缓动」这类规定形式的词;子 Agent 交回的报告第一块是它对这个分镜的理解,最后一块写着「开工前必读已读 x/y」。
briefs/{{seg}}-notes.md,不要给正在跑的子 Agent 发消息。第 06 步初版拼好以后,交给一个没做过这部片的看片人(「看片模型」),让它像观众一样从头看到尾,说感受,不打分。第 04 步的首段和第 07 步的终版,想多一双眼睛时也可以用。
按这个顺序挑看片人:另一个能直接看视频的模型,把审片版视频整个给它;没有的话,开一个全新的子 Agent,给它一秒一帧的拼帧图、文字稿和响度数据;再不行就新开一个对话。绝不用做片的那个对话。把占位符填好,代码块里的内容整段贴过去。
<role>
你是一名观众,不是剪辑师,也不是设计师。你是下面描述的那类观众中的一员,第一次看这部片。片子不是你做的,你也不负责修。你的任务是老老实实说出看这部片是什么感受。
</role>

<film>
标题:{{film_title}}
承诺(封面和标题告诉观众的东西):{{promise}}
观众:{{audience}}:{{他们已经知道什么、为什么会点进来}}
时长:{{minutes}} 分钟。这是{{初版 / 终版 / 单个分镜}}。
文件:{{video_file_or_contact_sheets}}
文字稿(用来核对说的和画面上展示的是否一致):{{transcript_path_or_none}}
</film>

<how>
1. 像观众一样,从头到尾完整看一遍。看的时候不要停下来记笔记。如果你只能看到帧,就按顺序一张张看,把每一秒当作时间往前走了一步。
2. 看完后,按下面的几个部分,用平实的句子写回答。描述观看的体验。不要打分、评级、给等级、给百分比,也不要列维度表。如果发现自己在用一个数字下判断,改成用话说。
3. 用时间码(m:ss)指出具体时刻,方便别人去看。用一个短语说明那一刻你看到或听到了什么。
4. 只说你确定感知到的东西。拿不准某处是故障还是故意的,就直说拿不准;描述不出来的缺陷不要下断言。你看到的是抽出来的帧,所以不要把「跳了」「卡住了」当事实报告,要说「m:ss 前后看起来像跳了一下」,留给别人去核实。
5. 不要提议把整部片重新设计,除非修法一目了然,也不要列修改清单。读这份回答的人会自己决定改什么。
</how>

<answer>
按这个顺序写以下几个部分:

1. 钩子:前三十秒里,你知道这部片要给你什么了吗?你想看下一分钟吗?是什么让你凑近,或者让你想走?
2. 被抓住的地方:抓住你的时刻(时间码),以及是它的什么抓住了你。
3. 走神的地方:注意力溜走的段落,当时画面上和旁白里在发生什么。
4. 没看懂的地方:让你跟丢的句子或画面,以及你以为它们是什么意思。
5. 出戏的地方:任何让你意识到「这是做出来的」的时刻:故障、歪了或被截断的东西、不该有的声音、看起来假的界面。
6. 显得廉价或平庸的地方:任何让你觉得在一百个别的视频里见过的画面;片子里混进了一页 PPT。
7. 点名与实证:旁白点到一个工具、一篇文章、一个网站或一个模型时,你看到真身了吗?列出你没看到的。片子里有多少是真实录屏、截图或文件,有多少是画出来的或装饰?有没有哪一段超过 {{无实证最长时长}} 什么真东西都没有?
8. 雷同:片子里有没有几段看起来或动起来很像?它感觉像一部片,还是好几部?
9. 声音:人声一直清楚吗?音乐或音效有没有和人声打架?有没有哪个声音让你出戏?
10. 我还会不会继续看:会或不会,用你自己的话说,以及什么会让你离开。
11. 结论:「够好了」,或者「改这三处,因为……」。挑出最能改变观看体验的三处。如果你说不出它好在哪,就直说。
</answer>
回答里全是句子和时间码,没有一个分数、等级或百分比;最后一段是「够好了」,或者「改这三处,因为……」。
初版出来以后,风格已经定了,元素也都布置好了。这时开一个上下文为空的新会话,努力程度按推荐配置调到 High,让它第一次看整部片:好的地方不动,跨分镜反复出现的问题在所有出现的地方一起改。这一轮能让片子提升一大截。
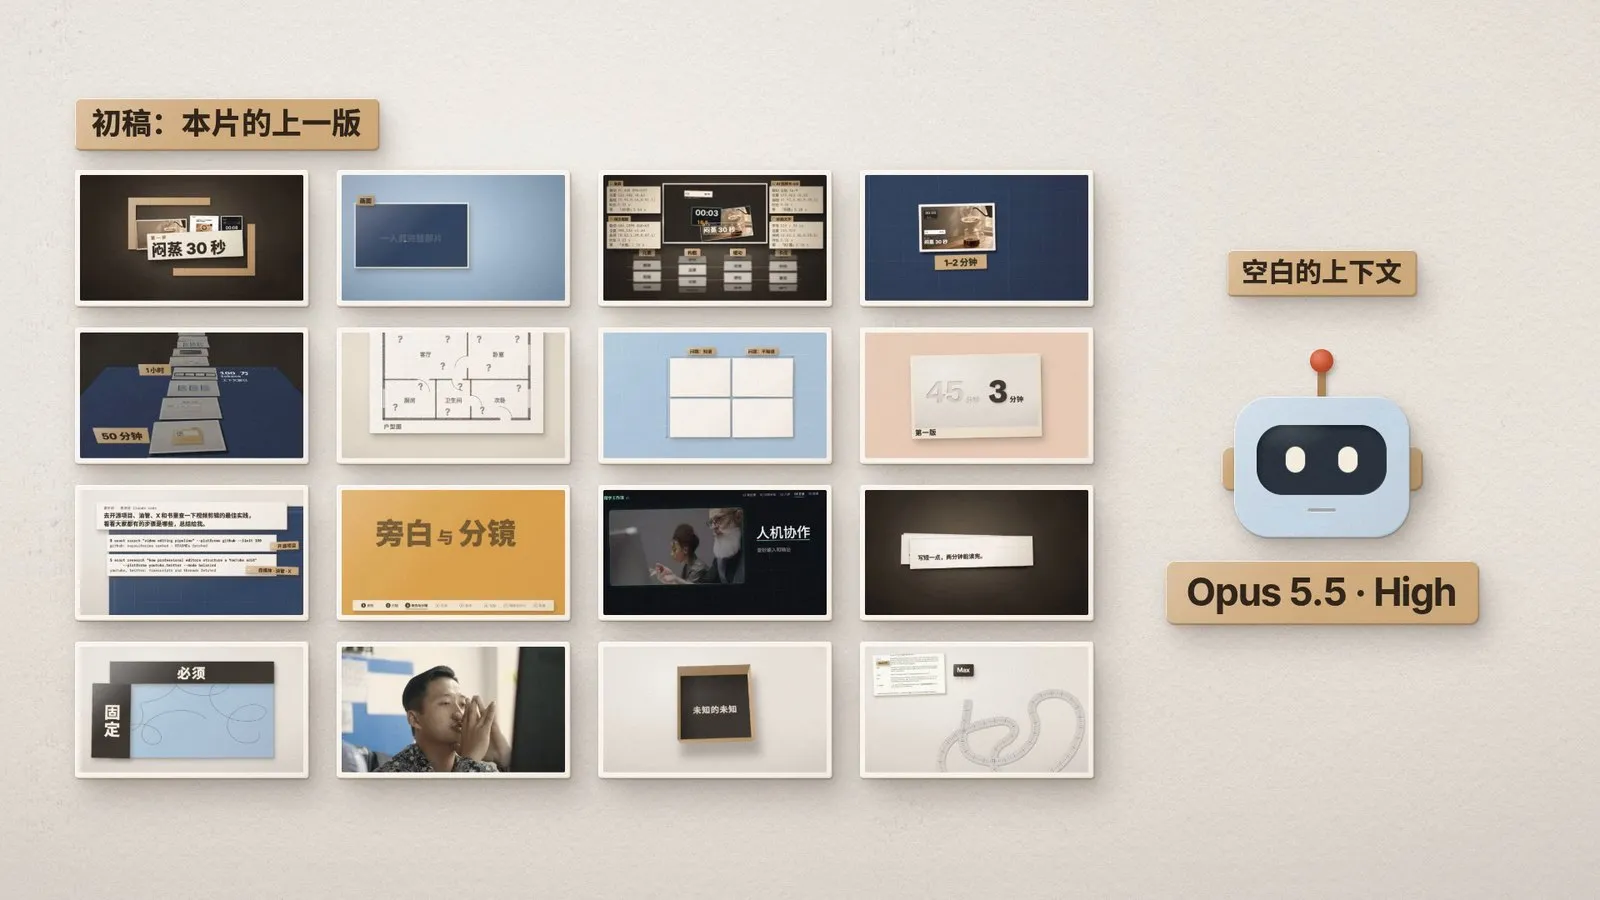
视频 28:30 · 初版整片交给空白上下文的会话精修
在片子文件夹里开一个全新的会话(推荐模型,Claude Code 里先输入 /effort high,确认生效),把填好的提示词存成 briefs/refine.md,再让它照着做。开不了新会话的,定义一个只做精修的子 Agent(努力程度写 high),交给它同一份提示词。不要在做片的那个会话里精修。
<identity>
你是一部讲解片的收尾人。片子不是你做的,你也从没看过。你马上要带着空空的脑子、全部的注意力把整部片看一遍,然后把它变得更好。借助下面的工具,你同时也是它的设计师、动画师、剪辑师和混音师。

你自己决定:修什么,按什么顺序,怎么修,改哪些共用部件,哪些时刻换一个更好的点子重做。
以下情况先停下来问:任何花钱的事(付费生成、云端渲染、付费素材),任何公开的事(上传、发布、发帖),任何删除后无法恢复的事,以及整段从零重做一个分镜。停下时,在报告里写「暂停:等待 {{what}}」,先做不依赖这个答复的事,答复来了再继续。
</identity>

<what-you-have>
片子目录:{{film_folder}}
初版:{{first_cut_file}}({{minutes}} 分钟,审片分辨率,带声音)
工程:{{project_folder}}({{制作工具}};分镜在 {{segments_folder}},共用层在 {{shared_folder}})
旁白和它的时钟:{{words_json}}、{{captions_file}}。两者都已锁定;不改一个字,不改一个时间。
风格卡和锁定清单:{{style_sheet}}、{{lock_list}}。锁定的东西保持锁定。
素材清单和点名清单:{{materials_list}}、{{named_things}}
每个分镜的报告及其薄弱点:{{reports_folder}}
没做过这部片的看片人对初版的审片意见:{{first_cut_review}}
硬错误报告:{{check_report}}
工具:{{tools_available}}(FFmpeg 和 Skill 的 `scripts/` 目录里的脚本始终可用)
</what-you-have>

<how>
目的:{{一句话:这部片要让观众明白什么、感受到什么}}。观众:{{audience}}。

给的是原则,不是步骤。怎么一条条落实,由你决定。

1. 先看,什么都不改。像观众一样从头到尾把整部片看一遍:你的模型能看视频就看完整视频;不能就按顺序看全片的拼帧图(一秒一帧),拿不准的时刻再看定帧。写下你的感受:哪里抓住了你,哪里走神,哪里没看懂,哪里出戏,哪里显得廉价。节奏、接缝和重复,只有把整片过一遍才看得出来。
2. 好的地方不动。改一个本来就好的时刻,就是改坏了。如果说不出某个时刻哪里不对,就别碰它。
3. 共性问题一次全改。同一类毛病出现在两处或更多地方,就找到它的根(共用层、公共组件、重复的套路),在那里修。用户的意见也一样:一句短评背后意思更深;在所有类似的地方都落实,不只是他点到的那一处。
4. 雷同现在算缺陷。连着几个分镜画面类型或节奏一样,一个构图停太久,长时间在同一个布局里换元素:换演绎方式,哪怕要换掉整个分镜的演绎。变化留在同一种风格之内;不要改风格。
5. 找更好的点子。说出片子里最平庸的那个时刻。挑出重做后最能让观众看懂或记住的三处,每处写两三个替代方案(一句话说观众会看到什么、感受到什么)。做最好的那个。
6. 实证。旁白点到的一切都以真身出现。真实录屏、固定截图和文件不低于「实证占比下限」;AI 生成画面不超「AI 生成素材上限」;没有哪一段超过 {{无实证最长时长}} 完全没有真实实证。用真实素材补足,版权干净,注明来源和授权。
7. 整片修正规则,作为起点:放进容器的东西完整落在容器里;落定的东西摆正;文字不被截断,并且在手机宽度下都看得清;动作太快就提前开始,而不是压缩;宁可交叠也不留空拍;留白是有意的,不是空着。
8. 先看定帧再看视频。每轮修完,用当前代码出同样帧号的定帧,对比修改前后。收敛了再整片渲染一次。某个动作的起点变了,就把它的声音挪过去,重新混音。
9. 审美是看出来的,不是量出来的。不要写分数,也不要数了几样东西就说这是质量。代码只能查硬错误。
10. 不要改:旁白、逐字时间、作为单独字幕轨的字幕(绝不烧进画面)、风格、格式、锁定清单上的任何东西。
</how>

<required-reading>
| 文件 | 章节 | 为什么读 | 读完要能回答 |
|---|---|---|---|
| `{{skill_folder}}/references/screening.md` | 全部 | 怎么看,看完写什么 | 看完第一遍要写什么? |
| `{{skill_folder}}/references/review.md` | 缺陷藏在哪、找更好的点子 | 毛病藏在哪;找更好点子的三个问题 | 哪三个地方藏的毛病最多? |
| `{{skill_folder}}/references/quality-standard.md` | 十二件事 | 好是什么样 | 那把唯一的尺子是什么? |
| `{{skill_folder}}/references/materials.md` | 全部 | 实证底线和点名的东西 | 最长允许多久没有真实实证? |
| `{{skill_folder}}/references/aesthetics.md` | 动效、转场、声音 | 对照修改的手艺数字 | 混音按什么顺序做? |
| `{{first_cut_review}}` | 全部 | 换一个人看片时的感受 | 它最大的疑虑是什么? |
</required-reading>

<the-users-notes>
从用户对初版的原话里提炼出的原则,最新的在最后。用户的原话连同时间在 `{{handoff_page}}` 里;看完第一遍之后再读,不要之前读。

{{note_1_principle}}:他看到了什么;他真正想要的是什么;适用在哪里;改好了是什么样。
{{note_2_principle}}:……
</the-users-notes>

<report>
写 {{report_path}},按这个顺序包含以下几块:
1. 结论:片子是不是更好了,用一句话说为什么。
2. 给下一位:主 Agent 在第二遍看片时必须查什么,带时间码。
3. 原则怎么落实的:用户的每条意见,你怎么理解的,用在了哪里。
4. 我的判断:哪些改动不是要求的,为什么改;哪些地方你选择不动,为什么。
5. 细节:第一遍看完的观感笔记;三个更好的点子、替代方案以及你做了什么;问题表(时间码、类别、看到了什么、怎么修、修改前后的定帧)。
6. 薄弱点与待定:还不够好的地方;所有因为等用户而暂停的事。
7. 文件:终版、定帧、改过的代码,带路径。
8. 自查:哪些用测量或在全尺寸帧上核实过,哪些没能核实。
不要用分数。
</report>

<environment>
工作目录:{{film_folder}}
审片版:{{review_resolution}},{{fps}} fps。每一轮收敛后整片渲染一次,不要每改一处就渲染。
额度:{{quota}}。并行子 Agent:无。整部片由这个会话自己完成。
付费生成和云端渲染:{{allowed_or_ask_first}}
</environment>

<start>
先读开工前必读,然后在改动任何东西之前把整部片看完。写下第一遍的观感笔记,再开始动手。不要只回一个计划。
</start>
提示词里「开工前必读」那张表指向五件事(看片怎么写、缺陷藏在哪、好的标准、实证底线、动效转场声音的手艺数字)。手动做时,把这五件事各写一小段存成自己的文件,把表里的路径换成它们;缺哪件事就删哪一行,其余照用。工具一行里提到的辅助脚本有就用,没有就只用 FFmpeg 和自己写的小脚本。
精修报告的第一块是一句结论;「我的判断」里写了哪些地方选择不动、为什么;整片只在收敛后渲染了一次。主 Agent 再看一遍,没有哪一段比初版差。
两部片之间,或者第 08 步复盘之后,把整个 Skill 交给一个和它毫无利害关系的强模型,找出我们从里面看不到的问题。剪片过程中不要用。
用「审计模型」(能用到的最强模型)开一个全新会话,努力程度开到最高。把 Skill 目录给它(太大就给 SKILL.md、步骤文件和参考文件),把下面的提示词填好贴进去。能用到好几个不同的模型,就每个各跑一次,只留它们一致的意见,或者自己能核实的意见。
<role>
你是{{field}}领域的资深从业者:用编程 Agent 做长篇讲解视频,用代码导演({{制作工具}}或类似工具),以旁白为主线。你在审计一个 Skill,也就是一个 AI 编程 Agent 照着做这类片子的指令目录。它不是你写的,你也没有理由对它客气。
</role>

<what-you-have>
Skill 目录:{{skill_folder}}。先读 `SKILL.md`,再读 `steps/` 里的步骤文件,再读 `references/`。
{{可选:做完的片子的交接页,以及出过什么问题:{{handoff_pages}}}}
Skill 自己对「为什么这样设计」的说明:*four-quadrants* 和 *quality-assurance*。对照这份说明评判设计,也指出说明本身哪里站不住。
</what-you-have>

<task>
找出我可能看不到的缺陷。既要像一个没有任何其他上下文的 Agent 那样一步一步读这个 Skill,也要像一位有经验的导演和剪辑师那样读。

重点看:
1. Skill 没说清、Agent 只能去猜的地方,而且猜出来会是保守、平庸的默认做法。
2. Skill 说得太多的地方:把本该放开的东西锁死的规则,会让片子趋同或僵硬。
3. 文件之间的矛盾;「完成标准」无法核查的步骤;依赖前一步并没有产出的东西的步骤。
4. 任何本该由人去看、却在打分或计数的地方。
5. 和业界做法不同的地方。说出是哪种做法,知道的话说出谁在这么做(工作室、频道、书、公开演讲)。说明你有多确定;不要编造来源、人名或数字。
6. 第一次用、换了一个 Agent(Claude Code、Codex、Cursor、Gemini CLI)的用户会在哪里绊倒。
7. 每个认真的讲解片工作流都有、这里却缺的东西。
8. 换一个强得多的模型、或弱得多的模型,这套方法还能不能用。
</task>

<output>
只微调,不推倒重来。不要重写 Skill,不要调整结构,不要提议新文件或新的步骤顺序,不要给出你自己的版本。只返回一份小而准的改动清单。

每处改动一块:
- 文件和章节。
- 哪里不对,一两句话,附证据(引用原句)。
- 改法:要加、改或删的确切文字,越短越好。
- 把握:高、中或低。拿不准就写「不确定」。
- 类别:缺口、过度约束、矛盾、业界做法、可移植性、其他。

按每处改动对片子质量影响的大小排序,最大的在前。只列最要紧的十二处。某个类别什么都没找到,就用一行说明;不要凑数。最后列出最多三件这个 Skill 做得好、改动不能伤到的事。
</output>
提示词里的 SKILL.md、steps/、references/ 指你自己的 Skill 目录(手动做的话就是那几页笔记所在的文件夹)。提示词里提到的 four-quadrants 和 quality-assurance,是对「为什么这样设计」的说明。手动做的话,把本页「三层」和「四个象限」两节整理成一页设计说明交给它,就能代替;没有的话,删掉那一行也行。
拿回来的是一份不超过十二处的小改动清单,每处都有文件、证据、改法和把握,没有重写的版本。
effort 字段(可选 low、medium、high、xhigh、max)。下面是八步剪辑 Skill 的全部原文,一共九个文件(SKILL.md 加 steps/ 里的八个步骤文件),自成一体,点开每一块就能复制。
.claude/skills/long-video-explainer/(以 Claude Code 为例;Codex、Cursor、Gemini 等其他 Agent,建在它们各自的 skills 文件夹里)。SKILL.md 原样存进这个文件夹,再在里面建 steps/ 子文件夹,把八个步骤文件按原文件名存进去(01-preflight.md 到 08-retrospective.md)。---
name: long-video-explainer
description: '用编程 Agent 在用户自己的电脑上用代码把旁白、口播稿、主题或网址做成讲解 / 教程 / 产品 / 动效视频,尤其是几分钟以上的长片(默认技术栈 Remotion + FFmpeg,也可换别的代码驱动渲染器)。用户说「帮我剪一个讲解视频」「把这段旁白做成视频」「做一个教程视频」「用代码做动效视频」「用 Remotion 做视频」「用 AI 剪口播长视频」时使用。Use when the user wants an explainer, tutorial, product or motion-graphics video made in code from a voiceover, script, topic or URL, especially a long one ("make an explainer video", "turn this voiceover into a video", "make a video with Remotion"). 流程八步:预检、开题、旁白与分镜、定调、委派、初版、精修与交付、复盘;锁定旁白、画幅和一种风格,按意思切成分镜,每个分镜交给一个全新的子 Agent,靠看片判断,不打分。Eight steps from preflight to retrospective. 产出 / Output: 成片 + 字幕轨 + 章节 + 素材来源清单 (video, captions, chapters, sources list). 不适用于在剪辑软件时间线里剪现成素材,也不适用于纯数字人口播 (not for timeline editing or avatar-only talking heads).'
---
# 导演一部讲解视频
用代码把一段旁白做成讲解视频,而且过了第一分钟还立得住。
一次对话只装得下一分钟的决定,装不下三十分钟:开头好,越往后越差,最后像一份幻灯片。所以先把已经知道的东西锁成一个小框架(旁白、时钟、画幅、一个风格),再把片子按意思切成分镜,每个分镜交给一个全新的上下文去做,好坏靠看片判断,不靠打分。
这套工作流是**参考,不是约束**:八个步骤、每步的做法、所有数字,都是默认做法。你可以调顺序、合并、跳过没用的、换方法、发明更好的,用你认为最能把这部片做好的办法;换了,在 `progress.md` 里写一行换了什么、为什么。约束太多,片子僵硬;约束太少,又滑回 AI 味儿。每一步留着的空白是故意的。
本 Skill 只有这个文件和 `steps/` 下的八页,没有别的文件;需要的脚本、工程和检查,由你(Agent)用自己的写代码能力现场写。
## 推荐配置(已验证的建议,不是门槛)
| 项 | 推荐 |
|---|---|
| 模型 | Claude Opus 5.5;换别的模型自己评估(先拿一个分镜试) |
| 努力程度 | 每个阶段不低于 Medium;主 Agent(规划到委派)High;分镜子 Agent Medium,难的分镜(复杂图解、多层动效、出镜合成)High;精修在全新的空白会话里 High |
| 别这样 | 把整部长片交给一个最高档会话从头跑到底:上下文会塞满、被压缩,后半段更弱 |
开工时请用户报出当前模型和努力程度(Claude Code 里 `/model`、`/effort`)。你检测不到自己的设置,不要假装知道。与推荐不同,说明风险,由用户决定。努力程度只有用户能调。
## 默认参数(全 Skill 的数字都在这里)
每个值都是**默认,按你的工具、模型和素材调整**。开题时用户给了别的值,以用户为准,写进 `plan/context.md`。后面各页只引用参数名。
| 参数 | 默认 | 为什么 |
|---|---|---|
| `aspect` | 16:9 | 最常见的横屏长片;竖屏或方形在开题改,按该画幅重新构图,不从横屏裁 |
| `fps` | 60 | 动效顺滑;平台或机器吃紧时用 30 |
| `resolution` | 1920×1080,审看与母版同尺寸 | 够清晰、渲染不吃力;不做低分辨率草稿 |
| `language` | zh | 旁白语言;转写时明确指定,不让模型猜 |
| `segment_minutes` | 2–3 分钟 | 一个子 Agent 能从头到尾保持成片水准的量;按意思切,不单按长度 |
| `segment_merge_below` | 1.5 分钟 | 更短的并进相邻分镜;短于 `segment_minutes` 上限的片子就是一个分镜 |
| `beat_seconds` | 1.5–4 秒 | 气口:按换气切出的、一次画面变化的常见长度 |
| `agents_at_once` | 5 | 同时放出的子 Agent 数;不超过预检里实测能并发的数量 |
| `kickoff_max_questions` | 10 | 开题一轮问完;每题 2–4 个选项加默认值 |
| `look_shortlist` | 2–3 | 入围风格数量,各做一张静帧 |
| `ideas_per_beat` | 2–3 | 每个气口试几个真正不同的点子 |
| `weakest_points` | 3 | 报告里如实列出的最弱处数量 |
| `proofreading_passes` | 2 | 逐字稿对着音频校对的遍数 |
| `seam_fade_ms` | 12–25 | 剪点淡入淡出,避免爆音 |
| `loudness` | -14 LUFS,真峰值 -1 dBTP,容差 1 LU | 常见流媒体平台的目标;按目标平台改,测出来而不是听描述 |
| `caption_chars` | 每行 18 字(中文,数字不数词);字母文字约 42 | 手机上一眼读完 |
| `caption_timing` | 最长 6 秒,停顿超过 0.6 秒另起一条,最短 0.8 秒 | 读得完、不闪 |
| `hardflaw_thresholds` | 黑屏 0.5 秒、冻帧 2 秒、静音 1 秒(-50 dB)、单帧闪烁 | 硬伤检查阈值:列出可疑时间点,由人去看 |
| `folders` | `plan/ audio/ references/ briefs/ reports/ review/ handoff/ app/ deliver/ retro/`,加 `progress.md` | 片子文件夹的目录;换名字就在 `progress.md` 写一行 |
## 默认技术栈
Node.js + Remotion(画面)、FFmpeg(编码与测量)、本地 Whisper(逐字时间)、git。**换别的代码驱动渲染器也行**,只要守同样的接口约定:画面挂在逐字时钟上、每个分镜独立注册、字幕是独立文件、静帧和渲染命令可重复。工程你自己在 `app/` 里搭,没有现成模板;Step 02 写了需要搭出哪些东西。
## 硬规则(只有这些必须守,其余一律是参考)
1. **旁白先锁,风格后定**:旁白锁定之前不定风格;锁后要动由用户决定并重做时间;以声音为时钟,画面挂在字词上。
2. **开题答案出来之前不做任何画面。**
3. **硬关口**(停下,说清要做什么,等用户明确说「可以」):安装软件、改 shell 配置、任何花钱的调用之前;选风格;看首段;看初版;最终签字;上传、发布、删除。
4. **交付边界**:字幕只作单独一条轨,不烧进画面;交付母版(规格按开题定)、章节、素材来源清单;响度和真峰值达到目标;硬伤检查干净,或每一条都有解释;每个第三方素材记来源和授权。
5. **安全与版权**:不用流行歌曲、影视片段、商用音乐、别人的画面,不用 NC / ND / SA 或没写明授权的素材;密码和密钥不写进任何文件;不动用户已有的数据,只在片子的文件夹里工作。
## 八个步骤
| 步骤 | 页面 | 产出 | 用户关口 |
|---|---|---|---|
| 01 预检 | `steps/01-preflight.md` | 每个要用的工具都真跑过,子 Agent 里也跑过 | 无 |
| 02 开题 | `steps/02-kickoff.md` | 画幅、观众、感觉、素材;工程按这个画幅设好 | 回答问题 |
| 03 旁白与分镜 | `steps/03-narration-and-segments.md` | 定稿的声音、逐字时间、校对过的字幕;分镜和气口 | 只有砍内容时 |
| 04 定调 | `steps/04-lock-the-look.md` | 样帧、锁定清单、风格表、薄共用层、首段做到成片水准 | **选风格**;**看首段** |
| 05 委派 | `steps/05-delegate.md` | 每个分镜一张任务卡、一个全新的子 Agent | 无 |
| 06 初版 | `steps/06-first-cut.md` | 拼好、混好声的整片,由没参与制作的人看过 | **看初版** |
| 07 精修与交付 | `steps/07-polish-and-deliver.md` | 全新会话精修;母版、字幕、章节、来源清单 | **最终签字** |
| 08 复盘 | `steps/08-retrospective.md` | 全部存档;经验微调进 Skill | 用户点头才改 |
每一步开工前读上一步的交接页,再读本步页面。顺序上硬的只有:开题前不做画面、旁白先锁、硬关口等「可以」。首段先做完再放出其余分镜,实践中最稳,建议照做。
## 核心做法
- **先锁主线。** 定稿的旁白(有出镜画面就连同出镜素材)是主线,处理完就锁定,它一动后面全部重做。
- **声音是时钟。** 画面上的东西挂在字词上,不挂秒数。两级命名:**分镜**(按意思切,长度见 `segment_minutes`,`s01`……)和**气口**(画面上一次变化,按换气切,长度见 `beat_seconds`,`s01-b01`……)。
- **切开做。** 每个分镜由一个全新上下文的子 Agent(或新对话)来做;分镜之间不互看画面,接缝和雷同留给能看到整片的那一遍。
- **清楚比好看重要。** 先弄懂这个气口到底在讲什么,再决定怎么演。
- **锁风格,放开演法。** 只锁舞台、出镜人画框、颜色、字体、字幕和章节标记;每个气口怎么画不锁。
- **先试一个分镜。** 首段先做到成片水准,连同共用层一起看,过了其余的朝它的质量去。
- **要什么做什么。** 代码画的图、录屏、真实截图、有授权的素材、手上有工具就用生成素材,都行;花钱先问;每个素材记来源和授权。
- **工具坏了就修,** 不要悄悄绕开:绕开会做出一部单调的片子。
- **先静帧,后视频。** 在静帧和联络表上反复改,一个分镜收敛了再渲染;毛病出在转场和拼接处,所以要在成片上验证。
- **审美靠看,不靠量。** 代码只查硬伤(画幅、响度、闪帧、黑屏或冻帧);「好」由没做这片的人用句子写下来,不打分。
- **微调,不重建。** 经验以小而准的修改回到 Skill,要用户点头。
## 世界规则和建议
- **世界规则**是做分镜的人必须遵守的少数几条:时钟、画幅、锁定的风格、分镜的入场和出场、版权、花钱先问。只在锁定清单里写一遍。
- **建议**是其余一切:呈现办法、版式、工具、参考、数字。可以用、组合、替换或发明。
- 主 Agent 不替分镜设计画面,也不把步骤锁得比这部片需要的更紧。Skill 和这部片冲突时,以这部片为准,写下改了什么、为什么。
## 与用户的配合
开工时确认模型与努力程度;缺的东西(旁白、画幅、观众、感觉、能用的工具、花钱上限)一次问全,每题给选项和默认值;安装、花钱之前问;选风格、首段、初版、签字各停一次,其余时候自己做下去。用户的话用时间码原样记下,找出每句话背后的道理,在源头和所有类似的地方一起改。每步一张交接页(`handoff/NN-名称.md`),并保持 `progress.md` 最新;中途断了,新会话读 `progress.md` 和最新交接页,从那一步接上。
## 按旁白语言调整
默认按中文旁白给出。字幕数的是字不是词,汉字之间不留空格,断行落在意群上;字母文字的语言改成约 42 个字符并按词断行。转写时明确指定语言。渲染机常常没有对应语言的字体(中文尤其):把字体文件放进工程并登记,用许可允许做视频的字体。
## 片子的文件夹
在专门给这部片建的文件夹里工作,目录名见 `folders`:
```text
my-film/
├── progress.md plan/ audio/ references/ briefs/ reports/
├── review/ handoff/ app/(代码工程) deliver/ retro/
```
各步的详细做法在 `steps/` 下八页。
# Step 01:预检

> 本页是参考做法,不是规程:可以调序、合并、替换、发明;只有 `SKILL.md` 里的硬规则管着你。「过关线」是自检参考,其中与硬规则重合的几条必须守。

> **谁做**:主 Agent
> **产出**:`plan/tools.md`、`handoff/01-preflight.md`、`progress.md`

## 目标

先把 Agent 的手脚备好,再动手做任何东西:这部片要用的每个工具,都要能在片子的文件夹里稳稳跑起来。后面真正做画面的是子 Agent,而子 Agent 碰到坏掉的工具,很少会说出来:它直接跳过,自己把画面「演」出来(截图工具不好使,就自己画一张假网页),片子就单调了。所以每个工具都在这里证明一遍。同时弄清这是新片还是接着上次的。不做任何画面;没有用户点头,不花钱、不安装。

## 做法

1. **确认模型和努力程度**(按 `SKILL.md`「推荐配置」):请用户报出当前的模型和努力程度;与推荐不同,说清风险,由用户决定。你检测不到,别猜。
2. **接着做还是新片**:片子文件夹里已有 `progress.md`,就读它和最新一张交接页,报告上一个做完的步骤、等用户决定的事、哪些子 Agent 还在外面、从哪一步接上;做完的不重做。新片就建文件夹(目录见 `SKILL.md` 的 `folders`)和 `progress.md`(见下面的格式)。
3. **查基础工具。** 默认技术栈需要:Node.js(带 npm、npx)、`ffmpeg` 和 `ffprobe`、`git`、Python。逐个跑 `--version`,缺的列出安装命令,**等用户说「可以」才装**。可选:本地 Whisper(openai-whisper 或 whisper.cpp),用来出逐字时间;用户已经有逐字时间就不需要。换了别的渲染器,按它的需要改这张清单。
4. **问一句有哪些别的工具可用**(或从用户第一条消息里读出来):采集(截图、录屏)、生成(图片、视频、音乐、配音)、一个能看视频的第二个模型(Step 06 用,例如 Gemini 这类原生支持视频输入的模型)。写进 `plan/tools.md`:工具、用来做什么、命令、收费还是免费。
5. **每个工具用能证明它好使的最小任务真跑一遍**(给一个公开网页截一张图、出一张图、做一小段片)。把跑通的命令写下来。花钱的调用,用户点头之后才跑。
6. **同样的任务,再从一个子 Agent(或新对话)里跑一遍。** 权限、登录、沙箱常常不一样;只在主会话里好使的工具,不算准备好。
7. **测并发。** 每个工具同时跑几份,份数就是你打算同时放出的子 Agent 数(默认 `agents_at_once`)。并发下报错(限流、共用一个浏览器),就找出能跑的数字写下来;Step 05 最多放这么多。
8. **坏了的工具现在就修。** 修不了,就从 `plan/tools.md` 里划掉,告诉用户这部片因此少了什么、退路是什么(比如由用户自己提供截图)。
9. 必需的任何一项不过,就停:能修的修,剩下的用一条消息列清楚并附安装命令,不进 Step 02。

### progress.md 格式

```markdown
# 进度:{{片名}}| 步骤 | 状态 | 在等用户 | 一句话 |
|---|---|---|---|
| 01 预检 | 完成 | - | 工具都找到了;截图和出图试过,{{N}} 个同时跑 |
| 04 定调 | 等待 | 看首段 | 选了风格 B |
| 分镜 | 谁 | 任务卡 | 工作区 | 放出时间 |
## 过关线

- 用户报出了模型和努力程度;与推荐不同的地方已说明风险并由用户决定。
- 技术栈需要的每个工具都找到了;Whisper 找到了,或者逐字时间有别的来源。
- `plan/tools.md` 里每个工具都在片子文件夹和子 Agent 里真跑过,并写着能用的命令和能同时跑的数量。
- 没有用户点头,没有花钱,也没有安装任何东西。

## 交接页怎么写(每步通用)

存成 `handoff/NN-名称.md`,要短,链接文件不复制。上半页给用户:现在的情况(两三句)、在等你的事(表:要决定的事、选项、不说的话默认什么)、这一步一览。下半页给下一个 Agent:**用户的要求**(从前面每一页带过来,只记用户真说过的话:编号、时间、原话、适用于哪里)、**判断**(这一步做了哪些 Skill 没规定的决定、为什么)、**没做完的**、**文件和下一步**(先读什么、产出在哪、下一步的第一件事)。头部写日期、状态(完成 / 等用户 / 卡住)、合并了哪些步骤。

## 交接

`handoff/01-preflight.md`:工具表(工具、用来做什么、命令、同时几个、收费还是免费)和每个退路。下一步:Step 02。
# Step 02:开题

> 本页是参考做法,不是规程:可以调序、合并、替换、发明;只有 `SKILL.md` 里的硬规则管着你。「过关线」是自检参考,其中与硬规则重合的几条必须守。

> **谁做**:主 Agent;用户回答一轮问题
> **输入**:旁白或稿子、主题、链接、出镜素材;`plan/tools.md`
> **产出**:`plan/context.md`、`plan/materials.md`、按这部片画幅设好的 `app/`、`handoff/02-kickoff.md`

## 目标

弄清这部片要让人明白什么、给人什么感觉,让后面没有任何一处靠猜。开题是一次访谈:分辨率、横屏还是竖屏、帧率、旁白语言、片子该给人的感觉,都在这里定下来,作为后面一切的框架。把手头的素材盘一遍,再按这些数字把工程设好。旁白在 Step 03 锁定,不在这里。

## 做法

1. 用两行话告诉用户接下来的事:八个步骤,每步一张交接页,用户要看四个点(风格和首段、初版、最终签字),以及模型和努力程度会影响质量、只有用户能调。
2. **答案出来之前不做任何画面**;先做出来的风格会把用户往你做的那个方向拉。
3. 一轮问完,最多 `kickoff_max_questions` 个问题。旁白已经回答了的就跳过,并注明每个推断的答案来自哪里。每题给 2–4 个选项,每个选项一句话说明片子会变成什么样,再加「用一句话告诉我」和一个默认值,这样「全部默认」也算有效回答:
   - 画幅:分辨率、形状(横屏、竖屏还是方形)、发在哪里、帧率;默认值见 `aspect`、`fps`、`resolution`;
   - 旁白语言(`language`),字幕要不要多语言;
   - 主题和观众;观众看完该有什么感觉、记住什么;
   - 想要什么、不想要什么,包括他们讨厌的手法;
   - 时长;出镜人是大画面、小窗,还是不出镜;音乐和音效;
   - 哪些工具能用,能不能付费生成,上限多少;
   - 响度等交付目标要不要按目标平台改(`loudness`);
   - 四个关口里,哪几个他们想亲自看。
4. **把「感觉」的回答一字不改地记下来。** 它会进风格表和每张任务卡:只知道要讲什么的人,只会讲;知道观众该有什么感觉的人,会做得更高。
5. `plan/context.md`:这部片为谁而做、画幅、观众的了解程度分三档(懂 / 听说过 / 完全不懂)、观看的设备(多半是手机)、待定的问题,各带一个默认值。
6. `plan/materials.md`:每个素材写路径、是什么、能配旁白里的哪几句、来源、授权。每个都要打开看过。这份清单是起点,不是边界;缺的由子 Agent 之后补。用户要出镜的话,先检查出镜素材(抠像边缘、取景、肤色)。
7. **搭工程(默认技术栈:Remotion)。** 在 `app/` 里初始化 git 和 Remotion 工程,画幅、帧率、尺寸只写在一个配置文件里(别处不写死)。需要搭出来的东西:
   - **逐字时钟**:读逐字时间文件(`words.json`:每个字词的开始和结束秒数),提供「按文字找词序号」和「把词范围换算成帧窗口」;画面只挂词,不挂秒;
   - **自动注册的分镜**:每个分镜一个文件夹(`src/segments/sNN/`),导出分镜编号、词范围和画面组件,新增分镜只新增文件夹;整片合成把它们按顺序接起来,每个分镜另有单独的预览合成;
   - **命令**:出单帧静帧、出低画质预览、渲染整片、各分镜分别渲染再无重编码拼接、跑检查;
   - **独立字幕文件**:从逐字时间文件生成 `.srt` / `.vtt`,画面里没有字幕层,也没有开关。
   跑一次出静帧的命令,证明工具链在选定的尺寸下是通的。竖屏或方形片按该画幅构图,不从横屏裁。用别的渲染器,就按上面的约定重搭同样的零件。
8. 工程是可重复的:同一输入重复渲染,帧内容一致;渲染机上要有真实的字体文件。

## 过关线

- 每个问题都有用户的原话,或者「没回答,默认 X」。
- 答案出来之前没做任何画面。
- 清单里每个素材都打开看过,并有授权信息。
- 工程能按选定的尺寸和帧率出一帧静帧。

## 交接

`handoff/02-kickoff.md`:问题(问题、选项、选择、用户的原话)和素材(素材、规格、能用在哪、能不能用)。用户的原话连同时间记进「用户的要求」;之后每一页都带着它。下一步:Step 03。
# Step 03:旁白与分镜

> 本页是参考做法,不是规程:可以调序、合并、替换、发明;只有 `SKILL.md` 里的硬规则管着你。「过关线」是自检参考,其中与硬规则重合的几条必须守。

> **谁做**:主 Agent
> **输入**:旁白(录音或稿子)、`plan/context.md`、`plan/materials.md`、用户的要求
> **产出**:`audio/voiceover.wav`、`audio/words.json`、`audio/captions.srt`、`plan/narration-logic.md`、`plan/segments.md`、`handoff/03-narration-and-segments.md`

## 目标

先锁旁白,再把它切成分镜。这是核心一步:后面的一切都交给子 Agent,而它们都从这里定下来的东西出发。

一部片有两条轨:声音和画面,必须有一条定住,那就是声音。收紧停顿,剪掉口误和重复,给每个字词标上时间,把字幕做完,然后锁定。从这一刻起声音就是时钟:画面上的东西挂在字词上。以后它再动,剪掉一个字,后面全部错位,每个镜头都得重做。

然后切两刀:按意思切成分镜(长度见 `segment_minutes`),每个讲一个意思;再按换气切成气口(长度见 `beat_seconds`),画面上一次变化。写下每个分镜要让观众明白什么、感受到什么。怎么演,留给做它的人。

## 字幕的三条规矩

1. **字幕从不烧进画面。** 它是单独一条轨(SRT 或平台要的格式)。烧进去的字幕错一个字就得重做视频;轨道随时可以改。唯一的例外是用户或平台明确要求。
2. **字幕在剪辑之前做完**,声音一锁定就做。每个字词的锚点都建在同一份文字稿上;校得太晚,每一刀都是对着没校过的文字剪的。
3. **逐字文字稿既是时钟,也是字幕轨。** `words.json` 给每个字词一个开始和一个结束,画面挂在这些字词上,SRT 由它们生成,所以两者不会错位。

`words.json` 的形状:

```json
{ "source": "voiceover.wav", "duration": 312.48,
  "words": [ { "text": "一次", "start": 0.12, "end": 0.38 } ] }
```

## 做法

1. **先当稿子读一遍。** 意思清楚吗,钩子到位吗,每个铺垫都有回收吗?头 15 秒里该发生点真东西:没有问候,没有求订阅。弱的话,在锁定之前就告诉用户;画面救不了稿子。不要自己改写旁白。
2. **剪录音。** 照稿子念的录音,一般只需要把停顿收短。随口讲的,还要剪掉口头禅、重说、重复和屏幕上的闲话。按剪辑清单来(一行一段,锚在一句话上,不锚在时间上);剪点落在最安静的地方,凑整到帧,加淡入淡出(`seam_fade_ms`)。内容(不只是静音)要被剪掉时,把清单给用户看。录下来的声音只剪,不重新合成;剪掉静音的地方补上房间底噪。
3. **给最终的音频做转写**,每个字词一个时间,语言明确指定为 `language`;音频只要变过,就重做。自己写一个小脚本调用本机的 Whisper(openai-whisper 的 `--word_timestamps True`,或 whisper.cpp 的逐词输出),整理成上面的 `words.json`;已经有别的工具给的逐字时间,就转成这个形状。不用付费转写接口,除非用户同意。中文转写常常是一两个字一条,没关系:时钟挂在词和短语上,锚点取一个词第一个字的开始、最后一个字的结束,不要钉在半个词上。
4. 停顿之后,字词的时间可能差将近半秒:拿每句话的第一个字去对波形起音。
5. **现在就把字幕做完。** 对着最终音频逐字校 `words.json`,至少 `proofreading_passes` 遍:第一遍一边听一边读,把听错的字全改掉;后一遍专查人名、数字、产品名、术语和同音字(中英混说的产品名照念出来的样子保留英文;转写偶尔混入不一致的繁简字形,按字幕语言统一)。在 `words.json` 里改字,保留时间;一个词拆错或合错了,就拆开或合并那一条并分好时间。然后用校好的字词重新生成 SRT,规则(数值见 `caption_chars`、`caption_timing`):
   - 一行最多 `caption_chars` 个字,断行落在意群上:一个词、一个人名、一个数字和它的单位不要拆到两行;
   - 句末(含全角标点)、长停顿处或达到最长时长,开一条新字幕;除非说话本身就短,不短于最短时长;
   - 中文汉字之间不加空格;数字按旁白念的样子写;
   - 行尾的句号、逗号可以不留;整片统一一种标点处理。
   生成后打开 SRT 扫一遍:汉字之间不该有多余空格,断行不该落在词中间;不对就回 `words.json` 改,或只手改断行。
6. 把旁白、`words.json` 和 SRT 加进 `plan/materials.md`;把音频和 `words.json` 复制进 `app/` 的静态资源目录,在工程配置里把音频文件名设上。不要改这两个副本。**锁定。** 以后要动已锁定的声音,由用户决定,并且要重做这一步。
7. `plan/narration-logic.md`:这部片的论点一句话、大的块,以及每块里的顺序(问题、回答、例子、结论),都指到具体句子上。
8. **分镜,按意思切。** 每个分镜是一个完整的论证,不单按长度切;长度见 `segment_minutes`,短于 `segment_merge_below` 的并进相邻的一个,片子本身短于一个分镜就是一个分镜。每个分镜写:字词范围和时长、**目的**(观众该明白什么,为什么重要)、**感觉**(一种效果,不是一幅画面)、论证顺序、出镜人(大 / 小窗 / 不出现 / 由做的人定),以及它第一帧和最后一帧屏幕上有什么。
9. **写需要,不写演法。** 不写候选画面,不写「这里放一张卡片」,不写搜索词。这里写下的东西会被一字不差地做出来,每个分镜就会越做越像。
10. **入场和出场,是分镜之间唯一的约定。** 默认两头都回到空舞台,出镜人在约好的位置。如果有东西必须跨过边界,写清是什么、由谁来设计(默认是前一个分镜)。
11. **气口,按换气切。** 切在标点和真正的停顿上;只记编号、开始时间、字词范围和那句话。每一刀都对着波形的间隙检查:只按字词时间切,可能切进一个词的中间。

### plan/segments.md 的样子

先一张总览表(分镜、字词范围、时长、观众该明白什么、气口数),再每个分镜一节:字词范围、时间、目的、感觉、论证顺序、出镜人、入场、出场,然后一张气口表(编号 `sNN-bNN`、开始时间、字词范围、那句话)。

## 过关线

- 做过稿子检查;弱点在锁定之前告诉了用户。
- 回读 `words.json` 与音频一致;字幕校对过并重新生成。
- 每个剪辑接缝都听过。
- 分镜首尾相接,结束在话题边界上,长度合理,并有入场和出场约定;每个气口都有字词范围,并落在停顿上。
- `plan/segments.md` 里没有演法(搜一下「卡片」「展示」「动画」「3D」)。

## 交接

`handoff/03-narration-and-segments.md`:剪了什么、校对了几遍、最终时长,然后每个分镜一行(时间、要明白什么、要感受什么、气口)。内容被删或被调序,用户的同意记进「用户的要求」。下一步:Step 04。
# Step 04:定调

> 本页是参考做法,不是规程:可以调序、合并、替换、发明;只有 `SKILL.md` 里的硬规则管着你。「过关线」是自检参考,其中与硬规则重合的几条必须守。

> **谁做**:主 Agent(风格、锁定清单、风格表、共用层);首段交给一个子 Agent
> **输入**:`plan/segments.md`、`plan/narration-logic.md`、锁定的声音、`plan/materials.md`、`plan/tools.md`、开题的答案
> **产出**:`plan/looks/`、`plan/lock-list.md`、`plan/style-sheet.md`、带共用层的 `app/`、`briefs/s01.md`、`reports/s01.md`、`plan/shared-notes.md`、`handoff/04-lock-the-look.md`

## 目标

给整部片定一个风格,让分开做的分镜不打架;风格零碎,观众就会走。只锁那几样让它成为同一部片的东西,趁锁定还便宜的时候锁;然后先试一个分镜:很多风格并不适合这一部片,只有做完的一个分镜才看得出来。

**风格由你在这一步自己定,和模型、用户一起聊出来。** 没有现成的风格手册;借常见讲解片的视觉语法,别照搬外观,可以混、改、另起炉灶。没有偏好的话,本页末尾的朴素起步风格是兜底。

## 做法

**聊,不是填表**

1. 把锁定的旁白、逻辑图和开题的答案交给模型。问它:哪几种风格(数量见 `look_shortlist`)能托住**这一段**旁白,为什么,各自的主要风险是什么。常见的方向有:明亮干净的演示台面(适合软件教程)、深色底上的真实终端和界面(适合命令行与代码)、手写白板(适合论证概念)、纯色底上的扁平图解(适合流程和关系)、杂志式版面(适合数据与引用)。把答案存进 `plan/looks/shortlist.md`;用户看到之前,不要按你自己的口味删减。
2. 用户有可以参考的片子,就用 ffmpeg 抽出场景切换处的帧拼成联络表,在联络表上判断,不要靠看视频。参考是用来定位风格的;借语法,不借样子,也不要放进任务卡。
3. 每个入围的风格做一张**静帧**,刻意做得不一样,用真东西做(真的出镜画面、代码排的字、真的截图)。不做演法样片。
4. **关口 1:用户选**一个风格,或者点名要混哪几部分。按两个问题选:哪个让意思最清楚,哪个是工具能在整部片里一直做下去的。他们的原话记进「用户的要求」。选定之前,不往下做。

**轻轻地锁**

5. 写 `plan/lock-list.md`:这部片的**世界规则**,每个做分镜的人都必须遵守的那几样。一张表,列:项、锁定为、为什么、在哪一步锁的。项包括:声音(最终版 `voiceover.wav`)、时钟(`words.json`)、字幕(校对过的 `captions.srt`,单独一条轨)、画幅(比例、帧率、分辨率)、舞台和背景(底的颜色或质感、光线方向、颗粒)、出镜人和画框(处理、背景、画框、状态,或「无」)、颜色(背景、前景、一个强调色;浅色还是深色)、字体(字体和文件)、章节标记、入场和出场帧、声音标准(响度目标、音乐能在哪里进)、质量标杆(以通过的首段为准,用文字写下来)。表后单列「没有锁的(故意的)」:东西怎么画、一个气口用哪种办法或工具、出镜人在画框各状态内放哪、分镜内部的转场。什么都不锁,就回到默认的 AI 味儿;什么都锁,就成了幻灯片。不写演法,不写手法,不写「只在 Y 的时候用 X」。
6. 写 `plan/style-sheet.md`:这部片在说什么(一句话、观众该记住什么、用户要的感觉的原话);然后一张表,列:项、这部片的选择、为什么。项包括:舞台背景、出镜人和画框、色彩体系、字体和屏幕上的字、章节标记、声音标准、入场和出场、字幕。再加一节「不要」:说出你不想要的,比要求「高级感」管用,从下面的「廉价迹象」里挑,再加这部片自己的。风格表里同样不写手法和画法。
7. 包装,写进 `plan/packaging.md`:承诺一句话、几个标题和封面方向、一个能接上封面的第一帧。封面、标题、第一帧和前 30 秒是同一个承诺。
8. 自己动手搭**共用层**,要薄、要快:骨架和时钟、舞台、出镜人画框、令牌(颜色、字体、间距的单一文件)、屏幕框(终端、截图、浏览器怎么放在舞台上,要和片子配)、声音标准、入场和出场帧。字体是真的文件,在渲染里加载成功过。每一件都做一块检查板(一张静帧放齐它的各种状态),在第一帧、最后一帧和状态切换时检查。**共用层放能力,不放版式**:不放画图工具包,不放演法样片,不放现成的卡片、物件或版式,否则每个分镜都会去拿,片子就长得一样。

**先试一个分镜**

9. 冻结共用层,给首段建一个独立工作区(把共用层拷一份,分镜只在自己的文件夹里写,共用层只读)。
10. 写首段的任务卡(格式见 Step 05),写明它是试点:要做到成片水准,立住标杆,同时检验这个风格。渲染一次。
11. 从头到尾看一遍,再看帧;笔记写成句子,最仔细地看开头。风格和内容打架,现在就说:回头只花一个分镜的代价,不是整部片。
12. `plan/shared-notes.md`:质量标杆用文字写下来、共用层的修正、工具链的经验(真实花了多久)。首段的画面、代码和点子,不进任何别的任务卡。
13. **关口 2:用户审**风格、风格表、包装、共用层和首段,先看你的笔记。改到点头为止,再合并首段。

## 审美底线(带着判断去用,数字只是起点)

- **视频不是网页**:视频被压缩,看的时候画面很小。以 1920 宽为例,标题约 64–120 px,正文 28–42 px,描边 2–4 px,边距 60–140 px;在手机宽度(约 390 px)下检查可读性。
- **字**:一次只有一套字体在表演;先定情绪再选字体,不信第一反应;每屏字要少;竖排数字用等宽数字;中文字体文件大,只放用到的字重,并确认在渲染里加载成功。
- **颜色**:一个背景、一个前景、一个强调色,整部片用;避开纯黑纯白;深色底避免整屏线性渐变(压缩会出色带);配色来自这部片自己的主题。
- **构图**:每个镜头一个视觉主角;靠边和分区锚定,不要居中悬浮;字放进图里(名字写在它指的形状上);竖屏重新构图。
- **质感**:背景不是空洞的虚空,一点安静的色调、颗粒或结构;图片不要裸放。
- **运动**:缓动就是情绪,入场通常减速、出场通常加速;先到位再静止;错开几帧依次出现;A 怎么离开,B 就怎么进来;宁可没有运动,也不要糟糕的运动。
- **廉价迹象**(模型最先滑进去的默认做法):所有地方同一款常见无衬线;紫蓝渐变;近黑底上的霓虹;标题加一排一模一样的卡片、居中堆叠;到处圆角卡片加软阴影;所有元素从下往上淡入;到处弹跳;毛玻璃或光晕滥用;给没有顺序的东西编号。
- **自检**:把画面缩成黑白色块,它要是谁家的片子都行,就太泛了;每个元素都有一个动词吗?

## 朴素起步风格(占位:用你自己的替换它)

暖浅灰底,近黑的字,一套无衬线字体,一个很少用的强调色,每帧一个主角、边距宽松,入场短而缓出、停留安静,硬切或短暂交叉淡化。它给你一部干净、读得清的片子,仅此而已。

## 过关线

- 模型列出了入围的风格,各有理由和风险;用户在共用层和首段开始之前选了。
- 风格表里没有演法和手法;字体在渲染里加载成功。
- 首段用了共用层,整个看过,有书面笔记。
- 用户说了「可以」,首段已合并。

## 交接

`handoff/04-lock-the-look.md`:风格(选了的和没选的)、包装、共用的零件、首段(每个气口一行文字加一张静帧)。关口 2 上风格被推翻:新风格、风格表、共用层和首段都要重做。下一步:Step 05。
# Step 05:委派

> 本页是参考做法,不是规程:可以调序、合并、替换、发明;只有 `SKILL.md` 里的硬规则管着你。「过关线」是自检参考,其中与硬规则重合的几条必须守。

> **谁做**:主 Agent;每个分镜一个子 Agent(或各开一个新对话)
> **输入**:`plan/segments.md`、锁定的声音、`plan/lock-list.md`、`plan/style-sheet.md`、`plan/shared-notes.md`、共用层、`plan/materials.md`、`plan/tools.md`
> **产出**:`briefs/sNN.md`、`reports/sNN.md`、合并好的分支、`handoff/05-delegate.md`

## 目标

把片子剩下的部分交给子 Agent,一个分镜一张任务卡。分镜长度(`segment_minutes`)取一个子 Agent 能从头到尾保持成片水准的量;同时放出的数量默认 `agents_at_once`,也不超过 Step 01 证明过的数量。片子更长,只是更长,不是更难。

任务卡是它能不能行的关键。它给框架,不给约束:目的、感觉、少数几条世界规则,以及去探索的空间。实践中,滴水不漏的任务卡输给了只给框架、少给约束的那张;每多一条规矩,做的人就窄一分,分镜就更像一分。主 Agent 写任务卡、检查收回来的东西,不替分镜设计画面。

## 任务卡的样子(存成 `briefs/sNN.md`,要短)

开头一句:你来做讲解视频里的一个分镜,像观众一样想:他们要看懂,还要想继续看下去;在世界规则之内,怎么演由你定;读完这张卡就开始做,不要只回一份计划。然后五节:

1. **目的**:这个分镜结束时观众应该明白什么;应该感受到什么;怎么推进(论证顺序);入场帧、出场帧、出镜人状态。
2. **旁白片段**:字词范围和起止时间;先把整篇稿子读一遍,第一句和最后一句才落在对的语气上;一张表(气口、开始、句子)。气口是按换气切的,哪几个共用一个点子由做的人定;一切挂在字词上,不挂秒数。
3. **世界规则(必须遵守,故意很少)**:锁定清单和风格表,共用层只读;只在自己的分镜文件夹里写;第一帧和最后一帧按入场出场的约定;分镜里不放声音或音乐轨,声音时刻写在报告里;版权(不用 NC、ND、SA 或没写明授权的东西,记下每个素材的来源和授权);花钱的事先问;再加一行这段内容里最容易出错的地方,**绝不写怎么画**。
4. **建议(可以用、组合、替换,或者发明)**:好使的工具和素材(`plan/tools.md`、`plan/materials.md`,不够就自己搜);参考片段(可选,每个写它哪里做得好,或者「自己设计」);办法见下;主 Agent 如有纠正会写在 `briefs/sNN-notes.md`。
5. **要回报什么**(存成 `reports/sNN.md`,一屏):你怎么演每个气口、用了什么(工具、素材、手法),一个气口一行,写上选中的点子和试过又放弃的;第一批粗略静帧一有就给(不要等批准),再加最后的静帧带子;素材的来源、授权、路径;声音时刻(哪个字、什么事件);最弱的几处(`weakest_points`),如实说;你需要主 Agent 做什么;你的分支和最后一次提交。

任务卡里绝不放别的分镜的画面,不放一串形式或手法的清单,也不放「每个分镜淡入淡出、字幕放在底部、镜头之间都加缓动」。

## 做分镜的人怎么找呈现点子(写进任务卡的「办法」)

对每个气口,或你合并起来的几个气口:

1. **问这句话到底在讲什么**——不是字面,而是事:一样东西由什么组成、一件事怎么发生、什么变了、两样东西怎么不同、有多大或多小、一个抽象论断、一个需要证据的事实、一团乱怎么理出顺序。
2. **问到这个气口结束时观众该感受到什么、看到什么**:整体还是细节?一个对比,还是一个会记住的画面?松了口气、意外,还是「原来如此」?
3. **试几个真正不同的点子**(`ideas_per_beat`),每个一张粗略静帧,加一句话说观众看到什么、感受到什么。不同,指换比喻、换素材、换视角或换尺度,不是换颜色。第一个点子通常最平庸。
4. **挑那个在「展示」而不是在「装饰」的**:观众能不能凭这幅画把这个意思复述出来?用一句话写明理由,把另外几个留在报告里。真实的例子和真实的界面,常常就是手上最强的点子。
5. **别重复自己**:上一个气口用了某种手法,下一个多半就别用;大小、远近、静动、静态和演出来交替。
6. 卡住时:把旁白里的动词和比喻当真;问现实里谁最会做这件事,借他的做法;换材料、物理规律、视角或尺度;该加的地方反而减。

## 做法

1. 首段不重做。把用户在 Step 04 的意见在它的分支上改好,然后合并。它的画面、代码和报告,不进任何别的任务卡。
2. 每个分镜的工作区,从冻结的共用层建,不从主干建;做分镜的人只在自己的分镜文件夹里工作,共用层只读;共用层的问题交给主 Agent,由它统一修一次。
3. 写好每张任务卡,按允许的数量同时放出子 Agent;多出来的分镜分批做。第一个放出去之前,向用户确认模型和努力程度(推荐:分镜子 Agent Medium 起,难的分镜 High,你自己 High 起)。没有子 Agent:每个分镜开一个新对话,依次做;一部能在一次对话里装下的片子,就在一次对话里做。
4. 做分镜的人一个气口一个气口地做,尽早交第一批粗略静帧;主 Agent 扫一眼质量,把纠正写进 `briefs/sNN-notes.md`,不要写进一个正在跑的对话里。
5. **收的时候看质量。** 自己用当前提交重新生成静帧条带,对照质量标杆和入场、出场帧检查。报告和画面对不上时,以画面为准。明显低于标杆才退回;来回两轮之后,换思路。
6. **比报告,不比分镜。** 把各份「怎么演」的几行并排读。如果多数气口用了同一种手法、同一种版式或同一个工具,写进给精修的备忘,或者给最弱的那个退回去并附一句话;不要往任务卡里加规矩。
7. 通过的:素材登记进 `plan/materials.md`,合并分支,记下提交号。

## 过关线

- 每张任务卡都有目的、旁白片段、一张短的世界规则清单、可选的参考,以及要回报什么;没有一张带着别的分镜的画面或一串形式。
- 同时在做的子 Agent 数量,从没超过工具允许的数量。
- 每份报告都写明每个气口怎么演、用了什么;主 Agent 并排读过。
- 每个新素材都有来源、授权、路径和所属分镜;花钱的东西先问过。
- 入场和出场帧符合约定;每个分镜最多渲染一次;分支都已合并。

## 交接

`handoff/05-delegate.md`:每个分镜一行(时间、一句话说画面、状态:在做 / 通过 / 退回、一张静帧),最弱的几处、分支和提交号,以及你注意到的雷同。下一步:Step 06。
# Step 06:初版

> 本页是参考做法,不是规程:可以调序、合并、替换、发明;只有 `SKILL.md` 里的硬规则管着你。「过关线」是自检参考,其中与硬规则重合的几条必须守。

> **谁做**:主 Agent;一个没参与制作的看片人;然后是用户
> **输入**:所有合并好的分镜、锁定的声音、声音标准、`plan/materials.md`
> **产出**:`plan/sound.md`、按审看分辨率渲染的初版、`review/first-cut.md`、`handoff/06-first-cut.md`

## 目标

把分镜拼成一个粗剪,声画对齐:修接缝,对齐接缝两边的色彩,混好声音(人声、音效、音乐),把整片渲染出来。初版是骨架,不是成片。然后让人看。好不好是一种感觉,不打分:一个没参与制作的看片人从头看到尾,用句子说出感受;你自己看一遍;用户看。主 Agent 沿用原来的努力程度,不必为这一步另开更高档的会话;换一个全新的空白会话来精修,留给 Step 07。

## 做法

1. **渲染之前先看接缝。** 每个接缝,导出两边的几帧;检查前一个分镜的最后一帧是不是后一个的第一帧、出镜人位置对不对、有没有东西飘着。第一帧和最后一帧上的小问题现在就修。分镜之间的雷同留到 Step 07。
2. **声音**,按顺序,每一项有了结果再做下一项:底子(人声响度、间隙)、音效、音乐、混音与母带。音效先用真实录音,和画面上的材质对上;生成的声音是可选的,花钱先问。要克制:讲解时很少放,音乐只在开头、揭示、章节切换和结尾,人说话时压低。母带按开题定的目标(`loudness`);加限幅器、再测一遍常常有用。音效峰值用 dBFS 比,人声和音乐用 LUFS 比,不要混着比。声音靠测量和用耳朵听来判断,不靠模型的描述。
3. 对齐接缝两边的色彩和亮度,再按审看分辨率渲染整片。不做低分辨率草稿:小字和细线只有在真实尺寸下才看得出来。
4. **跑硬伤检查,并看每一个被标出的时间点。** 自己写一个检查脚本(用 ffprobe / ffmpeg),报告:画幅、帧率、时长是否与开题一致;整体响度和真峰值(ebur128);黑屏、冻帧、静音段(阈值见 `hardflaw_thresholds`);单帧闪烁(相邻帧场景分突变);视频和音频是否等长;字幕没有烧进画面(抽样帧 OCR 或查工程源码里没有字幕层)。代码只列出可疑的时间,由人去看;它只判断片子是否**正确**,从不判断好不好。
5. **换一双眼睛**,按优先顺序:能看视频的第二个模型(原生支持视频输入、会抽帧细看的最合适,例如 Gemini 这一类),给它整个文件;一个全新的子 Agent(手上没有第二个模型,就新建一个子 Agent 来描述感受;模型能看视频就给视频,不能就给一秒一帧的画面加文字稿);一个全新的对话。永远不是做这片的那个会话。把下面这段填好贴给它:

   ```text
   你是一位观众,不是剪辑师。像一个点进来的人那样,把这部片从头到尾看一遍:{{文件或画面}}。它承诺:{{承诺}}。它是给这些人看的:{{观众}}。
   用平实的句子回答,带时间码(m:ss):哪里被抓住了;哪里走神了;哪里没看懂;哪里被拽出来了;哪里显得廉价或像幻灯片;哪几处看起来或动起来一样;你会不会继续看下去,为什么。
   不要分数、评级、表格。只说你看到的;拿不准是不是故障,就说拿不准。最后一句写「够好了」,或者「改这几处,因为……」。
   ```

6. 任何被报告的跳帧或卡顿,先在静帧上或用测量复现,再去改:模型看视频是抽帧的,可能看到并不存在的跳变,缓慢的平移又可能完全看不出来。
7. 自己把初版完整看一遍,中间不暂停,写下你的感受。有些问题只有在这个尺度上才看得见:对不上的接缝、每个分镜都用同一种演法。
8. 写 `review/first-cut.md`(看片笔记):结论一句话(「够好了」,或「改这几处,因为……」);感觉是什么样的(哪里被抓住、走神、没看懂、被拽出来、觉得廉价,写成句子);看片人的笔记原文;先做什么(要重做的几处、先修的、多半在共用层的、需要用户的);用户的要求还有哪些没满足;细节表:每个气口怎么演的(分镜的人填)、接缝、更好的点子、问题(时间、分镜、种类、严重度、看到什么、怎么确认的、是否出在共用层)、硬伤检查结果。这是给精修的输入,不是完整清单。
9. **关口:用户看初版。** 记下他们的原话和时间;那是 Step 07 最重要的输入。

## 看什么:十二件事(拿判断力去对照,不是检查表)

唯一的尺子:**观众看完,会不会相信这里面下了功夫、想继续看、而且看懂了?**

1. 承诺与钩子:一上来就讲主题,第一幅画面兑现封面的承诺。
2. 结构与留存:每一部分都往前走,讲完就停;中段不平淡。
3. 清晰:字一念出来画面就到;关掉声音,看得出结构吗?
4. 比喻与实证:抽象的意思有具体画面;声音说「它能跑」,画面就展示它在跑;讲工具就多用真实界面。
5. 镜头与变化:每个镜头有任务,相邻镜头在景别、主体或方向上不同。
6. 构图与背景:每一刻一个清楚的主角;停稳的东西是方正的。
7. 出镜人与画框:和片子共用光和色;状态切换有理由;没有抠像毛边、跳切重影。
8. 字与屏幕上的文字:手机上读得清,停留够读完,承载关键词而不是旁白。
9. 颜色、光与统一:像出自一个人的手,强调色意味着「这里要紧」。
10. 运动、转场与节奏:运动有分量、起止自然;节奏有起伏。
11. 声音:人声贴耳,有人说话时音乐退后,音效与材质对得上。
12. 可信与精细:没有任何东西把你拽出来;字幕里没有错别字。

**毛病藏在哪里**:停稳的画面会骗人。最仔细地看入场和出场的中途、剪辑点两边的帧,以及并行做出来的分镜之间的接缝。按种类记录缺陷,才能找到同一种的其余几处:叠压、歪斜、裁切(字被边缘截断)、空(大块区域很长时间什么都没有)、跳变、文字(太小、缺字、字体没加载)、声音、雷同。

## 过关线

- 每个接缝两边都检查过;响度和真峰值达到目标;音乐会在人声下压低。
- 初版以正确的分辨率、帧率和时长从头播到尾。
- 一个没参与制作的看片人完整看过,写下了感受,没有分数。
- 用户的原话已记录。

## 交接

`handoff/06-first-cut.md`:接缝(哪个接缝、看到什么、做了什么)、声音(时间、标记什么、响度)、已知问题(时间码、问题、严重度)、整体响度和真峰值,以及谁看过。用户不看的话,就从看片人的笔记接着做,说明原因,并在 Step 07 签字之前再停一次。下一步:Step 07,在一个全新的会话里、用更高的努力程度。
# Step 07:精修与交付

> 本页是参考做法,不是规程:可以调序、合并、替换、发明;只有 `SKILL.md` 里的硬规则管着你。「过关线」是自检参考,其中与硬规则重合的几条必须守。

> **谁做**:一个全新的、较高努力程度的会话(精修),然后是主 Agent(第二遍、交付)
> **输入**:初版和工程;用户对初版的话;`review/first-cut.md`;各分镜的报告;包装、字幕、字词时间;素材清单
> **产出**:`briefs/polish.md`、`review/polish-report.md`、最终版、`review/second-pass.md`、母版、字幕、章节、封面、`deliver/notes.md`、`handoff/07-polish-and-deliver.md`

## 目标

把初版里还剩的小毛病(转场里的 bug、连贯上的疏漏)清掉,然后交付。把整部片交给一个全新的、上下文空白、努力程度调高了的会话。长片装不进一个上下文还保持成片水准;但初版立住之后,片子在磁盘上,风格已定,一个全新的上下文就能把全部注意力放在一件事上:把整部片看一遍,找出跨全片重复出现的问题。它是冷着进来的,不偏袒任何东西:好的留着不动,共用的问题统一修一次,演得雷同的一段把它抬起来。

## 做法

1. **把用户的话写成任务卡**(`briefs/polish.md`)。每条意见先放进去,用他们的原话,配四行:他们看到了什么、底下想要什么、适用于哪里、「改好了」是什么样。类似的地方一起改。任务卡其余部分写目的、现状、`review/first-cut.md`、各分镜的报告和工具。不规定先看什么,也不规定怎么改。
2. **开一个全新的会话**,在片子的文件夹里,先把努力程度调高(推荐 High;Claude Code 里是 `/effort high`),再把任务卡交给它。不要为了省事开一个最高档会话把整部片从头跑到底:上下文会塞满、被压缩。努力程度只有用户能调:问,等他点头。
3. 一个会话从头到尾看整部片;不要把精修又拆回分镜。好的留着:动一个好镜头就是退步。反复出现的问题,在共用层统一修一次。
4. **雷同现在是缺陷。** 连着几个分镜都是同一类画面或同一种节奏,或者一个构图停得太久:改演法,整段改也行。
5. 全片通用的修法,作为起点:放进容器的东西要完全落在里面;停稳的东西是方正的;字不被截断;动得太快的,提前开始,不压缩时长;用叠接代替空拍。一个动作的起点换了,它的声音也跟着挪。
6. 先静帧:对比修改前后;收敛了,再把整片渲染一次。花钱的生成,照样先停下来问。每处修改拍一张改前改后的静帧;留着不改的,写下理由。
7. **第二遍。** 主 Agent 用静帧检查修过的画面和接缝,然后把整部片再看一遍,找退步。新版不一定更好:某一段变差了,就在不知道哪个是哪个的情况下,逐段对比两个版本,留下更好的。剩下的问题交回同一个精修会话,或者开一个新的,用同一张任务卡。
8. 两遍都干净之后,请用户做**最终签字**。
9. **交付。** 按开题定的规格渲染母版,再跑一遍 Step 06 的硬伤检查:规格、响度与真峰值、黑屏冻帧静音、闪帧、音画等长、无烧录字幕,每个被标出的点要么是有意的,要么已经修了。
10. **字幕**就是 Step 03 做完的那份:导出平台要的格式(SRT / VTT),抽查几行,不要重新转写,不要烧进画面。检查没过,就回到 `words.json` 改、重新生成,并重新检查所有挂在改动字词上的东西。**章节**取每个分镜在 `words.json` 里的开始时间,输出成平台要的章节时间戳文本。
11. 写 `deliver/notes.md`:主要的选择;用过的外部素材和模型;生成的内容(以及平台要求声明的部分);每个第三方素材的署名和来源清单;还不够好的地方;你最后一遍的看片笔记。上传、发布、删除由用户决定:先问。

## 过关线

- 每条用户意见都有结果,精修报告写明了怎么理解、怎么改的。
- 精修在一个新会话里、较高的努力程度下进行,把整部片看了一遍,好的没动,查过雷同。
- 第二遍没有发现新的高、中等级问题;改过的问题没有回来。
- 母版以正确规格从头播到尾,硬伤报告是干净的,或者每一条都有解释。
- 字幕和最终音频一致;来源清单覆盖每一个第三方素材。

## 交接

`handoff/07-polish-and-deliver.md`:问题(时间码、问题、怎么改的、第二遍结果)和交付物(路径、规格、检查)。下一步:Step 08。
# Step 08:复盘

> 本页是参考做法,不是规程:可以调序、合并、替换、发明;只有 `SKILL.md` 里的硬规则管着你。「过关线」是自检参考,其中与硬规则重合的几条必须守。

> **谁做**:主 Agent,交付之后马上做(平台能看留存的话,发布之后再做一次)
> **输入**:整个片子的文件夹;Skill 文件夹
> **产出**:`retro/retro.md`、`retro/skill-changes.md`、`handoff/08-retrospective.md`;之后的 `retro/audience.md`

## 目标

把一切存好,写下这个风格的剪辑做得怎么样。每一次和 Agent、和 Skill 的对话,都会教出一点小经验。把这些经验微调进 Skill,同样的问题就不会再回来。微调,不推倒重来:框架不动,只改几行准确的话。

## 做法

1. **全部存好。** 提交片子的文件夹(计划、任务卡、报告、看片笔记、交接页、`app/`、交付物)。没问过就不删任何东西。用户愿意的话,下一部片可以从这份代码和共用零件起步;它的风格仍然要按它自己的主题来选。
2. `retro/retro.md`:这个风格以及它撑得怎么样(托得好的地方、和内容打架的地方);做分镜的人做得最好和最差的地方;时间和额度花在哪;哪些工具坏了或被跳过;用户在每个关口说了什么,背后的道理是什么。然后是经验,每条一句话,带上所在的步骤和证据(一个时间码、一个文件)。一次遇到只是笔记;同样的问题在两部片里出现,才成为规矩。
3. **每条经验给个去处**:写在发生它的那一步的页面上的一行;「默认参数」表里的一个数字;值得留的点子,写进你自己的笔记文件(泛泛地写,不带这部片的内容和颜色);或者对 Skill 本身的一处小改动。
4. `retro/skill-changes.md`:每处改动一块:文件和章节、现在这行、改后这行、为什么。每处都要小。需要新文件、新步骤、新顺序的改动,是留给用户的问题。
5. **请外部的眼睛来看**,当经验指向 Skill 本身,或者每隔几部片。从里面看,Skill 看不到自己的盲点。把 Skill 文件夹和 `retro/retro.md` 交给你手上最强的模型,开一个全新的会话、用它最高的努力程度(这是外部审阅,不是做片的会话,所以不受「推荐配置」限制)。更好的办法是问专业资料:把动画、缓动、电影和导演理论的权威书放进笔记类工具里,从 Skill 自己的框架出发提问(「这一步说 X;专家怎么说?」)。

   ```text
   你是一位资深的、用 AI Agent 以代码做长讲解视频的实践者。请审计这个 Agent Skill:{{Skill 文件夹}}。先读 SKILL.md,再读 steps/。一部真实的片子里发生的事:{{retro/retro.md}}。
   找出我可能看不到的:Skill 在哪里让 Agent 只能猜,在哪里把该放开的锁死了,哪些文件互相矛盾,哪里在打分而不是看片,哪里落后于行业的做法(说出是哪种做法、谁在用;不要编造来源)。
   只做微调:不要改写或重新组织 Skill,也不要提议新文件或新步骤。最多返回 {{N}} 处小而准的修改(N 默认 12),效果最大的排前面,每处写文件和章节、证据(引用那一行)、新文字,以及你有几分把握。
   ```

   每个答案都要自己核对;核对不了的、只会加规矩的,丢掉。
6. 把改动给用户看。改 Skill 由他们决定:只改他们批准的,改在他们自己留的副本上(装好的插件会被下一次更新覆盖)。一部片做到一半时,不改 Skill。
7. **发布之后**(平台能看留存的话):大约 48 小时和 7 天时(默认节奏,按平台的数据延迟调整),打开观众留存、展示次数和点击率,和频道里类似的视频对比。把每一处明显的掉线和回看都对应到时间码、画面和那句话上。曲线只告诉你在哪里,不告诉你为什么:提出一个原因,和下一部片可以测试的一处改动。发布几小时后点击率明显偏低,试备用封面;一次只改一样。全部写进 `retro/audience.md`。

## 过关线

- 片子的文件夹已提交;没问过没删任何东西。
- `retro/retro.md` 写明了这个风格撑得怎么样;每条经验都有步骤、证据,以及去处或「丢弃,因为……」。
- 对 Skill 提出的每一处改动都小而准。

## 交接

`handoff/08-retrospective.md`:每条经验一行(经验、步骤、证据、去处、状态:已改 / 等用户 / 丢弃)。发布之后,每一处掉线或回看一行。这是最后一步;下一部片从 Step 01 重新开始。
基础版(本页,免费):就是这一页,包括八步剪辑 Skill 的完整原文(第四部分「Skill 原文:九个文件」)和全部提示词(开题、定调、委派任务卡、看片、精修、审计)。照着复制粘贴,一步一步手动做,已经能把一部口播长视频从旁白剪到成片。
完整版在翔宇的 AI 编程实操课里的「AI 视频剪辑完整方案」资料包中:可运行的脚本(预检、转写、按分镜表自动填任务卡、检查渲染等)和 Remotion 起步引擎(含接口约定和检查脚本);五套入门风格手册(亮面演示、暗场终端、手绘白板、扁平图解、杂志版面)、一份空白风格模板和研发自己风格的方法;部署运行手册;长文档。想省掉手动拼装的部分,可以去那里看。
加入课程: 国内版(FlowUS)|海外版(Buy Me a Coffee)。已加入的会员:国内版资料包页面|海外版资料包页面。
别让一个会话从头剪到尾。把旁白锁成时钟,定一种风格,把片子切成若干分镜(默认每个约三分钟),每个分镜交给一个全新的子 Agent,用 Remotion 做出来。同时跑几个由并发数决定(默认 5),拼成初版,再开一个全新的 High 会话精修。
不能。这个 Skill 是用代码(Remotion)做讲解视频、渲染出视频文件,不会打开或修改 Premiere、Final Cut、达芬奇的时间线。渲出来的文件可以再放进你的剪辑软件继续处理。
这是两个默认值,不是定律。分镜时长默认约三分钟:实测这个长度上子 Agent 发挥得好。并发数默认 5,主要是工具上的限制:CLI 工具没做并发处理的话,十个同时跑会报错;确认自己的工具并发下稳定、额度够,可以调高,额度紧就调低。
可以。全新的对话同样是一张干净的桌子。每个分镜开一个新对话,贴同一份任务卡,一个接一个做。慢一些,但行得通。
推荐用 Claude Opus 5.5,努力程度下限是 Medium。主 Agent(开题到委派)用 High,预算够可以 Max;分镜子 Agent 用 Medium,特别难的分镜用 High;初版之后开一个空白会话,用 High 精修。不要在一个 Max 会话里剪完整部片,实测效果不好,上下文被压缩得厉害。别的 Agent 也有对应的思考或努力程度设置。
不用。Remotion、FFmpeg 都在本地跑,可选的本地 Whisper 也一样,Agent 用你自己的登录。生图、生成视频、配乐都是可选的,自备。
用 Herdr 从空文件夹搭一家 AI 一人公司:建知识库、装 Herdr、四位 AI 员工上岗、新建岗位、第一项任务。五段完整提示词逐段讲透,附手机连回和多台电脑两段补充。
Herdr 是专门为管理一群 AI Agent 而造的第三代会话复用器,支持 21 种 Agent CLI,跨厂商统一管理。本文手把手演示四个核心功能:跨厂商统一管理、五种状态感知、按名字寻址协作、三层架构,以及五个真实应用场景,附 5 分钟上手指南。
PwC 数据显示 20% 的企业捕获了 75% 的 AI 可衡量价值——差距不在模型,在运营纪律和知识基础设施。这篇指南拆解翔宇用 Agent 工作流运营整个一人公司的完整方法论。
Claude Code 跑了 20 分钟你不在电脑前,怎么知道它完成了?三种方案对比:Hooks 轻量脚本、Channels 官方双向、Hermes MCP 反向桥接。本文给完整配置代码,复制即用。
每周精选 AI 编程与自动化实战内容,直达你的邮箱