OpenAI Codex 提示词怎么写?模糊需求转工程任务的新手完整指南
用 OpenAI Codex 写代码,结果总跑偏?问题多半不在 Codex,而在你给它的提示词太模糊。本文从新手角度讲清「模糊需求」怎么变成「Codex 能执行的工程任务」,附五件套模板、八大反模式、五步救场流程。
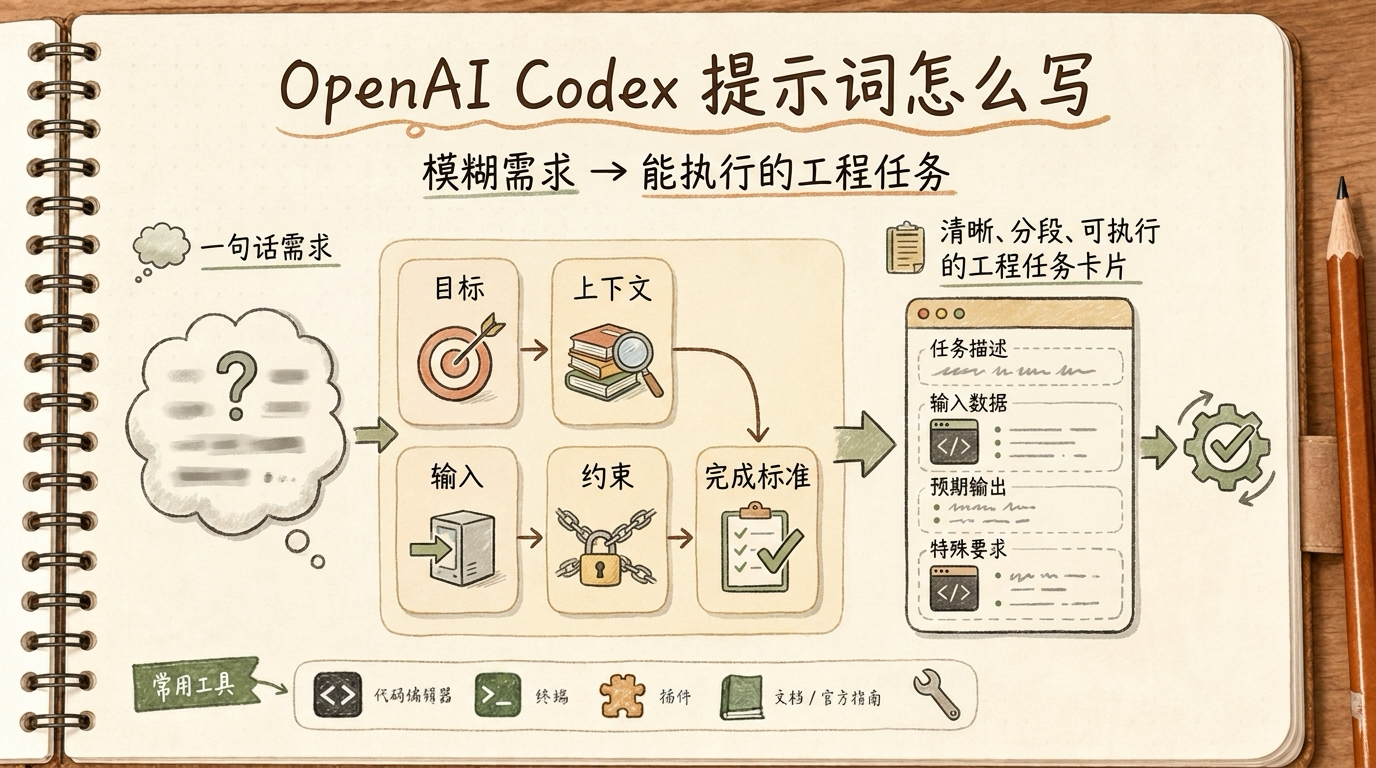
⏱️ 预计阅读 18 分钟 | 🎯 目标:把「我想做 X」这种模糊需求,变成 OpenAI Codex 能直接执行、不会跑偏、可验证的工程任务。
你打开 Codex 输入「帮我加一个登录功能」,它给你写了一段什么都对、但什么都不对的代码——技术栈错、风格错、命名错、和现有代码格格不入。问题不在 Codex,问题在你给它的「这一句话」。本篇讲清楚怎么把这一句话变成五段精准提示词。
30 秒答疑(先看这个)
如果你只想知道「OpenAI Codex 提示词到底该怎么写」,下面这张表就是答案:
| 五件套字段 | 写什么 | 例 |
|---|---|---|
| Goal(目标) | 一句话讲清「干完是什么样」 | 修复用户在 Safari 浏览器登录失败的 bug |
| Context(上下文) | 用 @ 引用相关文件 |
@src/lib/auth.ts @tests/auth.test.ts |
| Inputs(输入) | 数据形状 / 示例 / 类型 | 用户对象 { email: string, password: string } |
| Constraints(约束) | 不能引入新依赖 / 保持签名 / 兼容 X | 不引入新依赖;不改 signIn() 函数签名 |
| Done When(完成标准) | 测试 / 行为 / lint 标准 | pnpm test:auth 全过;Safari 真机能登录 |
新手最常见的错误:把这五件套压缩成一句话「修一下登录的 bug」。结果 Codex 拿不准上下文、猜不到约束、不知道什么算「干完了」,跑出来的代码大概率不是你想要的。
下面把这五件套展开讲清楚。
对号入座:你是哪类新手,先看哪一段
提示词写不好有四种典型卡点,先找到你属于哪一类,直接跳到对你最有用的那段,省得从头啃到尾。
| 你的处境 | 你最该解决的问题 | 先看本文哪一段 |
|---|---|---|
| 完全零基础,第一次用 Codex,给一句话它就乱写 | 不知道一条提示词该写哪几样 | § 三 五件套模板(照着抄五段) |
| 会写一句话,但写完还是经常跑偏 | 不知道自己漏了哪几件、踩了哪些反模式 | § 二 好坏对比 + § 四 八大反模式 |
| 需求自己都没想清楚,不知道怎么描述 | 连「干完是什么样」都说不清 | § 五 Plan 模式 + 反向访谈(让 Codex 反问你) |
| 分不清原型还是上生产,不知道该多严谨 | 不知道什么时候随手写、什么时候写规格 | § 六 氛围编程 vs 规格驱动 |
一张决策图帮你当场对号:
flowchart TD
    A[准备给 Codex 写提示词] --> B{需求自己想清楚了吗?}
    B -->|没想清楚| C[开 Plan 模式 / 反向访谈<br/>让 Codex 先问你 → § 五]
    B -->|想清楚了| D{这段代码要上生产吗?}
    D -->|玩具/原型/学习| E[氛围编程:一句话快速试 → § 六]
    D -->|要上线/多人/有安全要求| F[写五件套规格 → § 三]
    C --> F
    F --> G{跑出来还是不对?}
    G -->|是| H[走 5 步救场流程 → § 七]
    G -->|否| I[审 diff → commit 收工]
💡 通俗讲
这四类不是固定身份,而是「你此刻在哪个卡点」。同一个人今天做原型是第三、四类,明天上生产就成了第一、二类——按当前任务对号,不按「我是谁」对号。
一、Codex 给的结果总不对,问题真的不在 Codex
这一节讲「为什么提示词工程是新手必学」,已经懂的可以跳过看 § 二。
新手第一次用 OpenAI Codex 时几乎都会经历这个挫败:
- 你输入「写一个 API 处理订单」。
- Codex 给你 200 行代码:用了 Express(你项目用的是 Fastify)、数据访问写在控制器里(你项目要走 Repository 模式)、错误处理用 throw(你项目用 Result 类型)。
- 你想骂 Codex「真笨」。
但事实是:Codex 不可能自己读你的心。它能读到的就是你写的那一句话「写一个 API 处理订单」。从这句话里,它没法知道:
| 它不知道的事 | 它会怎么猜(默认) | 你想要的 |
|---|---|---|
| 用什么 Web 框架? | Express(最常见) | Fastify |
| 数据访问怎么写? | 直接在控制器里写 SQL | 走 Repository 模式 |
| 错误处理怎么做? | throw 抛异常 | 返回 Result 类型 |
| 怎么验证输入? | 手写 if 检查 | 用 zod schema |
| 测试要不要写? | 写一个示例 | 必须过现有测试套 |
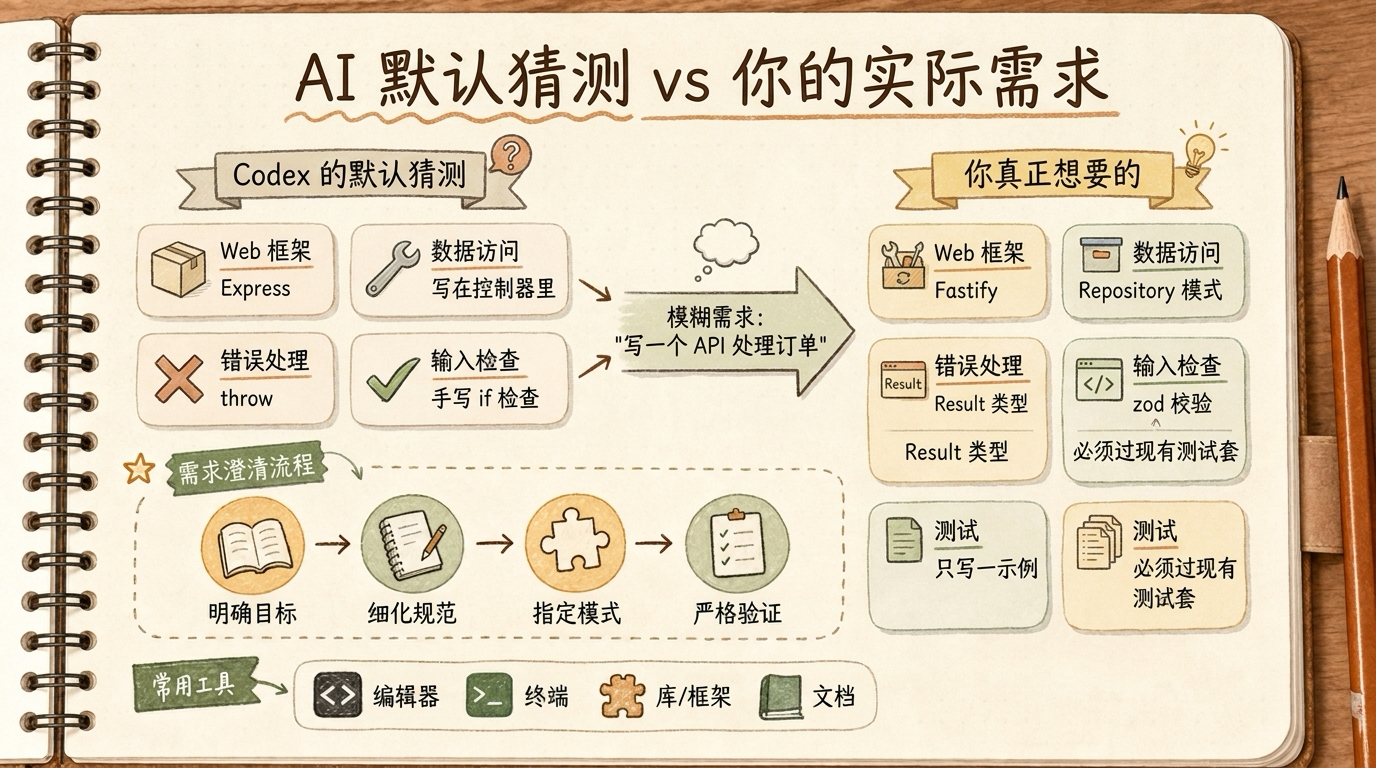
每一项它都按「全网最常见做法」猜,每一项都和你项目实际不一样。
1.1 Andrej Karpathy 那个被忽略的关键判断
Andrej Karpathy 在 2025 年初提出「氛围编程」(vibe coding)概念时,原话有一个被绝大多数人忽略的限定:vibe coding 适合周末玩具项目,不适合生产代码。
Karpathy 的原话核心是「fully give in to the vibes」(彻底交给感觉)——但他明确说这种风格的产物是「throwaway weekend project」(用完即弃的周末项目)。
新手错把「氛围编程」当成 AI 编程的全部——以为 AI 编程就是随手敲一句话让 AI 写代码。一旦项目稍微复杂一点(多文件、生产环境、有团队约定),氛围编程立刻失效。
1.2 工程任务和氛围编程的真正分界线
Red Hat 工程团队总结的 AI 编程四支柱 把分界讲得很清楚:
| 风格 | 适合 | 不适合 |
|---|---|---|
| vibe(氛围) | 探索、原型、试想法、学习 | 生产代码、多人协作、上线前 |
| spec(规格) | 真要上线的代码、有约束的功能 | 早期试错、不知道方向 |
| skill(技能) | 重复多次的工作流(写测试、加 CRUD) | 一次性任务 |
| agent(代理) | 长任务、自主执行、规格清晰 | 短任务、需要逐步引导 |
这篇文章管的是「spec」那一层——把模糊的「我想做 X」变成精准的工程规格,让 Codex 当 agent 去执行。
🔥 翔宇判断
写一个好提示词的成本和收益比:你多花两分钟写清楚 Goal / Context / Inputs / Constraints / Done When,换 Codex 少返工一次——而一次返工往往要重读、重提、重审,远不止两分钟。这两分钟是 AI 编程领域投入回报比最高的事之一。新手把这件事做扎实,比学一堆高级技巧都管用。
二、好提示词 vs 坏提示词:真实前后对比
直接看几组对比,比讲道理直观得多。
2.1 修 bug 类
❌ 坏提示词:
帮我修一下登录的 bug。
✅ 好提示词:
提示词:修复 Safari 登录 bug
# 目标
修复用户在 Safari 17.4+ 上点登录按钮没反应的 bug。
# 上下文
- @src/lib/auth.ts(登录逻辑)
- @src/app/login/page.tsx(登录页面 UI)
- @tests/auth.spec.ts(现有测试)
- 错误现象:点击「登录」无反应,控制台没报错,Network 面板看不到请求发出。
- 只在 Safari 复现,Chrome / Firefox 正常。
# 约束
- 不要改 signIn() 函数签名(其他模块在调)
- 不要引入新依赖
- 不要改 UI(保留现有按钮样式)
# 完成标准
- pnpm test:auth 全过
- 在 Safari 真机点登录能进入主页
- Network 面板能看到 POST /api/login 请求
差距:坏提示词跑出来的代码大概率不能用,好提示词常常一次到位。多花一分钟写清楚,省下一整轮返工。
2.2 加功能类
❌ 坏提示词:
加一个用户头像上传功能。
✅ 好提示词:
提示词:头像上传功能
# 目标
在用户设置页加一个头像上传功能。
# 上下文
- @src/app/settings/page.tsx(设置页)
- @src/lib/r2.ts(已封装的 R2 上传工具)
- @prisma/schema.prisma(User 模型有 avatar_url 字段)
- 站点用 Next.js 14 App Router + Server Actions
# 输入
- 用户上传 JPG/PNG/WebP,≤ 5MB
- 上传后保存到 R2 桶 user-avatars/{user_id}.{ext}
- 数据库存 R2 公开 URL
# 约束
- 必须走 Server Action,不要单独建 API 路由
- 必须先压缩到 ≤ 200KB(用 sharp)
- 必须验证文件类型和大小,超限返回友好错误
# 完成标准
- 上传成功后页面立刻显示新头像
- pnpm test:upload 测试覆盖大小超限、类型错误两种 case
- 数据库 avatar_url 字段更新
2.3 重构类
❌ 坏提示词:
重构这个文件让它更好。
✅ 好提示词:
提示词:重构嵌套 if-else
# 目标
重构 src/lib/order-service.ts,把当前的 6 个嵌套 if-else 改成早返回模式。
# 上下文
- @src/lib/order-service.ts(要重构的文件)
- @src/lib/order-service.test.ts(现有测试,必须全过)
# 约束
- 保持所有函数的对外签名不变
- 不要引入新依赖
- 不要改测试用例
- 用 early return 模式(不要 try-catch 嵌套)
# 完成标准
- pnpm test:order 全过(覆盖率不下降)
- 文件函数嵌套深度 ≤ 2 层
- pnpm lint 无新增警告
注意「重构这个文件让它更好」是一个完全无法验证的目标——「更好」是什么?AI 不知道。改成「嵌套 if-else 改成早返回模式」就是可验证的、可测量的、Codex 能照做的工程任务。
💡 通俗讲
想象你叫一个新实习生「整理一下办公室」。他可能整理了书架你想整理的是抽屉、整理了你的不愿别人动的私人区、把一份重要文件归档到他觉得「合理」的地方但你再也找不到。「整理办公室」是模糊需求,「把抽屉里的笔分类放进笔筒」是工程任务。给 AI 提示词同理——具体到 AI 不需要猜的程度。
三、五件套黄金提示词模板
OpenAI 官方最佳实践 明列提示词必有四件:Goal(目标)、Context(上下文)、Constraints(约束)、Done When(完成标准)。社区在此基础上加了 Inputs(输入),变成五件套,本文跟随这个版本。
3.1 通用模板
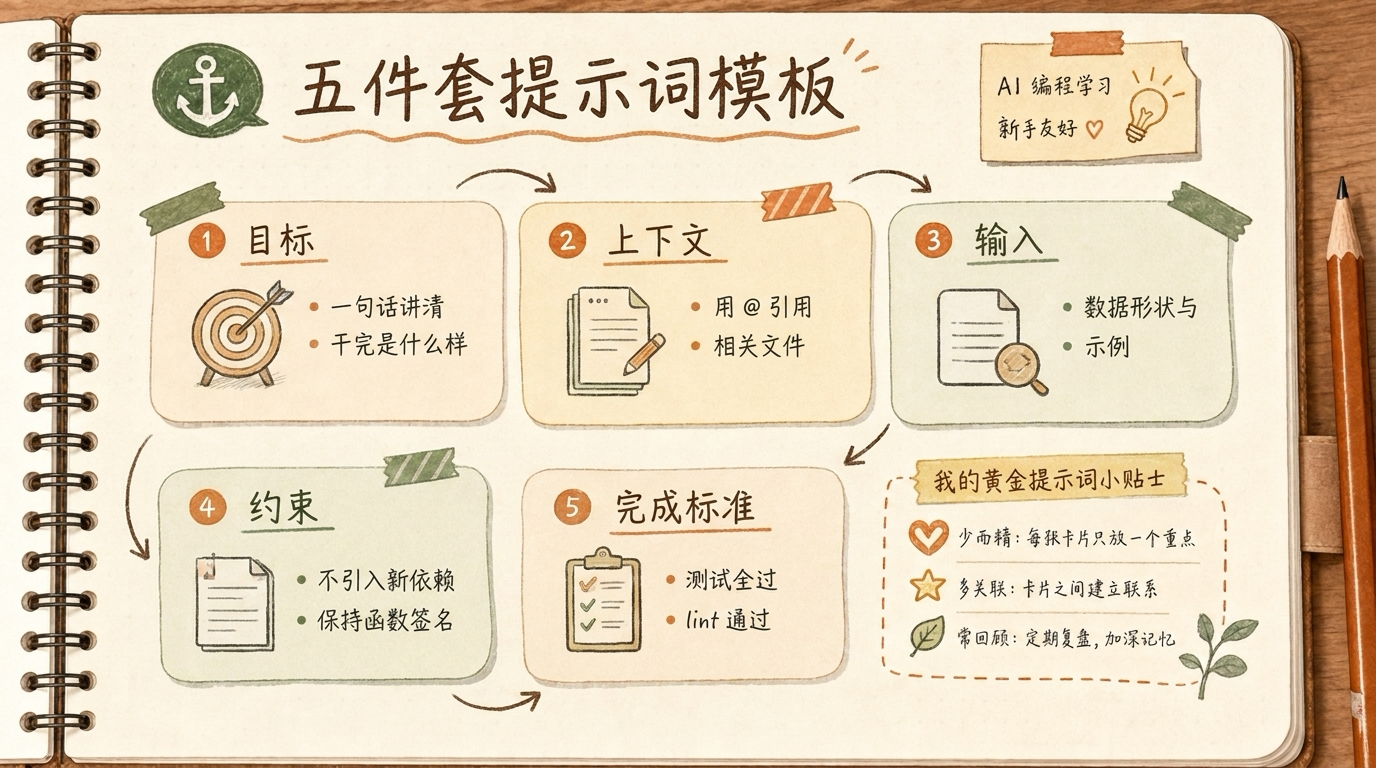
提示词:五件套通用模板
# 目标(Goal)
[一句话讲清「干完是什么样」。具体、可验证、不模糊]# 上下文(Context)
[相关文件用 @ 引用]
[相关错误日志、reproduce 步骤]
[项目背景框架版本(如「Next.js 14 App Router + TypeScript + Prisma」)]# 输入(Inputs)
[数据形状、示例载荷、类型签名]
[输入边界(最大值 / 最小值 / 允许的字符)]# 约束(Constraints)
[不能引入新依赖 / 保持签名 / 必须用 X 库 / 兼容 Y 浏览器]
[必须走 Server Action / 不要建新文件夹]
[必须遵循现有的 X 模式(Repository / CQRS / 状态机等)]# 完成标准(Done When)
[哪些测试要过:pnpm test, pnpm test:e2e]
[哪些 lint 必须 clean:pnpm lint, tsc --noEmit]
[手动验证:在 Safari 真机能登录 / 数据库写入了正确字段]
[反向标准:哪些 bug 不再复现]
3.2 三种典型场景怎么填
上面三组好提示词对比(§ 二)已经覆盖了修 bug、加功能、重构三种典型场景,照着五件套通用模板填空即可。核心差异只在侧重点:修 bug 侧重重现步骤和不引入副作用;加功能侧重输入边界和架构约束;重构侧重保持签名不变和量化度量。
3.3 给 GPT-5.5 的简化版
新一代模型(如 GPT-5.5)已经强到「提示词不完美也能给出不错的结果」——但这不等于可以回到「写一句话」。OpenAI 官方 Prompting 文档给的两条通用建议很实用:一是「把复杂任务拆成更小、更聚焦的步骤」,二是「不确定怎么拆就让 Codex 先提一份计划」。落到提示词上就一句话:省略冗余描述,把重点放在「描述目的」而非「描述路径」。
新手要训练自己分清两件事:
| ❌ 不要细节 | ✅ 要细节 |
|---|---|
| 详细告诉它「先读 A 文件,再扫 B 文件,然后调 C 函数...」 | 「修这个 bug,相关上下文 @A @B」 |
| 详细规定「用 useState 还是 useReducer」 | 「保持现有项目状态管理风格」 |
| 详细指定算法步骤 | 「保持时间复杂度 O(n log n)」 |
告诉它目的,不要告诉它路径。给约束(不能用什么、必须保持什么),不要给步骤(先做什么再做什么)。
四、新手最常踩的 8 个提示词反模式
AI 编程社区高频踩的反模式集中在下面这 8 个(其中「不审 diff 直接合并」由 Simon Willison 的 Agentic Engineering Patterns 专门点名)。新手逐个避开。
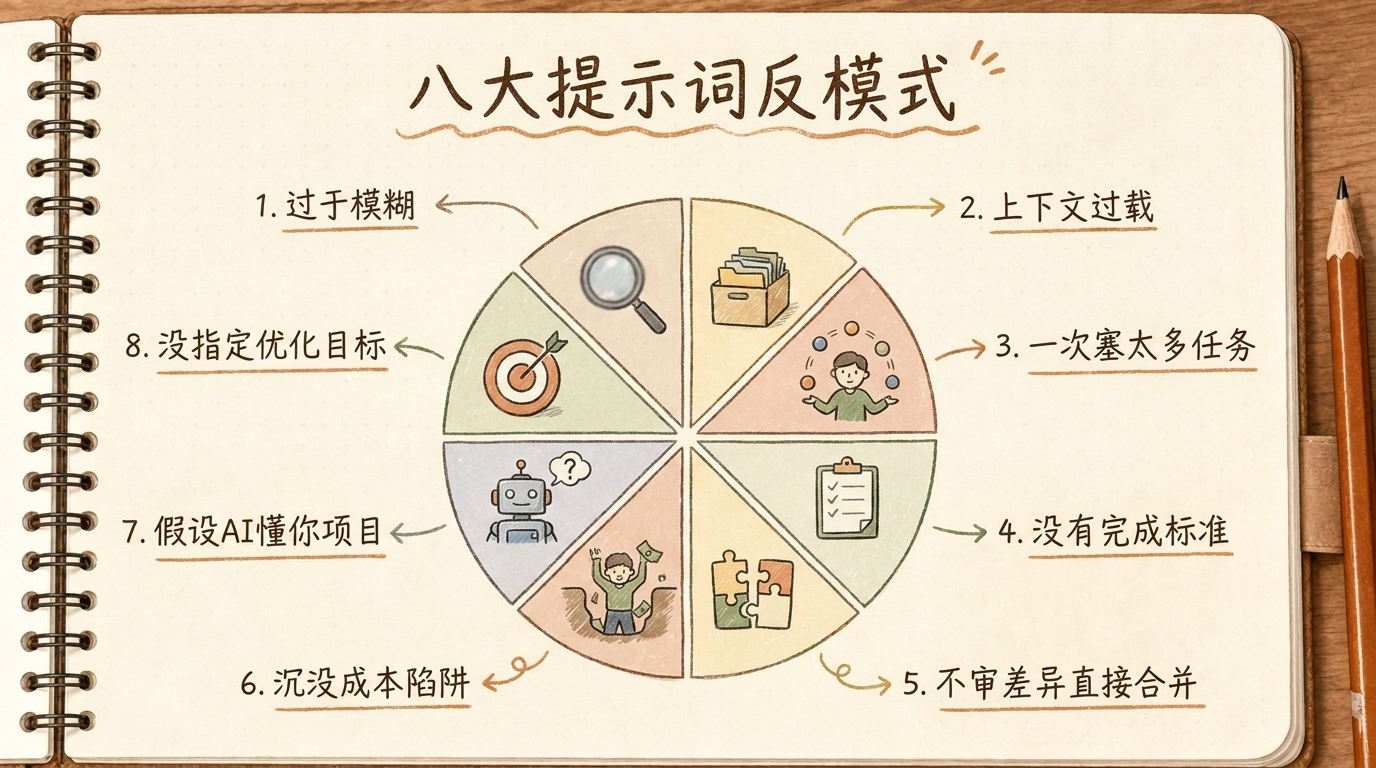
4.1 反模式 1:过于模糊(Vague)
最常见的错。「优化性能」「让代码更好」「修一下」全是这类。
| 模糊 | 工程化 |
|---|---|
| 优化性能 | 把首页 LCP(最大内容绘制)从 4.2s 降到 < 2.5s |
| 让代码更好 | 把这个文件的圈复杂度(cyclomatic complexity)从 18 降到 ≤ 8 |
| 修一下 | 修复 X 步骤后 Y 不出现的 bug |
救法:看到「优化 / 改进 / 让……更好」这种词,停下来问自己「具体的可测量指标是什么」。
4.2 反模式 2:上下文过载(Context Overload)
把半个仓库的代码贴到 prompt 里。AI 会被前面的内容锚定(anchored),把无关上下文当成相关线索。
救法:只 @ 引用真正相关的 1-3 个文件。如果你不确定哪个相关,先开 Plan 模式让 Codex 自己扫描。
4.3 反模式 3:一次塞太多任务(Multi-Tasking)
「修这个 bug 顺便重构一下顺便加点测试」——Codex 会「优化完成请求量」而不是「保持一致性」,结果三件事都做半截。
救法:拆成三条 prompt 串行跑。前一条完成再发下一条,每一条 commit 一次当检查点。
4.4 反模式 4:没有完成标准(No Done Criteria)
不告诉 AI 什么算「干完了」,它自己也不知道——可能跑测试通过就停(可能测试没覆盖你的需求)、可能写完代码就停(可能根本没验证过)。
救法:每个 prompt 末尾必有 # 完成标准,至少包含一个机器可验证条件(测试 / lint / 类型检查)和一个人工可验证条件(具体行为)。
4.5 反模式 5:不审差异直接合并(Don't Review Diffs)
Simon Willison 直言:「Don't file pull requests with code you haven't reviewed yourself」(不要提交你自己没审过的 PR)。
新手最常的错:Codex 写完看跑过测试就 commit 了。但测试覆盖不到的地方它可能引入了你不想要的副作用——格式变了、注释删了、未使用的 import 加了等等。
救法:每次 Codex 改完,强制看一遍 diff,至少扫一眼变更范围是不是符合预期。
4.6 反模式 6:沉没成本陷阱(Sunk Cost Fallacy)
对话跑歪了,你花了 30 分钟试图掰回来。别。
每多掰一轮,AI 越被前面的错误锚定。30 分钟的「掰」往往不如 5 分钟「重新写一份新 prompt 开新对话」。
救法:给自己一个硬规则——同一个对话里来回掰超过 2-3 轮还不行就开新对话。把「为什么跑偏」当作下次 prompt 的输入。
4.7 反模式 7:假设 AI 知道你项目(False Familiarity)
「按现有风格写就行」——AI 不知道你项目的风格是什么,除非你告诉它(在 prompt 里 / 在 AGENTS.md 里 / 在 @ 引用的样例文件里)。
救法:第一周把项目规则写到 AGENTS.md 里。之后所有 prompt 都自动加载这份背景。
4.8 反模式 8:没指定优化目标(No Optimization Target)
「让 X 更快」——更快多少?「让代码更可读」——可读用什么衡量?
救法:所有「优化」类需求都要附量化指标。「LCP < 2.5s」「函数行数 ≤ 50」「测试覆盖率 > 80%」——不能量化的就别让 AI 优化。
🔥 翔宇判断
这 8 条里新手最常栽的是第 6 条「沉没成本陷阱」。在一条对话里和 Codex 来回掰一两个小时是非常普遍的场景——它每次改一点偏一点,人越纠正越起新错。更高效的做法是果断删掉对话、重写一份 4 行精准 prompt,往往 2 分钟搞定。那一两个小时本质是交给沉没成本陷阱的学费。一个值得立下的硬规则:对话超过 3 轮没收敛,立刻开新对话。
五、Plan 模式 + 反向访谈:模糊变清晰的两个杀手锏
如果你写完上面五件套发现自己还是不知道怎么填——比如你压根不知道 Done When 应该是什么——下面两个工具是新手专属救场。
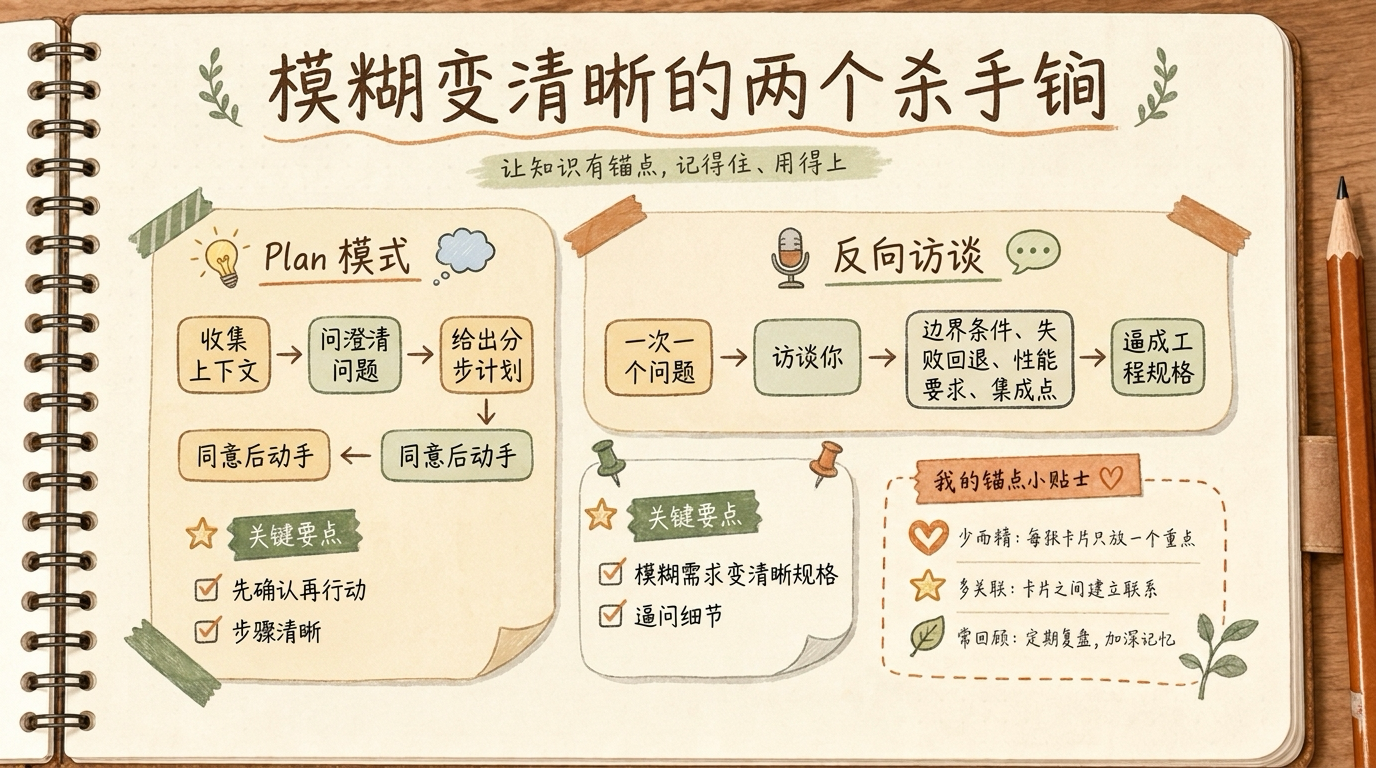
5.1 Plan 模式(Plan Mode):让 Codex 先想再动
OpenAI 官方说明:「Plan mode lets Codex gather context, ask clarifying questions, and build a stronger plan before implementation.」(Plan 模式让 Codex 先收集上下文、问澄清问题、构建更强的计划再实施。)官方对新手的态度也写得很直接:「For most users, this is the easiest and most effective option」(对多数用户来说,这是最简单也最有效的选项)。
操作流程:在 Codex CLI 里敲 /plan 回车(也可直接带上需求,如 /plan 帮我加头像上传),输入你的需求——哪怕模糊也没关系。Codex 不会立刻动手,会先扫描你引用的文件、提出澄清问题、给出一份分步骤计划。你审核计划,点同意它才开始干;不满意可以让它重新规划。
新手前两周强烈建议把 Plan 模式当默认开关——慢一点,但模糊需求被它当场问清,跑偏明显减少。
5.2 反向访谈(Reverse Interview):让 AI 反过来访谈你
当你自己都不确定需求是什么的时候,反过来让 Codex 来问你。具体提示词:
提示词:反向访谈
我想做 [大致目标],但我自己也没完全想清楚细节。
在你写代码之前,请先反过来访谈我:
- 提出 5-7 个最关键的澄清问题
- 包括「假设的边界条件」「失败时的回退」「性能要求」「集成点」
- 一次问一个,等我回答完再问下一个
- 直到你能产出一份精确规格为止
不要写代码,只问问题。
Codex 会接连问你:
- 「这个功能的失败状态应该如何展示给用户?」
- 「上限并发是多少?」
- 「需要支持移动端吗?」
- 「数据保留多久?」
回答完后,你的需求就从「模糊」自动升级成「工程规格」。下一轮 prompt 直接精确执行。
💡 通俗讲
反向访谈类似医生问诊——你说「我不舒服」,医生不会立刻开药,会问「哪里不舒服?多久了?吃过什么?」。这些问题不是医生「不专业」,恰恰是因为它太专业、知道关键变量在哪。让 AI 当问诊医生比让 AI 当算命先生靠谱得多。
5.3 反向访谈的成果直接进 AGENTS.md
反向访谈最妙的副产品:你回答的那些问题,常常是项目里应该写进 AGENTS.md 的规则。
下次反向访谈又问到同样问题,你就知道这条规则该升级到 AGENTS.md 让全局生效,省得每次回答。
六、什么时候用「氛围编程」、什么时候用「规格驱动」
知道两种风格的边界,比哪种都用更重要。
6.1 适合「氛围编程」的场景
| 场景 | 为什么 vibe coding 合适 |
|---|---|
| 周末玩具项目 | 失败成本低,速度优先 |
| 试一个新框架 / 库 | 你自己也没规格,跟着 AI 探索 |
| 学习新概念 | 让 AI 边写边解释,不追求生产质量 |
| 一次性脚本(爬数据、清理文件) | 用完即弃,不需要测试和文档 |
氛围编程的特征:你愿意接受 AI 写的「大概对」的代码,因为代价小。
6.2 适合「规格驱动开发」的场景
| 场景 | 为什么 spec-driven 必须 |
|---|---|
| 上线生产环境的代码 | 一旦错就影响真实用户 |
| 多人协作的项目 | 队友也要 review、维护 |
| 涉及钱、密码、个人信息 | 安全 / 合规要求高 |
| 改核心架构 / 数据模型 | 错了难回滚 |
| 性能 / 安全敏感模块 | 必须有量化标准 |
规格驱动的特征:先写规格、再让 AI 实现、用测试验证。
6.3 实操:先 vibe 后 spec 的混合流
社区主流共识是「先 vibe 后 spec」:
先 vibe 后 spec 两阶段流
阶段 1(vibe):用模糊提示词让 AI 快速试 1-2 个方案 → 看哪个方向能跑通 → 验证可行性。
阶段 2(spec):把方向定下来,写五件套规格 → 让 AI 按规格实现 → 写测试覆盖 → 上线。
这个流既保留了 vibe 的探索效率、又有 spec 的可靠性。
七、提示词失败时怎么救:5 步抢救流程
提示词写完发现 Codex 还是跑偏。下面这个流程是按代价从低到高排的救场顺序。
步骤 1:让 Codex 复述任务(30 秒)
等等,在你继续之前——请用你自己的话告诉我,你理解的任务是什么?
列出我希望你做的事、不希望你做的事、以及完成标准。
绝大多数情况下,复述出来的内容会让你立刻发现哪里被误解了。补充修正后继续。
步骤 2:检查 @ 引用是否正确(1 分钟)
打开你引用的文件,自己看一眼——是不是真的相关?是不是太大了塞满了上下文窗口?多余的删掉,缺的补上。
步骤 3:把硬约束移到 AGENTS.md(5 分钟)
如果你发现自己在 prompt 里反复写「不要引入新依赖」「不要改 src/generated」,这些应该升级到 AGENTS.md 里——每次对话自动加载,比一次性 prompt 优先级稳。
步骤 4:调高推理深度(10 秒)
如果三步都做了还不行,多半是模型推理深度(reasoning effort)不够。在 Codex 里敲 /model 选模型并调推理深度。按 OpenAI 官方配置文档,model_reasoning_effort 的取值是 minimal / low / medium / high / xhigh(其中 xhigh 视模型而定)——复杂任务往上调一档往往就见效。具体可选项以你当前 Codex 版本和官方文档为准。
步骤 5:开新对话重头来(2 分钟)
最后的杀手锏。把上面四步学到的全部塞进新 prompt,开新对话从头开始。
这是新手最不愿意但最该做的一步。沉没成本陷阱让你不愿意承认要重来,但新对话 + 改进 prompt 几乎总比在烂对话里挣扎更快。
八、翔宇的真实提示词工程:作为参考
这一节是资深用户的参考——我自己用了一年 OpenAI Codex 的真实提示词模式,给你做对照,不是让你照抄。
8.1 我每次开新任务的「30 秒固定动作」
无论任务多简单,我有四个动作是固定的:
1. 切到任务相关的 git 分支(不在 main 上跑)
2. git commit 一次当检查点
3. 检查 AGENTS.md 是不是最新
4. 用五件套写第一份 prompt
这 30 秒省了我无数次「Codex 改坏代码我没法回滚」的头痛。
8.2 我的提示词长度规律
| 任务类型 | 提示词长度 | 原因 |
|---|---|---|
| 简单查代码(不改东西) | 1 句话 | 风险低、即时反馈 |
| 单文件改动 | 5-10 行五件套 | 中等风险 |
| 跨文件功能 | 15-30 行五件套 + 子任务清单 | 上下文复杂 |
| 重构 / 架构改 | 50+ 行 + 反向访谈 + Plan 模式 | 错了难回滚 |
信号是「这个任务错了多大代价」——代价越大、提示词越细。
8.3 一个反直觉的经验
⚠️ 常见踩坑
重度使用后最反直觉的一条经验是:
@引用越多,效果越差。在 prompt 里塞 5-6 个@引用、以为「上下文越多 AI 越懂」,结果 Codex 往往拿最大的那个文件当主参考,把真正相关的小文件忽略了。@引用要精确到 1-3 个真正相关的文件,多了反而稀释注意力。(沉没成本那个坑见 § 四反模式 6,这里不再重复。)
8.4 我每周做的提示词复盘(10 分钟)
每周日花 10 分钟翻一遍这周失败的对话——
- 哪个跑偏因为我没写 Constraints?
- 哪个跑偏因为我没写 Done When?
- 哪个跑偏因为我把 5 件事塞一条 prompt 里了?
这些教训直接进 AGENTS.md 或我自己的 ~/.codex/skills/prompt-template.md。积累的不是模板,是对自己思维盲区的认识。
九、4 个 § 四没展开的提示词坑
§ 四讲的是「写 prompt 时」的反模式,这一节补四个「写 prompt 之外」容易忽略的坑。
坑 1:把第一个 prompt 当成最终方案
新手期待第一个 prompt 一发就能产出完美代码。不可能。好的提示词是迭代出来的,因为真实需求本身就是边做边清晰的。第一版能产出大方向对、细节待补的结果,就已经是赢。
坑 2:用「礼貌客气」的语气写约束
「最好不要引入新依赖哦」「请尽量不要改 main 分支」。AI 不擅长读懂你的语气,只擅长读懂明确的命令式语言。把「最好不要」改成「禁止」、把「请尽量」改成「必须」。
坑 3:约束写在哪里都行
每次重复在 prompt 里写「保持 TypeScript 严格模式」「不要引入 Lodash」——这些应该一次性写到 AGENTS.md 里,所有对话自动加载。prompt 写一次性约束,AGENTS.md 写持久约束。
坑 4:让 Codex 自己评估「干完了没」
「你觉得做完了吗?」——AI 自我评估极度不可靠,多复杂代码它都会说「完成了」。用客观信号判断:测试过、lint 过、类型检查过、人眼审完 diff。
十、跑了 1-2 周之后的进阶路径
第一份五件套提示词跑两周后会自然产生进阶需求:
| 你跑两周后的感受 | 下一步动作 |
|---|---|
| 「同样的提示词模板我重复写了 10 次」 | 把模板存成 .md 文件、引用进 AGENTS.md |
| 「相同任务想跑批」 | 学技能(Skills),把可复用工作流封装 |
| 「想让 Codex 自动跑测试 / lint」 | 用 AGENTS.md 的「完成标准」段把验证流程沉淀下来 |
| 「我想批量做相似工作」 | 用命令行(CLI)的 codex exec 写循环脚本 |
| 「需求复杂到一份 prompt 写不完」 | 用 PLANS.md 模式拆多步骤计划 |
| 「团队多人提示词风格不一」 | 项目根放一份 prompt-conventions.md 引用进 AGENTS.md |
| 「想让 Codex 在 PR 里自动 review」 | 配 Cloud + GitHub Code Review 集成 |
十一、提示词自检清单
发出 prompt 之前对自己问一遍:
- [ ] 我写了 Goal(一句话)吗?
- [ ] 我用
@引用了相关文件(1-3 个)吗? - [ ] 我写了 Constraints(不准做什么)吗?
- [ ] 我写了 Done When(怎么算干完)吗?
- [ ] 我把这件事和别的任务分开了吗?
- [ ] 这个任务复杂吗?要不要先开 Plan 模式?
- [ ] 任务大到我都没想清楚?要不要先反向访谈?
- [ ] 我的 git 状态干净吗?等下要不要回滚?
任何一题答「没」都回去看对应章节。
常见问题(FAQ)
下面是正文没展开的几个边角问题。模板、反模式、Plan 模式、反向访谈、vibe vs spec 这些主线问题,正文 § 三到 § 七已经讲透,这里不重复。
Codex 的提示词写法,在 Claude Code、Cursor 这些工具上通用吗?
通用。五件套(Goal / Context / Inputs / Constraints / Done When)讲的是「怎么把模糊需求说清楚」,和具体工具无关——换到 Claude Code、Cursor、其他 Agent CLI 一样适用。区别只在细节语法:引用文件的符号、持久约束文件叫 AGENTS.md 还是别的名、Plan 模式怎么进,各家略有不同,照官方文档对一下即可。
提示词该用中文写还是英文写?
中英文都可以,模型对两者都理解得很好。关键不在语言而在结构——一句中文模糊需求和一句英文模糊需求一样会跑偏。建议用你最能把约束和完成标准写清楚的语言,通常就是母语。代码标识符、文件路径、库名保持原文,不要翻译。
约束到底写在 prompt 里还是 AGENTS.md 里?
一次性约束写 prompt(「这次不要动 UI」),持久约束写 AGENTS.md(「项目一律 TypeScript 严格模式」「不引入 Lodash」)。判断标准:这条约束下次还要重复写吗?要,就升级到 AGENTS.md,它每次对话自动加载,比一次性 prompt 更稳。
怎么避免 Codex 写完测试又给自己打分?
用「先写测试再实现」的反向流程:先写一组失败的测试、确认全跑不过,commit 当检查点,再让 Codex 实现到测试全过、并明确告诉它「不要改测试本身」,最后你自己跑一遍。测试是确定性的,过就是过,AI 没有自我评估的空间。改重要业务代码时尤其值得这么做。
调高推理深度真的有用吗?什么时候调?
前面三步(复述任务、清理 @ 引用、把约束移进 AGENTS.md)都做了还不行,再考虑往上调一档推理深度。按 OpenAI 官方文档,model_reasoning_effort 取值是 minimal / low / medium / high / xhigh,复杂的多步任务调高一档常有改善;简单任务调高只是更慢,没必要。具体可选项以官方当前文档为准。
一句话收官
OpenAI Codex 跑偏,问题大多不在 Codex,在你给它的提示词太模糊。
把「我想做 X」变成五件套(Goal / Context / Inputs / Constraints / Done When),多花两分钟换跑偏大幅下降。复杂任务先开 Plan 模式、模糊任务先反向访谈、跑偏超过 3 轮立刻重开。
至于翔宇我每周 10 分钟的提示词复盘——那是我作为重度用户的稳态做法,给你做参考,不是让你照抄。
- Claude Code 提示词工程指南 —— 同类工具的对应专题,对照看更完整。
相关阅读
- OpenAI Codex 完整学习指南 —— Codex 所有知识点的中枢页,看清学习顺序。
- OpenAI Codex 四个入口怎么选?CLI、App、IDE、Cloud 新手对比指南 —— 不同入口下提示词的输入方式略有差别。
- AGENTS.md 怎么写?OpenAI Codex 智能体指令文件新手完整指南 —— 把持久约束写到 AGENTS.md 里,提示词只写一次性约束。
- 换台电脑 Claude Code 全没了?我的多机同步方案 —— 多机使用时如何同步提示词模板。
外部参考(按本文引用顺序):
- OpenAI Codex Best Practices 最佳实践 —— 提示词五件套结构的官方来源。
- OpenAI Codex Prompting 指南 —— Codex 提示词官方文档。
- OpenAI 通用 Prompt 指南 —— GPT-5.5 时代提示词风格变化。
- OpenAI GPT-5 Codex Prompting Guide 烹饪书 —— 调试、重构、修 bug 各场景模板。
- Simon Willison: Agentic Engineering Anti-Patterns —— 「不要提交自己没审过的代码」这一反模式的来源。
- Red Hat: AI 编程四支柱 —— vibe / spec / skill / agent 分层框架。
- Microsoft: Structured Vibe Coding —— 结构化提示词的代表性实践。
- Spec-Driven Development 介绍 —— 规格驱动开发概念。
- Cursor: Best Practices for Coding with Agents —— 编辑器视角的提示词工程。
- JetBrains: Coding Guidelines for AI Agents —— IDE 视角的提示词建议。
下一步
- AI 编程实操课:Claude Code + Codex + Agent 工作流,覆盖一人公司、自媒体自动化、AI 副业全场景。237 篇实战教程 + 最佳实践 + 源码包,跟着做就出成果。国内版-FlowUS | 国际版-BMC
- YouTube 频道:翔宇工作流
- 微信公众号:搜索「翔宇工作流」

接着读
Grok Bot 适合做什么:四个测试与真假案例判别
能成的活形状都一样:读点东西、查个系统、应用一条规则、写出结果。四个测试判断值不值得交,五个判据分辨你看到的案例是真是假——声量最大的那一类,真实使用里几乎不存在。