44. 自媒体全自动发布终极方案:AI Agent 接管你的 Chrome,YouTube、B站、X一键发布
自媒体全自动发布卡在最后一步:平台在拦 Agent。用开源插件 Chrome Use 让 AI Agent 接管你已登录的 Chrome,不弹窗、不重新登录,四步装好,一句话把视频传上 YouTube、B站、抖音,帖子发到 X、知乎。
自媒体全自动发布卡在最后一步:平台在拦 Agent。用开源插件 Chrome Use 让 AI Agent 接管你已登录的 Chrome,不弹窗、不重新登录,四步装好,一句话把视频传上 YouTube、B站、抖音,帖子发到 X、知乎。

拆了 208 个公开 AI 视频画布、8362 条提示词,整理出七类提示词的通用框架:每类一个可直接复制的填空模板、一个真实成品和一行统计。
Make 中文教程第二期:先想清楚数据从哪来、怎么加工、存到哪去,再导入一个现成的工作流,逐个模块授权、运行、排查和排期,最后换成 OpenRouter、Gemini、Mistral 模型,换一个选题方向。
第二期把上一期的概念落到一个能跑的工作流上:先想清楚数据从哪来、怎么加工、存到哪去,再导入一个现成的工作流,逐个模块授权、运行、排查和排期,最后把模型换成 OpenRouter、Gemini、Mistral,把选题换成双语阅读。示例是 Make 第 4 期的小红书笔记工作流:Inoreader 拿新闻,Jina Reader 读全文,大模型写成笔记,存进 Notion。
| 步骤 | 用途 | 链接 |
|---|---|---|
| 构思 | 示例工作流的完整搭建过程(Make 第 4 期) | 小红书自动化:批量生成爆款笔记 |
| 构思 | Make 应用集成目录,查有没有对应的模块 | make.com/en/integrations |
| 导入 | 官方帮助:蓝图是什么、怎么导入导出 | Scenario blueprints |
| 数据来源 | Inoreader,把多个 RSS 订阅源汇总到一个文件夹 | inoreader.com |
| 读网页 | Jina Reader,把网页转成纯文本,API Key 在官网 | jina.ai/reader |
| 加工 | OpenAI API 后台,拿 API Key 和 Organization ID | platform.openai.com |
| 保存 | Notion,复制数据库模板、给 Make 授权 | notion.com |
| 换模型 | OpenRouter 模型列表(可按价格筛出免费模型)和 API Key | openrouter.ai/models · Keys |
| 换模型 | Google AI Studio,拿 Gemini API Key | aistudio.google.com/apikey |
| 换模型 | Mistral 控制台,订阅免费方案、拿 API Key | console.mistral.ai |
| 换选题 | 找 RSS 订阅源 | RSS 订阅源推荐榜 |
| 排错 | Notion API 的长度上限 | Request limits |
| 上一期 | 六个基础概念 | Make中文教程:自动化基础 |
这部分解决的问题是:拿到一个需求,怎么把它拆成 Make 里的模块。
先回顾上期最重要的一句话:Make 把程序员才能用的 API 接口封装成了模块,让我们在可视化的画布上用。同样是在 Notion 里新建一个数据库,程序员要注册开发者账号、申请 API Key、读授权文档、装开发环境和依赖、写请求代码、处理报错;在 Make 里是新建场景、加一个 Notion 模块、选新建数据库的动作、点 Add 授权、填好标题和属性、点运行,一行代码都不写。所以每搭一个工作流,其实就是做了一个小应用。
动手前先想清楚任务目标。示例是 Make 第 4 期「小红书自动化」:批量生成适合小红书发布的笔记。目标换成批量写公众号文章、批量做图片、拆书,都是一个道理。目标定了,就回答三个问题:
| 问题 | 示例里的答案 | 对应的模块 |
|---|---|---|
| 数据从哪来 | RSS 订阅源里的新闻网页 | Inoreader(拿新闻列表和链接) |
| 怎么加工 | 读出网页全文,让大模型按小红书的格式写成标题、正文、标签、字数 | HTTP 模块调 Jina Reader;OpenAI 模块写笔记;Parse JSON 拆字段 |
| 存到哪去 | 一个能审核、发布、复用的知识库 | Notion 数据库 |
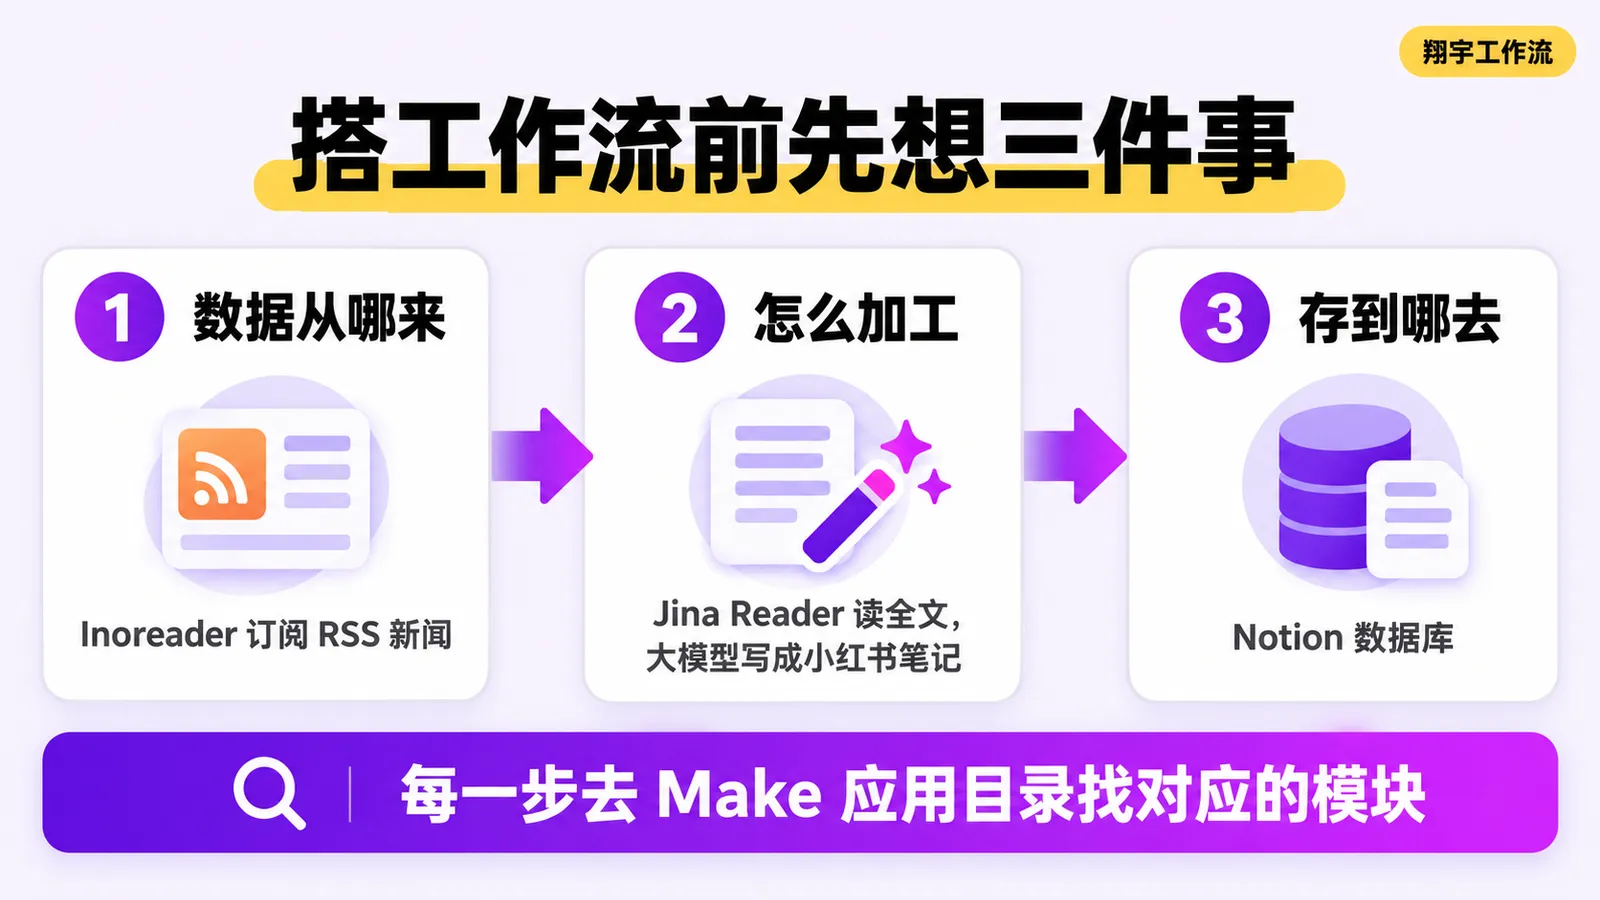
每个问题都去 应用集成目录 搜一下:数据来自 RSS,就搜 RSS,能看到 RSS 模块,还有 Feedly、Inoreader 这些聚合服务;要处理 PDF,就搜 PDF,有 PDF.co、iLovePDF。选的时候顺带看一眼这个服务的 API 有没有免费额度。数据加工可以更复杂,比如把十条新闻汇总成一篇再交给大模型,那是后面各期视频里的进阶做法。
这部分解决的问题是:不从零搭,先把一个现成的工作流跑起来。
Make 的场景可以存成蓝图(Blueprint):一个 JSON 文件,里面有模块、模块设置和映射好的值,别人导入就能直接用或改(官方说明)。视频里用的第 4 期蓝图和 Notion 模板来自翔宇早期的资料包,现在不再单独提供;没有蓝图就照 第 4 期文章 手动搭一遍,下面的导入和授权步骤对任何 Make 蓝图都一样。
导入:
.json 文件,保存。录制时入口在画布底部的「…」(More)→ Import Blueprint;现在 Make 把导入、导出蓝图移到了场景编辑器右上角(官方说明)。导入后模块都摆好了,但每个模块都没有连接,只有建好连接,模块才能读出里面的提示词和设置。逐个打开:
Authorization 换成自己的 Key,格式是 Bearer 开头。Key 在 Jina 官网 API 区域的密钥和计费(API Key & Billing)里;新 Key 带试用额度,长期用要按量付费,以官网为准。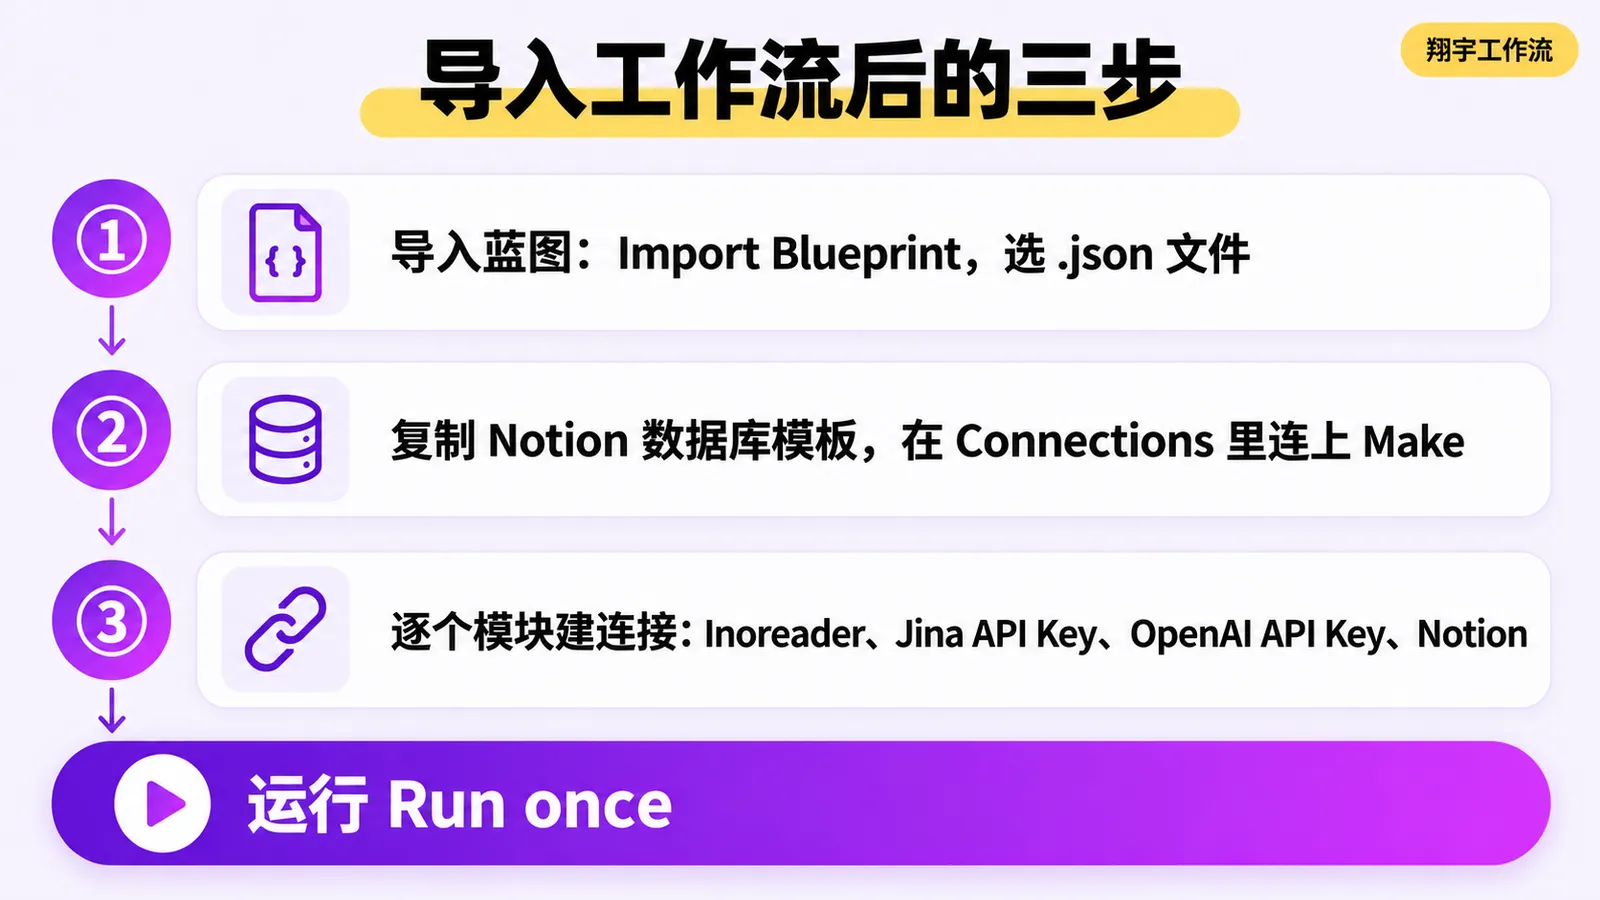
这部分解决的问题是:点了运行没反应,或者跑完结果不对,怎么一步步找原因。
测试时先少取几条:把 Inoreader 模块的数量限制改成 3。原工作流里还有字数范围这类过滤条件,第一次跑可以先删掉,免得数据被筛掉以为是坏了。
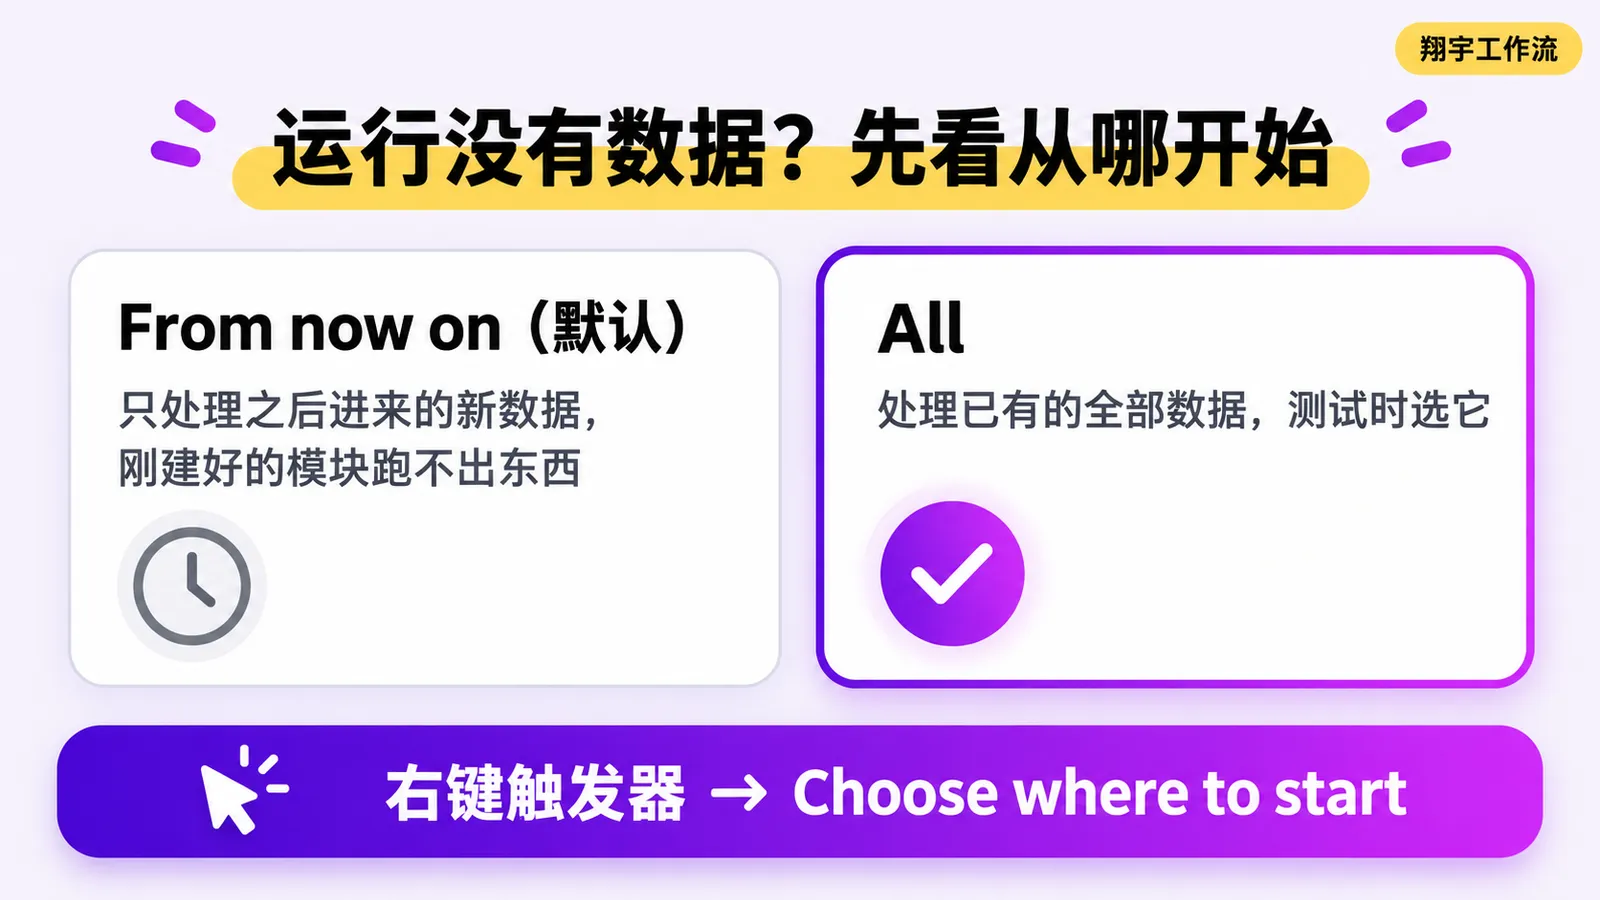
点运行一直转圈、没有数据,多半是触发器从哪开始的问题。RSS、Inoreader 这类触发器默认「From now on」:只处理运行之后才进来的新数据,刚建好的模块当然拿不到东西。停掉运行,右键触发器,选 Choose where to start,改成 All(或者手动挑几条),再运行就有数据了。
跑完了结果不对,从第一个模块往后,点每个模块右上角的数字气泡看输入(Input)和输出(Output):
最后去 Notion 数据库里看,三条笔记都在,这个工作流就跑通了。熟悉之后,导入一个工作流几分钟就能搞定。
要注意每个工作流的触发条件不一样:有的是 Webhook,有的是搜索类模块,有的要把 Notion 里某条记录的状态改成「开始」才会跑。导入前先看一遍那期视频,知道它是怎么启动的、每个模块要什么。
设置排期:点画布左下角的时钟图标。默认是每 15 分钟跑一次,可以改成只跑一次、每天某个时间、每周哪几天、每月哪几天、指定日期,或者按需运行。视频里设成每天 14:42(时区是上海,也就是北京时间),点 OK,再把场景打开(Active),之后每天这个时间自动抓一次新闻、生成笔记存进 Notion。
这部分解决的问题是:自己从空白画布搭的时候,数据在模块之间是怎么走的。
手动搭建的步骤是新建场景、添加模块、编排模块、映射数据、测试运行,每一期工作流视频都是按这个顺序一步步来的,照着做就行。效率低一点的原因在于:后面的模块要拿前面的数据,就得先把前面跑一遍,每跑一次都消耗 Make 的额度和大模型的 API 费用。翔宇搭一个工作流通常要改五版左右,光测试就要消耗两三千次操作,这也是先导入现成工作流再改更划算的原因。
看懂数据就看两样:输入和输出。这个工作流是线性的,后面每个模块都能拿到前面所有模块的数据。Inoreader 输出 3 个数据组(Bundle),每组里有时间戳、分类、标题、摘要、链接等一大堆字段;下一个 HTTP 模块其实只用了其中的链接。把光标放进 HTTP 模块需要网址的位置,右边弹出前面模块的数据结构,点一下链接字段,映射就完成了。大模型模块也一样,只映射 HTTP 模块输出里的正文(content),其他数据用不上就不放。
映射时还能顺手加工数据:右侧面板里有文本、时间、数组、数学和通用函数,可以截取前多少个字、删掉表情符号、替换内容,这些也都不用写代码。所以 Make 里其实有两条线:一条是模块的流程,一条是数据的流程。多运行、多点开每个模块的输入输出,这条数据线就看懂了。
这部分解决的问题是:不想用 OpenAI,或者想按任务选模型。
以前翔宇推荐直接用 OpenAI,后来改成按任务选模型:简单任务交给便宜或免费的模型,最核心的内容(比如写爆款文章)交给效果最好的模型。做法是并联一条新分支,不动原来的:
| 模型入口 | 怎么连 | 结构化输出 | 录制时的体会 |
|---|---|---|---|
| OpenRouter(录制时 Make 刚上它的原生模块) | 在 openrouter.ai 充值后到 Keys 新建 Key,粘进 Make | 支持 | 一个 Key 能用海量模型;模型页把价格筛成 Free 能找到免费模型,但高峰时常报 429 或输出不合格;可以打开模块里的 Enable automatic fallback,出错时自动换一个相近的模型;要稳定就选小模型 4o mini,翔宇的提示词就是按它调的 |
| Gemini(谷歌原生模块) | 在 Google AI Studio 生成 API Key | 模块里没有结构化输出选项 | 有免费额度,普通文本处理没问题;输出 JSON 时前后常多出代码块标记,后面的 Parse JSON 会失败 |
| Mistral(原生模块) | 在 Mistral 控制台的账单里订阅免费的 Experiment 方案,再到 API Keys 新建 | 支持,高级设置里回答格式选 JSON | 用 Mistral Large Latest 解析稳定;免费方案有时开放有时报错 |
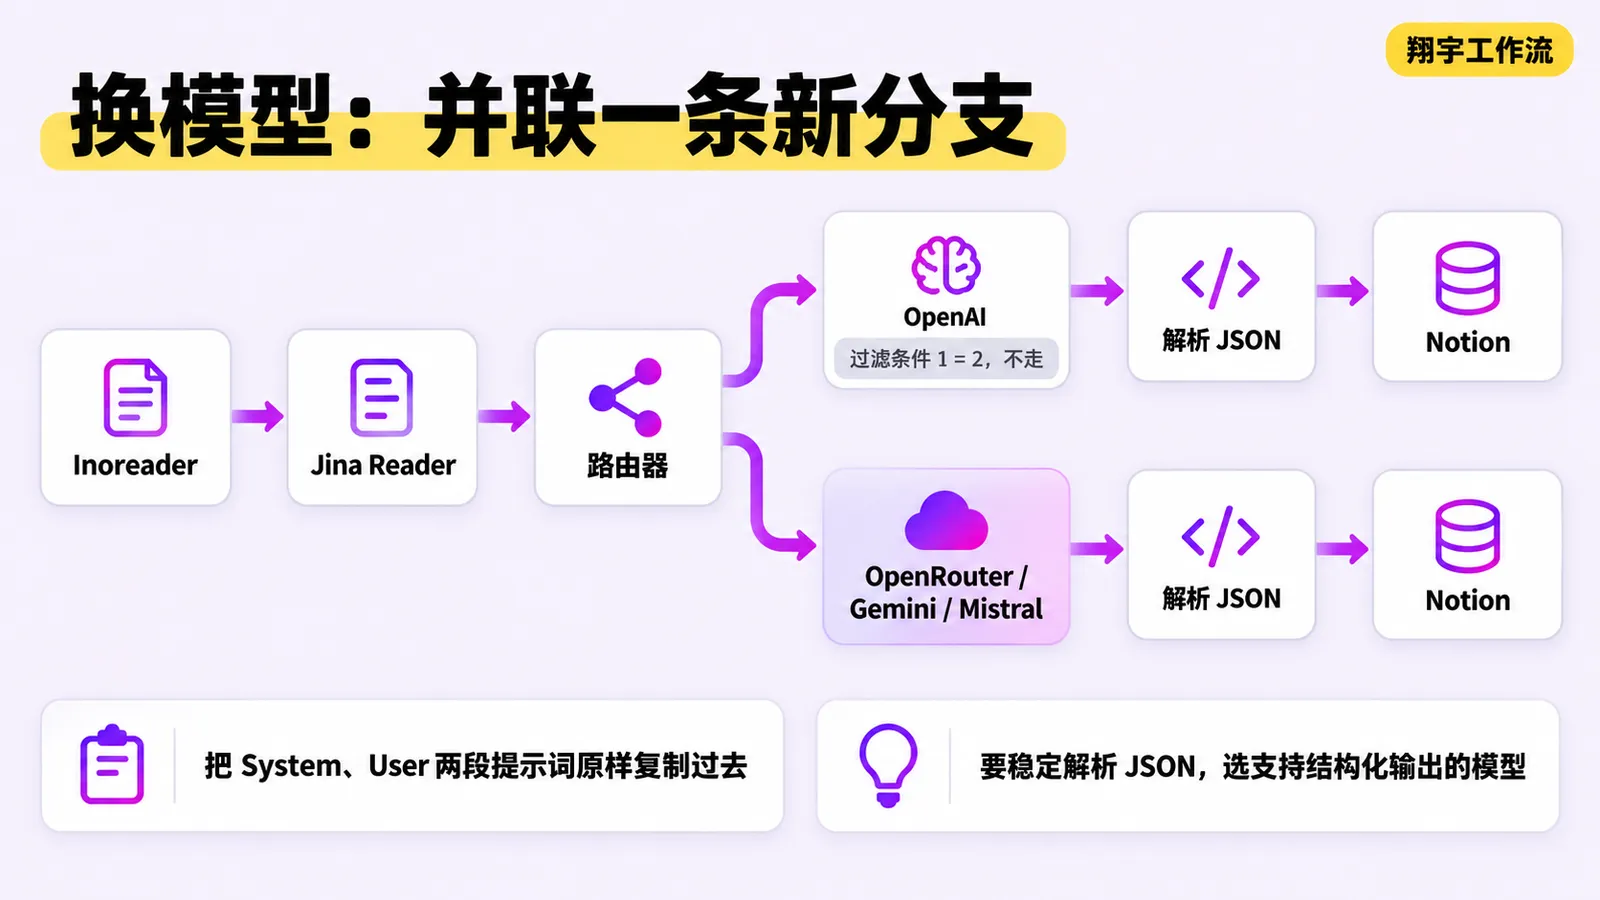
录制时是 2025 年 1 月,视频里的 4o mini、Gemini 2.0、Claude 3.5 Sonnet 现在都已经不是最新的模型了。思路不变:选模型以 OpenRouter 模型页当前的列表为准,要 JSON 的步骤优先选支持结构化输出的。
这部分解决的问题是:同一个工作流,怎么改成生成别的内容。
例子是把「AI 新闻笔记」改成「双语阅读笔记」,只动两处:
再运行,Notion 里就是双语对照的笔记了。只要找到新的数据来源、写好新的提示词,同一个工作流就能产出另一个赛道的内容。
| 报错或现象 | 原因 | 怎么修 |
|---|---|---|
| 运行一直转圈、没有数据 | 触发器默认 From now on,只处理之后的新数据 | 右键触发器 → Choose where to start → All |
| Source is not valid JSON | 模型不支持结构化输出,或在 JSON 前后加了代码块标记等字符 | 换支持结构化输出的模型并打开 JSON 输出;或在提示词约束里加一句「只输出 JSON 数据,不要任何其他字符」;还不行就不解析,把整段结果存进 Notion,标题先用原新闻的英文标题 |
| 免费模型报 429 | 免费模型用的人多,被限流或额度用完 | 换一个模型、打开自动 fallback,或换成付费小模型 |
| Notion 报 Body field validation | 写进文本属性的正文超过了长度上限:Notion API 每段富文本最多 2,000 字符(官方说明) | 映射时用 substring(正文; 0; 1900) 截到 1,900 字以内;或者把正文写进页面内容而不是数据库的文本属性(特别长的正文仍要分段) |
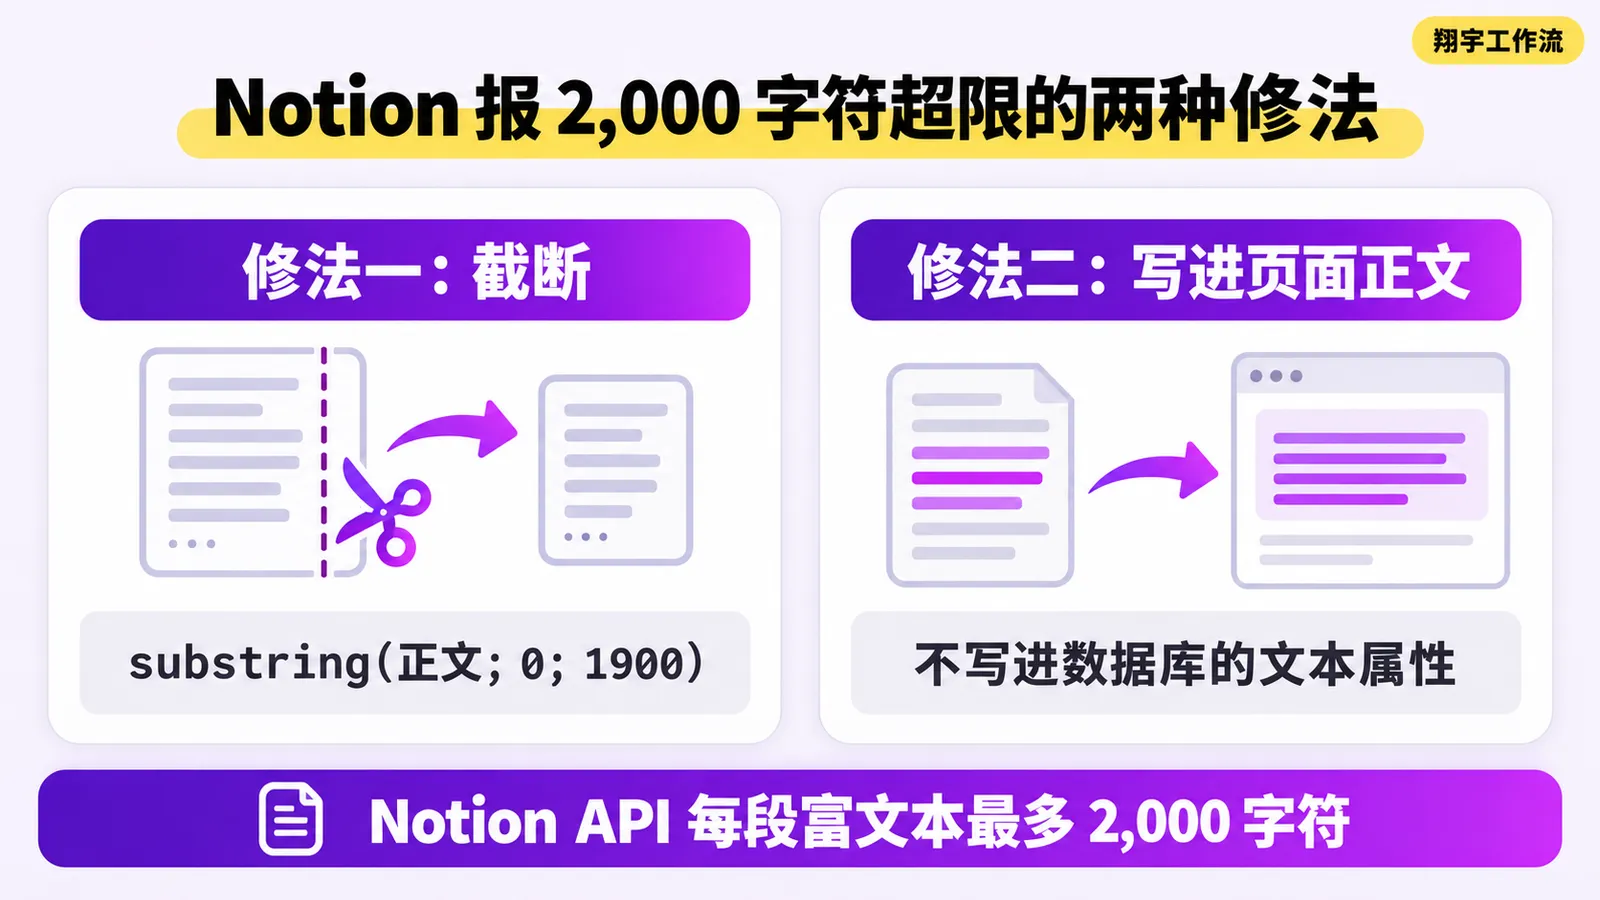
字数超限往往也说明模型没守住提示词里的字数要求。视频里换回 4o mini 再跑,字数就正常了,不再报错。
蓝图是一个场景的 JSON 文件,包含模块、模块设置和映射好的值。导入之后流程和提示词都在,但每个模块的连接要用自己的账号重新建。
多数是触发器默认从「From now on」开始,只处理之后进来的新数据。右键触发器,选 Choose where to start,改成 All 或手动选几条,再运行就有数据了。
模型没有按纯 JSON 输出,常见是前后多了代码块标记。换一个支持结构化输出的模型并打开 JSON 输出;或在提示词里要求只输出 JSON;还不行就跳过解析,把整段结果存进 Notion。
能。用 Make 的 OpenRouter、Gemini 或 Mistral 原生模块替换 OpenAI 模块,把 System 和 User 两段提示词原样复制过去,再重新映射输出。免费模型可以跑通,但不如付费小模型稳定。
写进 Notion 的文本超过了长度上限:Notion API 每段富文本最多 2,000 字符。用 substring 函数截到 1,900 字以内,或者把正文写进页面内容而不是数据库的文本属性。
想系统学用 AI 做事,可以看翔宇的 AI 编程实操课:国内版(FlowUS)。
自媒体全自动发布卡在最后一步:平台在拦 Agent。用开源插件 Chrome Use 让 AI Agent 接管你已登录的 Chrome,不弹窗、不重新登录,四步装好,一句话把视频传上 YouTube、B站、抖音,帖子发到 X、知乎。
拆了 208 个公开 AI 视频画布、8362 条提示词,整理出七类提示词的通用框架:每类一个可直接复制的填空模板、一个真实成品和一行统计。
30 分钟的长视频一个会话剪不完。这篇讲八步剪辑 Skill:锁定旁白和一种风格,长视频切成分镜交给全新的子 Agent 并行制作,初版之后开空白会话精修,并附 Skill 原文和默认参数表。
每周精选 AI 编程与自动化实战内容,直达你的邮箱